HPD:把智能体运行时约束变成训练监督
为什么会调用工具的模型仍会漏做步骤、过早结束?
HPD 将运行时的义务、调度和结束条件编译成训练期控制文档,再把文档与经过验证的动作共同蒸馏进模型。关键不是增加部署提示词,而是让原生历史输入对应可执行的下一步;论文同时表明合规、参考路径和最终完成率必须分开看。
图解主要方法
为什么会调用工具的模型仍会漏做步骤、过早结束?
- 1
1 · 回放真实决策边界
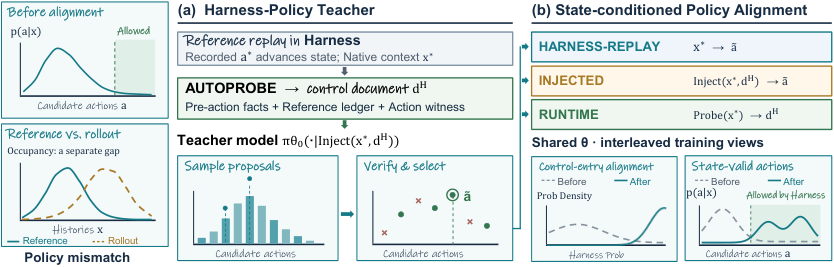
图1左侧用记录动作推进 harness,逐工具消费记录的观察队列。AutoProbe 在下一次模型调用之前读取历史、权限与生命周期。控制文档还含参考轨迹账本及当前动作见证:后两者是训练特权标签,并非仅从部署时状态就能直接读取的事实。
- 2
2 · 生成并严格筛选动作
冻结的基础模型获得原生上下文和控制文档,每次采样两个候选。验证要求控制决策、工具名及完整归一化参数与参考一致,再按其余字段与参考的相似度选一个硬标签。回放继续使用记录动作,因此这不是学生自主探索错误状态的在线训练。
- 3
3 · 三种输入输出共训一个模型
T 用原生历史预测验证动作;I 加控制文档预测同一动作;R 从历史预测控制文档。三种视图交替更新共享参数,按完成序列长度归一化交叉熵。每视图2万批次意味着完整三视图共6万次优化更新,不能把它与T单视图2万次称为相同总算力。
- 4
4 · 部署去掉文档,重新检验闭环
推理仅保留T原生接口,不额外生成控制文档。TS要求义务最终完成、答案F1至少0.5、恰好一次final、正常退出及健康执行器;RC和参考前缀Step-SR测量不同对象。错误恢复后可以TS成功但Exact失败。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-8B LoRA;4703训练、584验证、583测试任务,17599回放边界;8张A800、BF16、batch128。HPD TS22.98%、RC49.23%;Base分别3.09%、19.90%;OPD TS15.61%但RC66.21%。 表1、附录C:主实验条件 ↗
我的解读完成率证据支持运行时监督,但HPD并非合规率第一,也不能把22.98%解释为生产可靠性。工具观察是回放数据,参数评测侧以必需键为标准。
来源证据相同验证教师的HPD-T TS20.58%;加入I/R后22.98%。额外五种子均值分别18.20±1.67与22.14±1.18;设备崩溃中断样例从对应运行剔除。 表2、表5:增益来自哪里 ↗
我的解读验证标签本身贡献很大,三视图的额外收益与训练量、状态监督共同相关;必须披露有效测试样本会变化。
来源证据92个BFCL v4任务、保持Pi运行时且不再训练,HPD TS21.74%、HPD-T与Base均13.04%;HPD-T答案F1反而高于完整HPD。 图7:零样本跨任务,不等于跨运行时 ↗
我的解读可支持同一运行时下新任务迁移。换ReAct、Compiler或OpenCode的结果来自分别重建适配器及训练,不能称即插即用跨harness。
开放情况与使用许可
已打开作者GitHub:存在算法组件和测试,但README明确完整Pi适配、数据准备、分布式训练和端到端评测尚待上传。组件标注research use,未据此认定完整开源。本次模型页未能访问,Hugging Face API返回认证错误,无法确认权重可下载或其许可。
LICENSE论文原图 CC BY 4.0;代码和模型许可分别核对
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把执行义务和终止条件显式监督,比只模仿工具调用格式更贴近多步骤产品故障;完整附录让训练特权来源与计算预算可审计。
反方 · 哪些结论还不够
依赖参考轨迹和harness专用验证器,错误后状态覆盖不足;主任务完成率仍低,回放工具结果不等于真实外部系统。多视图消融并未统一总优化更新。
综合判断
值得作为智能体后训练方法跟踪;证据是特定运行时内的闭环改善,不能推出广泛自主执行能力。
我会先做的验证
未执行的验证方案:在同一总训练token预算下比较T与T/I/R,用真实工具参数值执行、故障注入和恢复任务重新测量完成率、误终止率及用户接管;本栏目未执行。