HT-Policies:生成策略的优势,也可能来自怎样处理训练误差
把MSE换成带输入相关尺度的Student-t回归,单次前向逼近多步采样表现
这项研究重新检查回归与生成机器人策略的差距:大误差样本可能因MSE的梯度权重而主导训练,未必只是动作多模态导致均值失效。HT-Policies用观测相关尺度和Student-t厚尾损失平衡贡献,保留单次前向动作预测。在多种骨干上有竞争力,但不能显式表示多个行动模式,也有明显逐任务回退。
图解主要方法
生成式策略更好,是因为多峰动作,还是因为训练时没有让少数大误差样本主导?
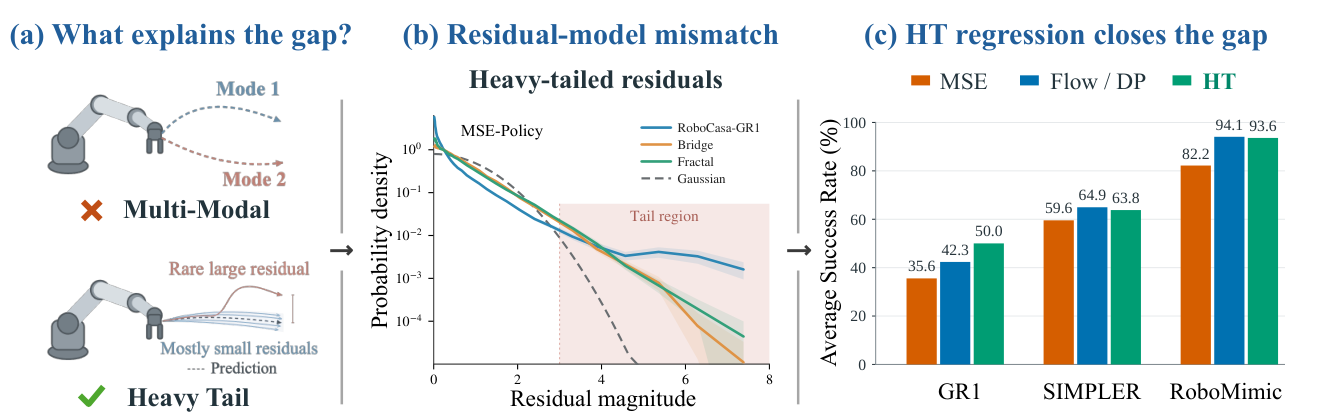
- 1
先把动作误差与去噪训练误差区分开
图1展示MSE动作残差厚尾,论文进一步发现Flow生成动作的残差也厚尾。Flow训练却能读取带噪的示范动作:在固定t>0时,简单预测器a_t/t的速度残差是高斯噪声ε/t。这个参照解释一种机制,不是任意训练网络都满足高斯尾界的定理。
- 2
为整段动作预测一个尺度
网络同时预测动作块和一个正标量σ(o),在所有有效坐标间共享。Student-t负对数似然包含d·logσ和log(1+残差平方范数/(νσ²));前者防止通过无限放大尺度轻易降低误差惩罚。σ是Student-t尺度,不直接等同于条件标准差或已校准风险。
- 3
减少大标准化残差的梯度权重
动作梯度为r/σ²乘(ν+d)/(ν+||r||²/σ²)。随着相对残差增加,权重下降;ν=cd使控制厚尾程度的c不直接随动作块维数变化。论文测试c=4较好,但自由度扫参只有单种评测种子。
- 4
从预训练流网络读出单步动作再微调
把动作输入置零、时间设到纯噪声端点,得到条件均值的自然初始化;反向噪声路径需反号并换端点。增加尺度头,用HT联合微调后只输出动作,一次前向完成。Cosmos分支仍保留视频训练损失,推理视频噪声通过联合注意力仍可能带来随机性。
实验与证据
阅读全文与附录A.1–A.7,区分误差诊断、评测种子、逐任务差异、计时边界及似然校准数据。
来源证据RoboMimic九任务、两种观测、三种训练种子;U-Net HT最佳/末十次平均95.3/85.6,DP93.8/84.7;Transformer HT91.9/82.9,DP94.3/84.1。 表1、附录A.4.5和A.5.1 ↗
我的解读骨干不同结论不同。RoboCasa“从零训练”只随机初始化动作头,视觉语言骨干仍预训练并冻结,不能当作整模从零。
来源证据微调主表每个模型用一个检查点、十种评测种子;LIBERO每任务每种子100回合,RoboCasa24任务每任务约20回合。 表2、14、19–24 ↗
我的解读主表小标准误反映评测变化,不证明训练稳定;LIBERO-10子套HT93.44%低于Flow95.23%,应保留长任务回退。
来源证据实机PiperX三任务各100条VR演示、每方法50次测试;30Hz执行,预测16步、执行8步再规划。 图7、附录A.4.1 ↗
我的解读这是有限任务与初始化区域的验证;论文未给出广泛场景可靠性。单纯一次前向不会自动提高物理执行频率或解决所有接触问题。
来源证据单5090、batch 1、BF16且不编译:GR00T整模46.20→24.52ms,π0.5为123.58→67.94ms,Cosmos3-Nano1271.76→71.34ms。 表3、26与附录A.6 ↗
我的解读整模速度分别1.88、1.82、17.83倍,不能只引用动作头9.74倍作为π0.5端到端收益。计时从已预处理GPU输入开始,排除输入输出、环境执行和视频解码。
来源证据八种目标的校准似然与成功率Spearman0.86;校准采用训练演示的分组留出、策略参数固定,成功率比较为单次评测。 图9、10与附录A.7.2 ↗
我的解读相关性支持优化解释,不证明闭环因果;训练曲线按优化步数而非墙钟时间,不能据此宣称所有训练总时间同比减少。
开放情况与使用许可
论文全文可获取;论文提供的官方项目地址本轮经跳转返回404,搜索未核实可用官方实现或权重,因此只按论文收录,不宣称已开源。
LICENSE论文及原图CC BY 4.0;代码和模型许可尚未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
GR00T在RoboCasa-GR1微调后HT50.01±0.51%,复测Flow42.34±0.68%,MSE35.55±0.67%;误差为十种评测种子的标准误。
π0.5四套LIBERO平均HT96.97%、Flow97.09%,单5090整模推理延迟67.94ms对123.58ms,展示了接近准确率的速度交换。
反方 · 哪些结论还不够
Bridge平均62.31%接近Flow62.06%,却掩盖carrot on plate由63.00%跌到29.80%、open drawer由100%跌到72.60%。
Fractal平均HT65.25%低于Flow67.83%;强多模态行为和控制关键的小误差仍可能需要生成分布。
综合判断
这是有说服力的损失函数与优化诊断工作,支持将HT加入机器人策略的基础对照;“缩小差距”不等于替代所有生成策略。
我会先做的验证
建议实验,未执行:在相同骨干和多次独立训练下比较MSE、异方差Gaussian、HT与Flow,专门加入左右绕障等多峰演示和罕见接触纠错;分别测任务成功、关键状态误差、标度校准与完整输入输出链路延迟。