HuGe:把第一视角经验接入人形机器人动作空间
统一动作 token 和伪本体状态,能否缩小人类视频到机器人的差距?
HuGe 使用SONIC动作空间连接人类第一视角数据、机器人遥操作和任务微调,在三种VLA结构上测试。论文的主要贡献是数据及表征接口;实机增益目前集中在取可乐这一任务。
图解主要方法
统一动作 token 和伪本体状态,能否缩小人类视频到机器人的差距?
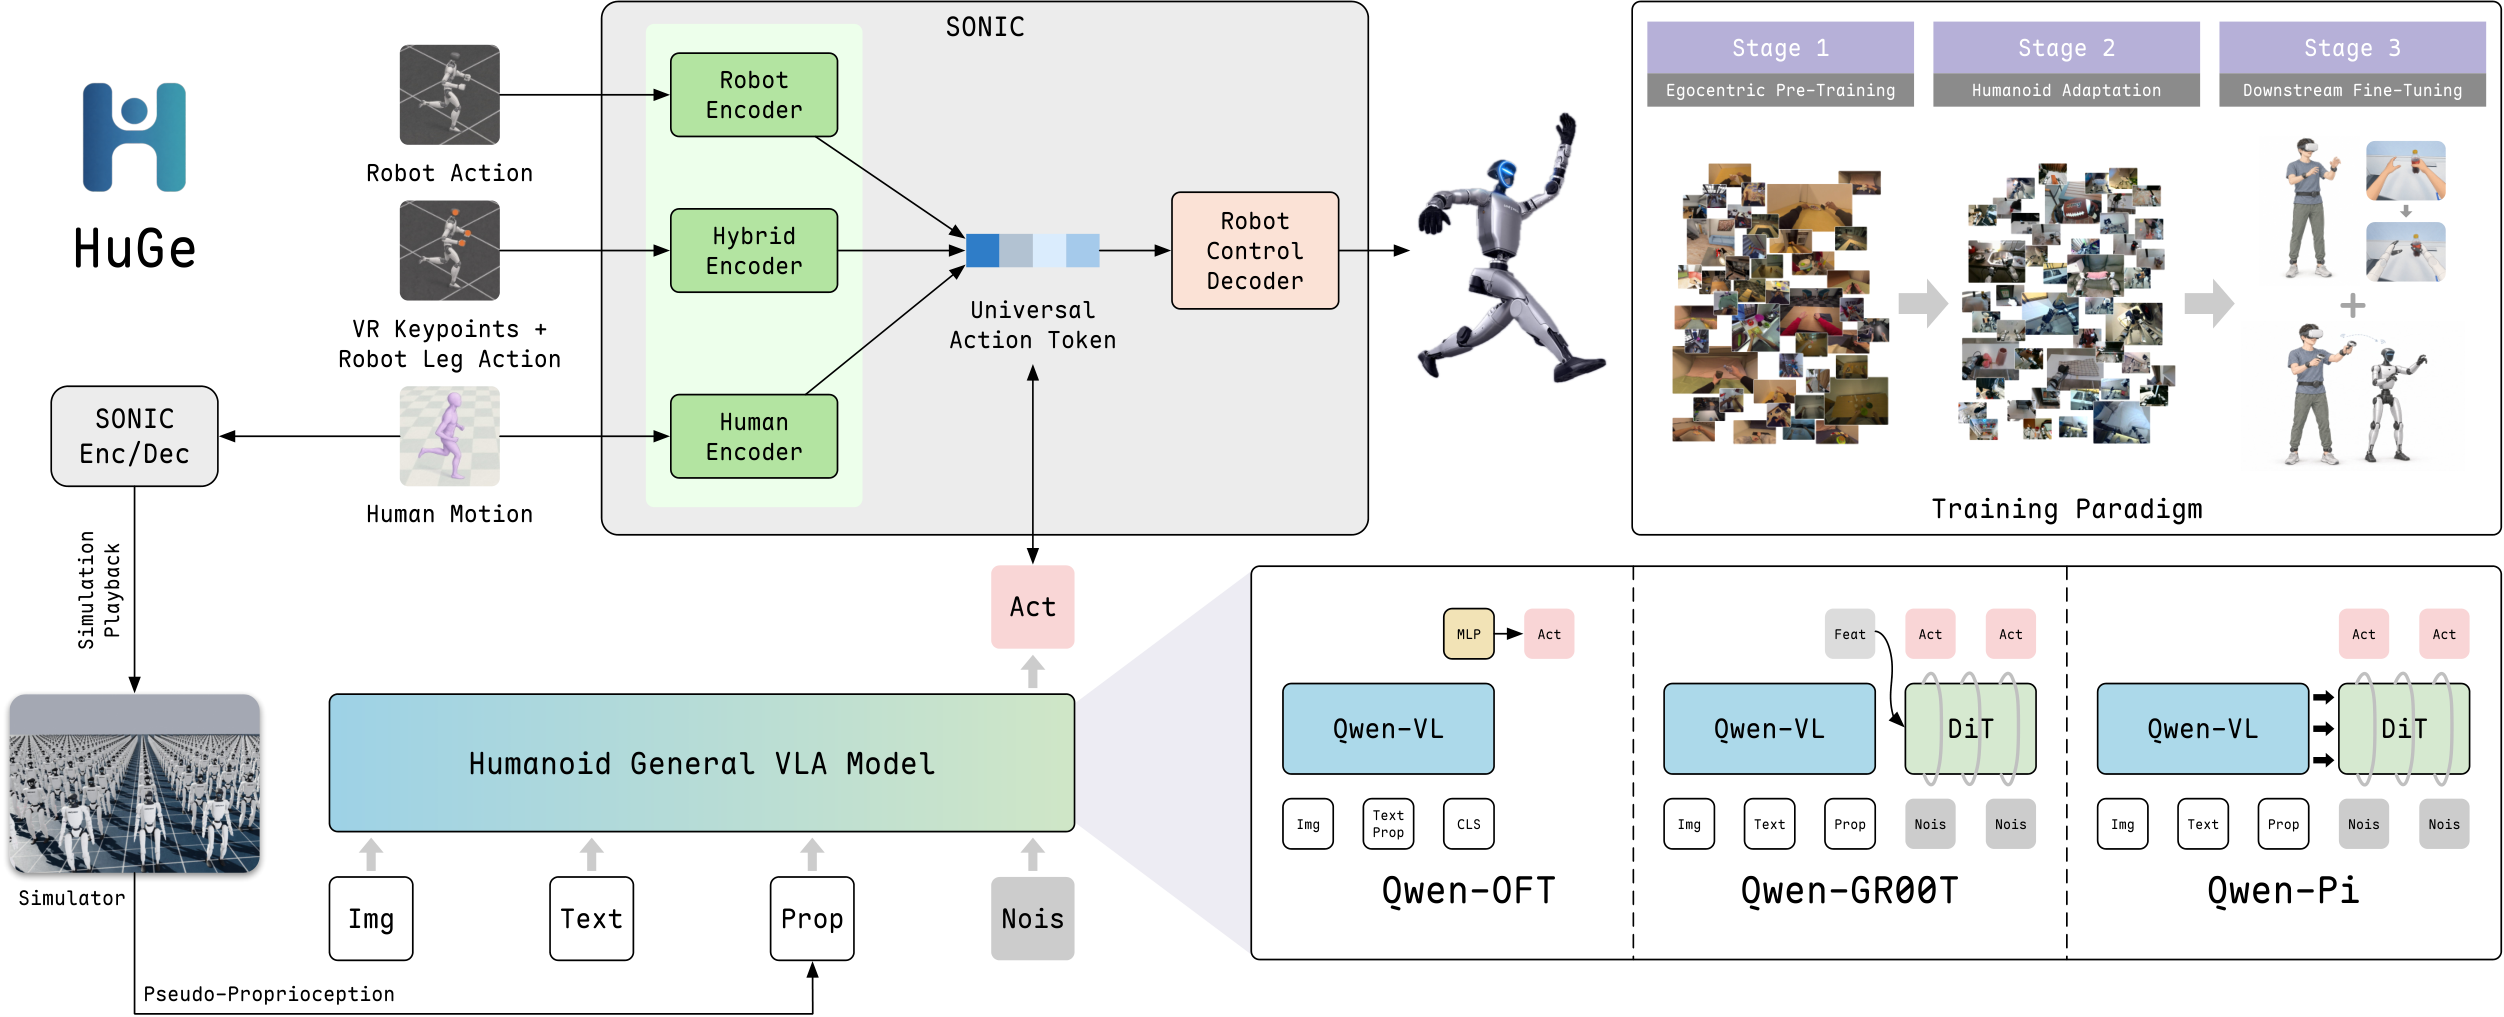
- 1
图1上方:统一动作但保留低层控制
人类和机器人运动编码成64维SONIC运动latent,另加两个手部二元状态形成66维动作。模型预测50步动作块,固定SONIC控制器负责底层平衡,不是语言模型直接接管电机。
- 2
从模拟回放补齐本体感觉
人类运动映射到G1后回放,得到29关节、两手和3维重力方向组成的34维伪状态。缺失手标签要掩码,部分数据固定下肢,不能把伪状态当真实机器人传感器读数。
- 3
图1右上:分阶段适配
先使用1669.61小时的人类/仿真混合数据,再用417.58小时G1遥操作,最后任务微调。真实微调比较110条机器人演示与追加400条人类演示,另用视频编辑移除人手并渲染机器人手,动作与状态监督保持相同。
实验与证据
已阅读全文正文与附录A训练实现,核对实验条件与原图;未独立复现。
来源证据7任务,每任务100演示、60评测试次;全参数微调的GR00T样式平均66.67%、pi样式65%。每种配置仅一次策略训练,部分基线引用原论文。 HumanoidArena与附录A ↗
我的解读60次评测不是60次独立训练;固定SONIC与相同数据有利于比较接口,但不能消除跨论文基线差异。
来源证据同为30试次,机器人数据13/30,加入原始第一视角18/30,加入编辑后第一视角20/30。 真实G1取可乐 ↗
我的解读编辑相对原始仅多2次成功,且单任务、安全架条件;不能据此宣称普遍具身迁移显著提升。
开放情况与使用许可
官方仓库已有src、configs、scripts,根目录未核实到许可证;代码可见不等于取得开源再分发许可,未声称数据和权重已完整开放。论文声明图1阶段3部分示意由AI辅助制作。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
人类数据与机器人数据不仅视觉不同,动作语义和本体输入也不同;HuGe把这些接口差异显式化。
反方 · 哪些结论还不够
抓取和平衡仍导致失败;DoubleDesk任务仅0—15%成功。伪状态对不同架构并非一致有益,OFT因文本状态截断可能退化。
综合判断
是第一视角预训练接入人形控制的工程路线证据,距离多任务实机通用能力还有明显缺口。
我会先做的验证
未执行的验证方案:至少增加三类接触与搬运任务、多训练种子和无安全架受控测试,固定演示量比较原视频、编辑视频及仅机器人数据。