HyperDrone:高吞吐视觉仿真与微型无人机迁移
百万帧吞吐怎样转化为机载视觉策略,又有哪些外部依赖?
HyperDrone 将光线追踪渲染、无人机动力学和强化学习训练集中在高吞吐环境中,再把视觉学生策略部署到微型无人机。百万帧是低分辨率大批量的总吞吐;实机展示主要是视觉偏航控制,位置估计仍依赖外部动捕,不能称为完整无外部定位自主飞行。
图解主要方法
百万帧吞吐怎样转化为机载视觉策略,又有哪些外部依赖?
- 1
第一步:让渲染与动力学尽量留在GPU
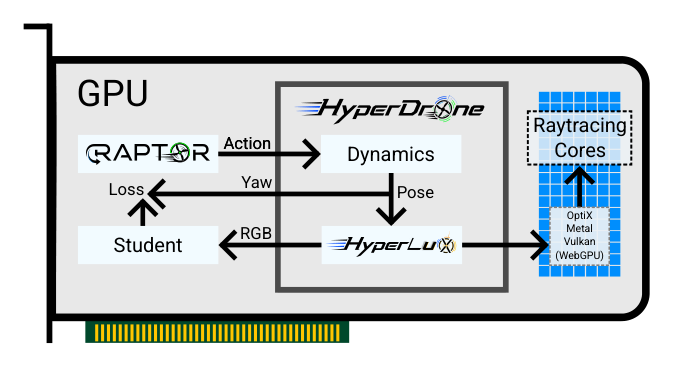
图2把HyperLux渲染、动力学、RAPTOR教师与视觉学生放在同一训练循环。OptiX后端可将动力学也放到GPU;Vulkan、Metal和WebGPU路径的动力学仍走CPU线程。不同后端的吞吐不能一概视作同一种计算图。
- 2
第二步:保留有用外观,主动简化光照
渲染器读取GLTF中的金属度、粗糙度、法线、遮挡和发光纹理,采用简化环境光与有限反射。它没有完整阴影、多次反弹或次表面散射;以低分辨率批量渲染换取训练规模,不能把PBR输入支持理解为照片级光传输。
- 3
第三步:由特权教师指导小型视觉学生
RAPTOR教师使用仿真特权状态,约0.73M参数的CNN学生读取当前和目标80×50 RGB图像,学习偏航控制。训练使用ProcTHOR前30场景中的25个训练、5个验证场景,128个环境;不是对整个ProcTHOR一万场景都完成训练。
- 4
第四步:部署时拆清视觉控制与定位
图2输出的学生策略在Crazyflie搭载的OpenMV AE3上运行,通过串口输出偏航相关控制。真机500Hz低层控制器与EKF仍使用外部动捕位置;它证明轻量视觉部件可迁移,未证明从机载图像完成定位、避障和完整导航闭环。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据RTX5090在高复杂度ProcTHOR场景中渲染约244万帧/秒,加入动力学约243万帧/秒。M3 Pro等平台也报告渲染结果,但后端及物理执行位置不同。 吞吐表,64×64、batch4096 ↗
我的解读数字是所有并行环境的总吞吐,不是单无人机观测频率。画质、传感器模型与场景复杂度不同,对其他模拟器的倍率不能作为严格同质比较。
来源证据作者报告5090约4小时、6GB显存完成所示训练,3060约15小时。学生输入是小图像、任务集中在视觉偏航。 训练与附录 ↗
我的解读这表明该任务可在消费级设备训练,不能推广到高分辨率、多目标导航或复杂接触动力学的相同成本。
来源证据论文展示Crazyflie上的目标朝向跟随,没有给出大规模真实飞行成功率和碰撞统计;位置闭环依赖外部动捕,渲染采用全局快门等简化。 实机展示与控制架构 ↗
我的解读仿真到真实的证据是定性可行性,而非完整自主无人机系统的量化验收;照明变化、滚动快门及外部定位失效仍是缺口。
开放情况与使用许可
2026-10-25核查官方rl-tools/hyperdrone仓库、文档入口和MIT LICENSE;核心实现位于固定提交的rl_tools子模块,已核实hyperdrone控制器、动力学与渲染接入源文件,README提供hyperdrone/hyperlux安装与示例入口。代码许可不覆盖ProcTHOR等第三方资产。论文采用arXiv非独占托管许可,作者保留版权;本页仅引用讲解架构所需图2,不将该托管许可说成图片通用再授权。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:在视觉训练瓶颈是渲染吞吐时,把渲染与策略学习紧密集成有明确价值;小学生网络能让研究从桌面GPU走向轻量机载算力。
反方 · 哪些结论还不够
高吞吐建立在传感器与光照简化上,实机又保留外部位置反馈。若目标是无动捕自主导航,论文还没有跨过定位、避障和多环境可靠性这些环节。
综合判断
适合复现高吞吐视觉控制训练与特定偏航任务,不宜把百万帧宣传为高保真仿真或全自主飞行能力。
我会先做的验证
未执行的验证方案:以相同64×64分辨率、场景、批量和物理步长比较后端吞吐及端到端训练时间;实机在受控安全场地分别改变照明、目标速度与图像延迟,记录角度误差和失败率,始终注明动捕是否参与控制。