ICLR:智能体什么时候可以忘记刚才的推理
按代理模型预测熵删块,总体增益掩盖了领域差异
ICLR 在每步工具交互之后压缩刚完成的推理文本,保留动作和观察,再把压缩历史永久写回。论文把推理视为暂存任务状态:结论写进代码、文件或工具反馈后,旧文本可能更容易替代;这仍是有风险的经验压缩规则。
图解主要方法
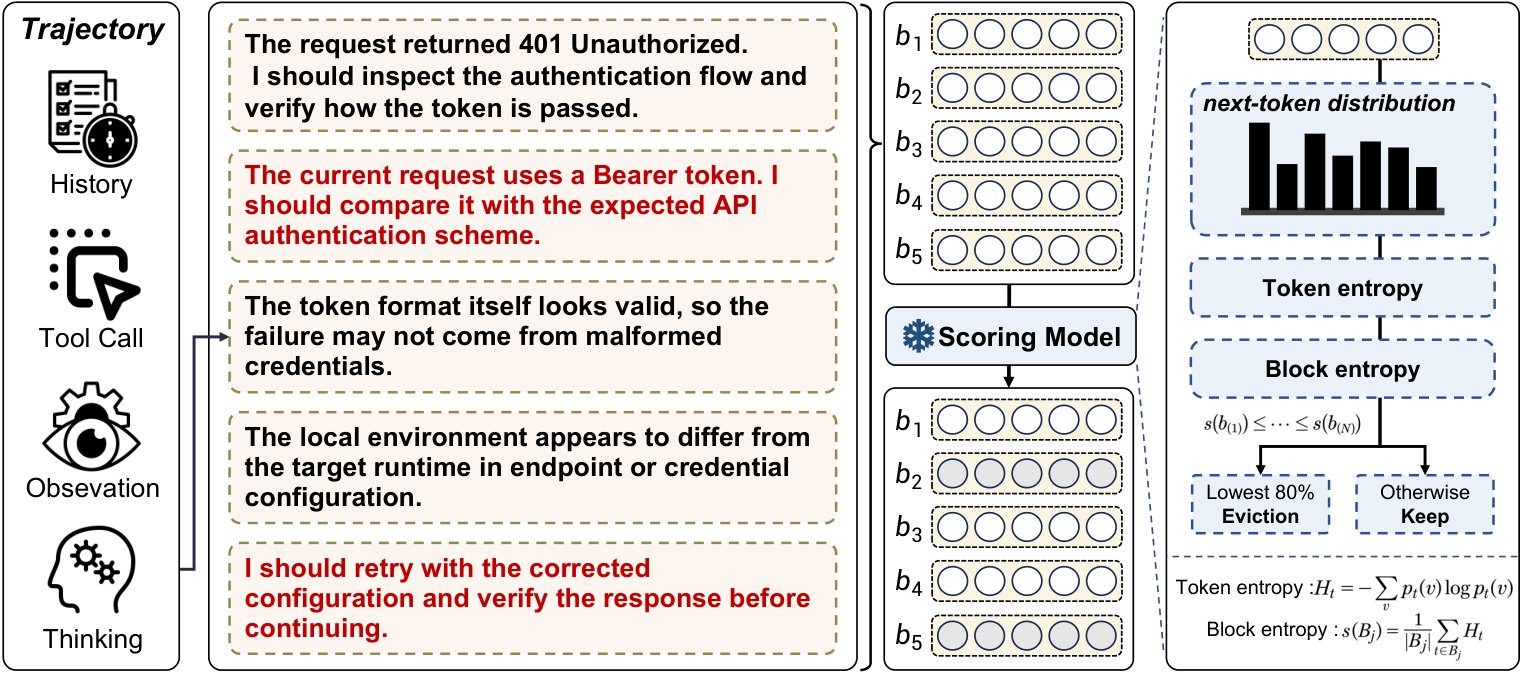
图 2 为什么评分低熵文本,又为何不能据此保证删除安全?
- 1
只选择当前完成步骤的推理块
图左按双换行把可见的 reasoning 切成非空块,动作、工具参数、工具输出和最终答案不动。首轮不压缩,之后每轮只处理刚完成步骤,再永久改写历史;这需要接口确实能导出推理文本。
- 2
用冻结代理估计分布熵
图中冻结 Qwen3.5-9B 读取因果上下文,计算预测下一个 token 的整个分布熵,再在块内平均。这不是已出现 token 的 surprisal,也不是代理判定内容是否正确;代理与实际执行器 DeepSeek-V4-Flash 并不相同。
- 3
删除最低熵块并承担轨迹变化
图右删除最低 floor(0.8N) 个块,以 [SKIP] 替换;80% 是块数而非 token 比例,只有一个块时不删。代理输入超过 42K 时跳过。后续行动会随历史变化,因此局部删得少也可能大幅改变后续调用和总成本。
- 4
把状态是否已外化作为诊断
论文进一步比较任务中间状态是否已落入可靠文件、代码或观察;未外化状态删除后更可能触发重推导。代理探针和激活替换帮助分析表示,但最终层替换恢复输出本就是确定性读出的正对照,不能冒充执行器策略的因果证明。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【完整 260 任务】总奖励 0.699→0.718,输入加输出 token 约降 18.5%;安全任务 +22.9 个百分点,但代码、办公、网页分别约降 6.4、4.2、2.2 点。 表 2 与附录 E.1 ↗
我的解读我的解读:平均提升主要由安全领域驱动;部署到代码工作流时不能据平均数判断无损。代理评分另需算力,文中没有给出完整服务账单。
来源证据【结果依赖子集】Pilot40 平均分提升,但 token 1.89M→2.02M,反增约 6.9%;80 任务消融中直接删全部推理也优于基线,且更省 token。 表 1、表 3 与附录 F ↗
我的解读我的解读:收益不只来自熵排序;不同评估集的路线变化使节约不稳定,80%块删除不是80%端到端节约。
来源证据【机制诊断】265 个边界来自31任务,严格按任务交叉验证探针 AUROC 0.844;未外化状态的后续风险高于已外化状态。 附录 B、G、H、I ↗
我的解读我的解读:标签是后续重推导、额外思考或重规划,并非反事实的真实必要性。固定删除集合的信息上界也不直接保证自适应代理删除。
开放情况与使用许可
已读正文及附录 A–M;未核实本方法专属训练或评估实现公开。ICLR 是本文方法缩写,不代表会议录用。
LICENSE论文及图 2 为 CC BY 4.0;本方法实现许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把推理内容与外部任务状态的关系纳入压缩判断,比只按长度截断更接近真实长任务需求。
反方 · 哪些结论还不够
代理熵与任务价值可能错位,丢失推导具有持久影响;三领域退步和子集成本反转限制通用性。
综合判断
值得在可恢复、可测量的长任务上实验,应先建立分领域质量门槛和状态外化检查,不能默认无损压缩。
我会先做的验证
未执行的验证方案:固定任务与执行器,多种子比较保留全历史、等token随机删块、熵删块及只删已外化块;计入代理费用,报告各域成功率、恢复调用、信息丢失和总时延。