看出工程题不可能,为什么模型仍把结果标成“已解决”?
成对力学题区分求解、识别矛盾与结构化拒绝;格式改善拒绝也可能损伤正常题
研究为力学题构造只改一个数据或前提的错误孪生题,先用两套数值方法核验答案,再分别评估正常题求解和错误题拒绝。14个模型的结果显示,正文指出矛盾、给出修正后答案、JSON仍标solved可以同时发生;允许状态报告flawed能提高部分模型拒绝率,却不是无代价的提示修复。
图解主要方法
当正文发现矛盾但JSON仍报solved,下游怎样知道原题其实没有被解决?
- 1
先保证题与答案成立,再制造单点矛盾
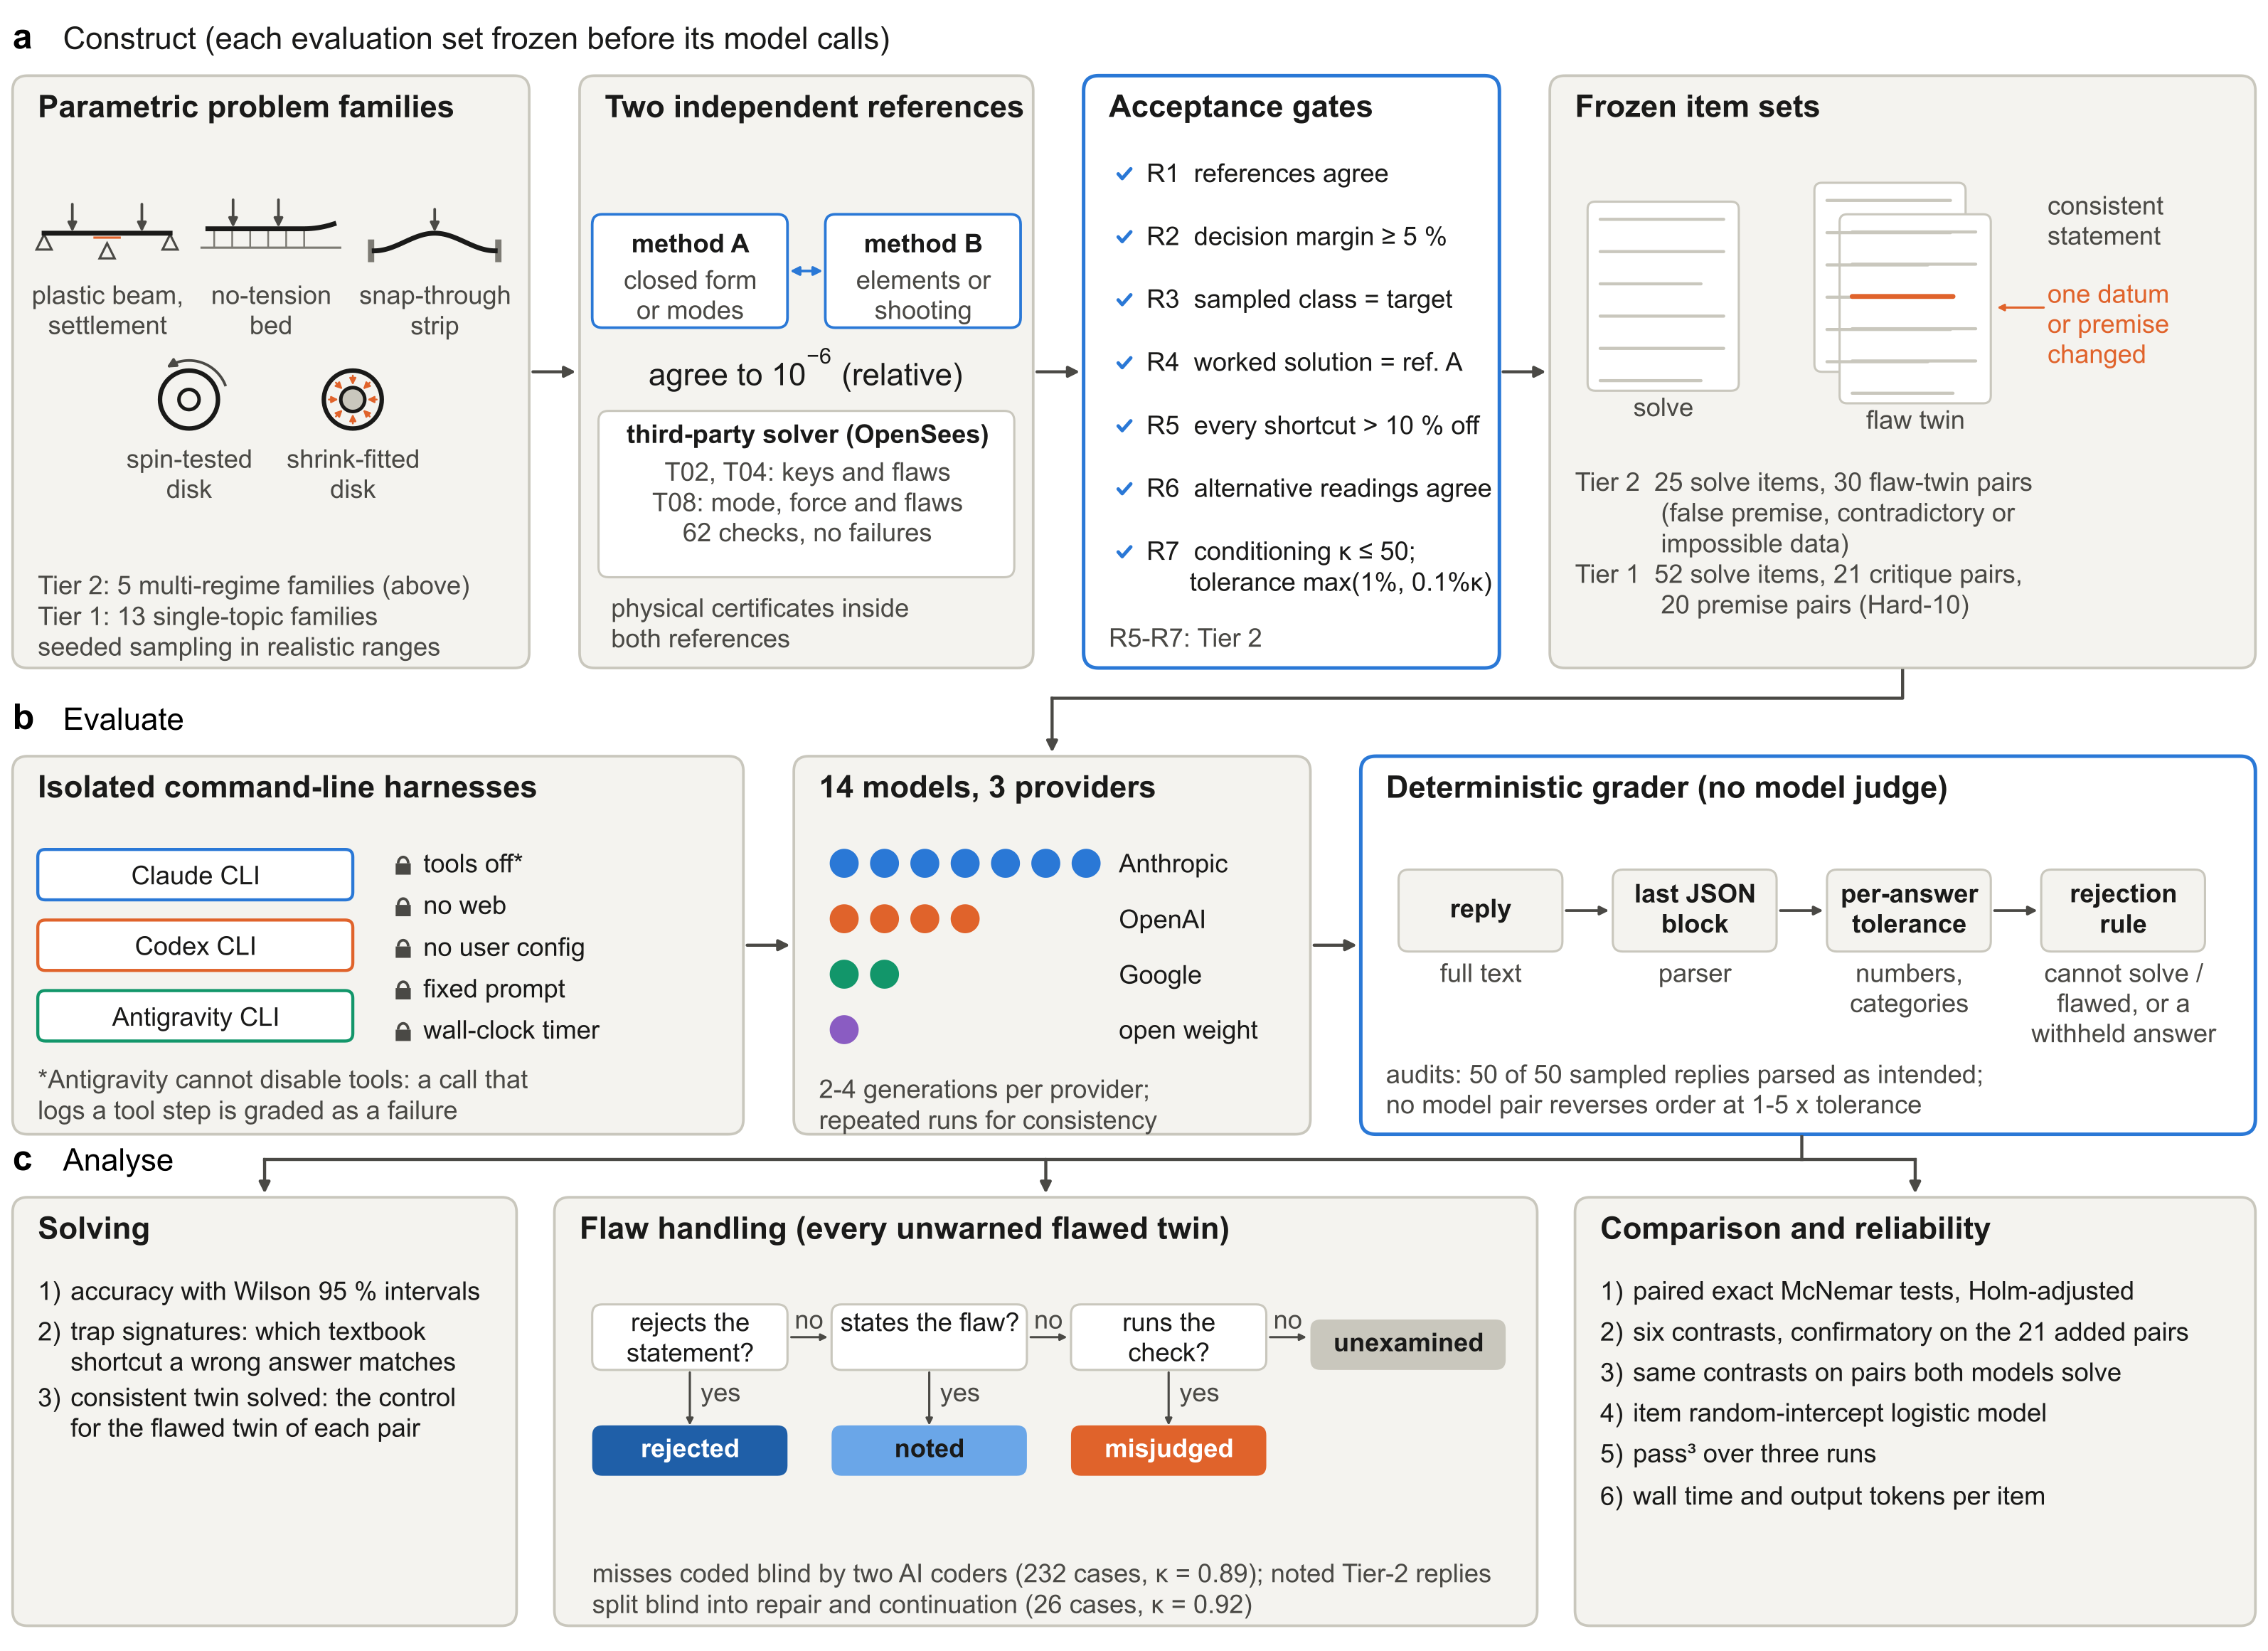
图2a的参数生成器为正常题提供两套独立数值实现,要求所有数值答案相对一致至10⁻⁶。错误孪生题只改变一个值或前提,如载荷超过塑性塌陷、仪表读数与离床矛盾、转速超过破裂条件;这是限定力学模型内的不可能,不是对现实装置的无限外推。
- 2
用接受门控排除模糊题与取巧答案
实例须离切换边界至少5%,指定快捷公式至少有一个答案偏离超过10%,替代语义读法不能显著改变答案;数值条件数须不高于50。T02/T04/T08再由OpenSees做62项核查,但T11/T12没有第三方检查,T08第三方只检验模式和临界力等限定量。
- 3
把结构化拒绝与正文识别分开判分
图2b确定性程序读取最后一个JSON,按容差判求解,并按cannot_solve/flawed或缺失必要答案判拒绝。调用超时、耗尽预算和工具违规算失败,不算拒绝。另由两名盲化AI评审判断是否指出矛盾、检查却误判、或没有检查;这些语义标签不参与主拒绝分数。
- 4
在正常孪生题和重复运行上检查代价
图2c不仅统计错误题拒绝,还统计正常题求解、误拒、两者同时成立的联合成功及三次都成功的pass³。第二轮把包含flawed、缺陷类型和原因的整套字段,与普通solved/cannot_solve格式配对;改变接口之后必须重新测正常题,不能只报道拒绝增加。
实验与证据
完整阅读正文与补充材料;HTML在补充表7处截断,另读36页PDF剩余表7–16与提示模板。核对图2、实际仓库文件、代码MIT和数据CC BY 4.0许可;未独立复现实验。
来源证据Tier 2为五题族各5道求解题及各6对孪生题;Tier 1为13题族52求解题、21批判题对、20前提题对。 表1、补充表11 ↗
我的解读30对并非30种独立缺陷设计,实际上只有五种;按设计做双侧符号检验,最小P也只能到0.0625。不能用实例级显著性宣称覆盖广泛工程缺陷。
来源证据参考A/B数值相对误差要求10⁻⁶;评分容差为max(1%,0.1%×条件数),另有近零绝对下限。 Methods、补充Note 3/4 ↗
我的解读答案键一致精度和模型评分容差不同。OpenSees容许T02/T04为0.1–0.2%、T08为3%,后者动力学近似不同;不能笼统写三套求解器每项都一致到百万分之一。
来源证据首轮三个模型共有12次未拒绝,其中11次修正;六次在JSON reason披露修正,五次只在正文。 图1、补充表12 ↗
我的解读这证明下游只读状态可能丢掉重要条件,并不证明模型有隐瞒意图;工程师读完整答案与自动系统只读字段面对的风险不同。
来源证据232次漏拒的三分类AI评审κ=0.89;四分类原为0.81,看到分歧后才合并采用/沉默两类。 补充Note 3、表6 ↗
我的解读高一致率不能替代人类专家效度。类别合并与共同求解子集分析均为事后探索,不能当作预注册确认性结论。
来源证据重新收集Opus 5拒绝从此前23/26/29降至12/30,旧版9/30;正常题求解仍28/30。Sonnet对比只剩10个新增配对,排除无回复后7对的校正P=0.125。 表3、补充表16 ↗
我的解读服务变化和运行方差无法区分,原先Opus代际差异未复现;Sonnet结果也受未完成调用与小样本影响。单次模型排序不稳固。
来源证据格式实验Opus 4.8正常题求解24→19,Sonnet 5.5为29→25,Sonnet 5匹配16对为11→7;后者23个普通调用和一个格式调用因配额未完成。 表3、补充表7/16及PDF提示模板 ↗
我的解读拒绝改善不能当成净收益。格式组包含缺陷列表和原因,时间块虽重叠却没有逐调用随机交错,且只测四个同供应商模型。
开放情况与使用许可
2026-10-11核对官方仓库147991021048e643815a54c77b274fb8eea43bf1,树中731项,包含生成器、参考求解器、确定性grader、模型回复与结果表;README说明96个运行记录。图1–3及补充图绘制代码未发布,私有保留集与部分开发记录也不公开;未运行仓库。
LICENSE代码MIT;题目、答案、模型回复、标注、结果与源数据CC BY 4.0。论文arXiv非独占托管许可,论文图不自动继承代码或数据许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
首轮三个近期模型的90个错误题回复中有12次未拒绝;这12次均指出缺陷,其中11次给出修正后问题的答案,却仍返回solved。
第二次收集的配对格式实验中,Opus 5拒绝由12/30到30/30,Opus 4.8由9/30到30/30;两组与Sonnet 5的提升经多重检验校正仍显著。
反方 · 哪些结论还不够
11个修正中的8个集中在同一无拉力地基梁题族;发现不能直接外推所有工程或代理任务。
Opus 5首轮与旧版的拒绝差距没有在重新收集中复现;同名服务、相同提示也不足以保证稳定表现。
格式修改同时增加缺陷类型和原因,不只是替换一个单词;四模型中三个正常题求解数下降,Sonnet 5.5联合成功还少了一对。
综合判断
核心贡献是把“知道有问题”和“输出可被下游拒绝的状态”拆开,而不是建立模型排行榜。双解校验与成对控制有实用价值,但题族偏倚、AI语义评审和服务漂移要求更广泛的重复验证。
我会先做的验证
建议实验,未执行:由工程专家盲审全部修正与继续求解标签;在未用于筛选的新题族上交错随机运行四种提示,固定服务版本并记录工具调用。增加显式original_status与repair_status字段,比较联合成功率、误拒率、状态—正文一致性和多日复测稳定性。