InfiLoop:让反复推理保留有效状态,而不是不断覆盖答案
7M解谜模型的循环残差机制;97.9%数独成绩依赖39种深度与规则验收
InfiLoop用共享内容评分和指数时间衰减,把历次循环的候选状态压缩成固定大小的加权摘要。它在小型递归解谜模型中减少已解答案被后续循环破坏,但并非已验证的通用语言模型;最高数独成绩还使用多深度重启和外部数独规则检查。
图解主要方法
怎样让更多循环继续利用有效中间状态,而不是把已经解出的答案覆盖掉?
- 1
共享计算块提出新候选
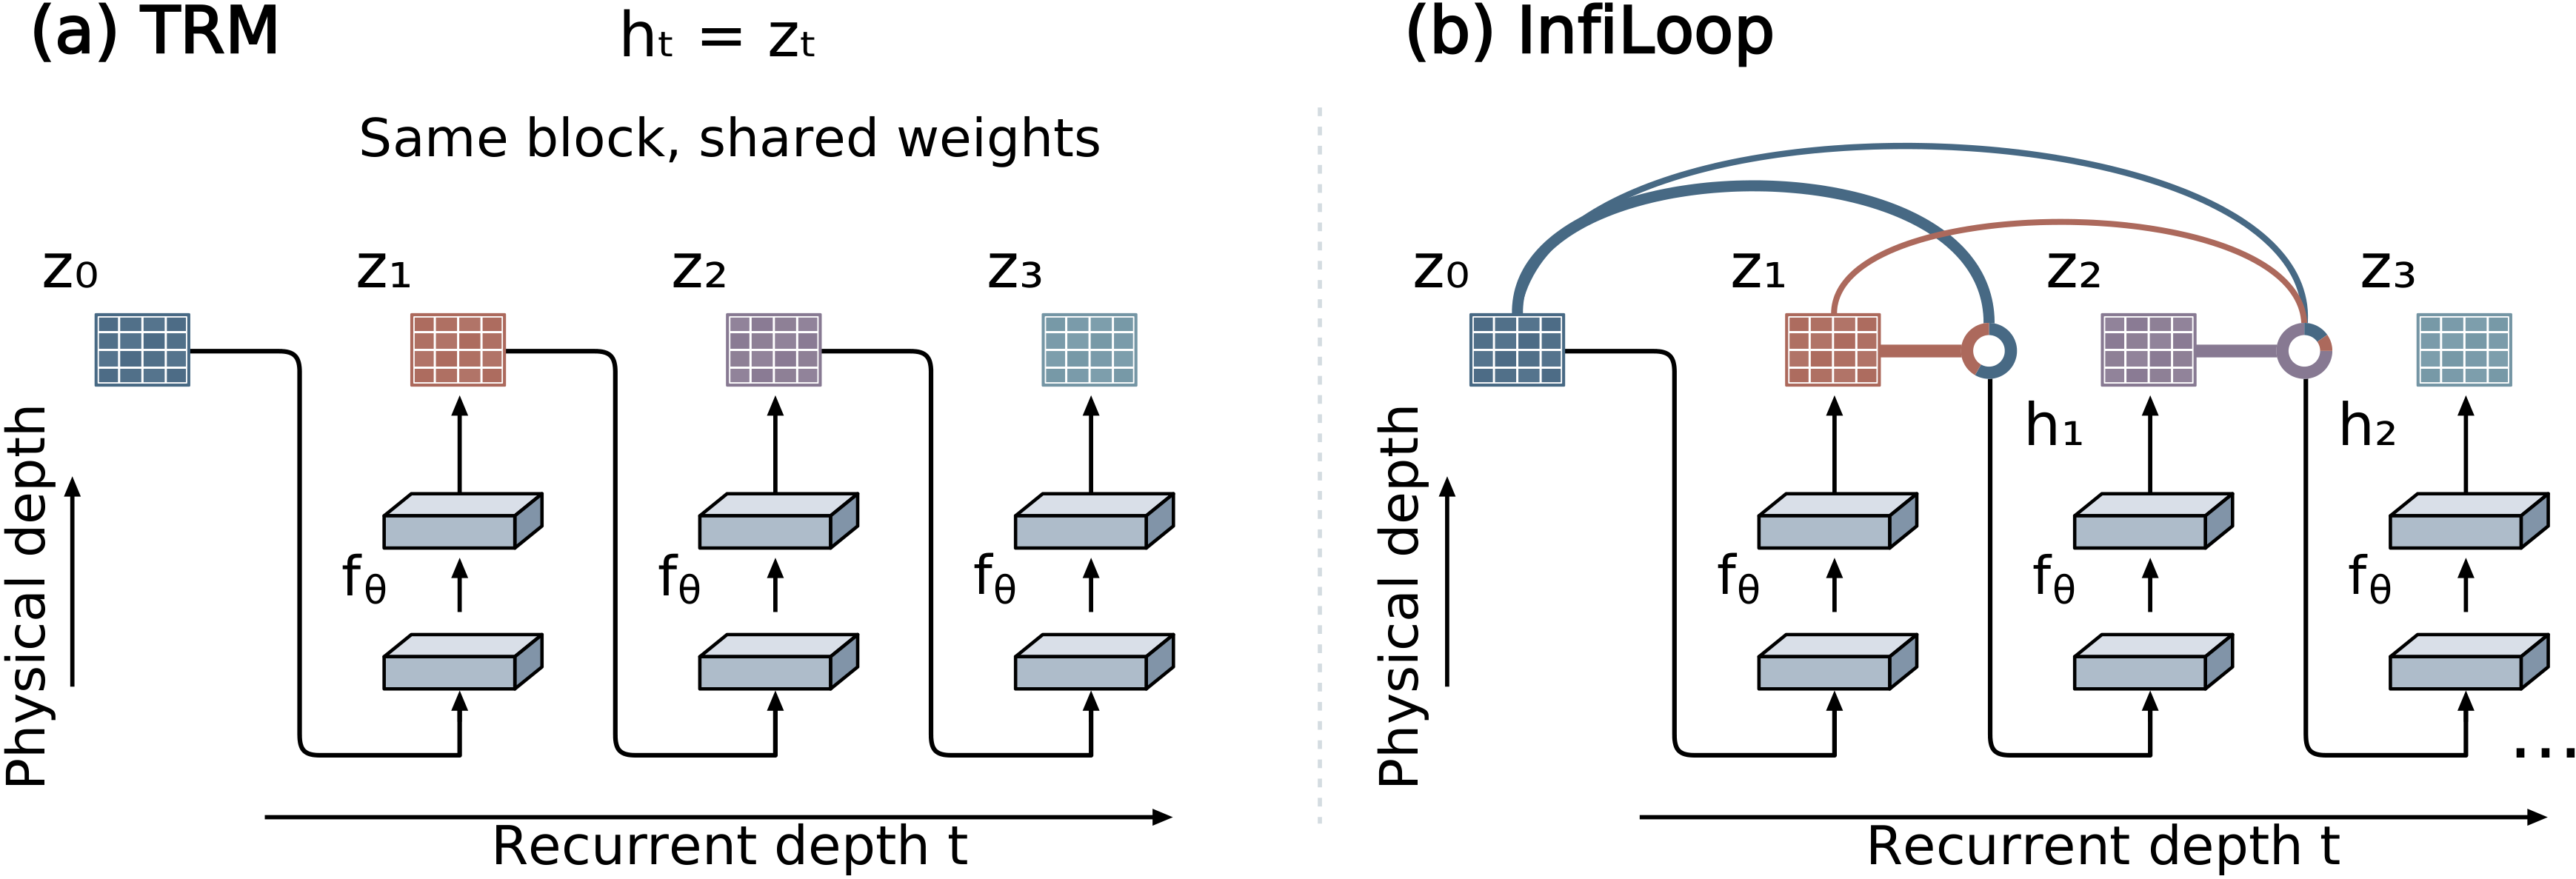
图2左侧传统TRM直接把共享块输出z作为下一步状态h;InfiLoop仍复用同一个计算块,但不必完整接受最新输出。模型不是保存可读思维链,而是在每个token位置处理隐藏向量。
- 2
用内容评分和年龄决定贡献
一个跨循环共享的伪查询q对RMSNorm后的候选打分,再取指数作为内容权重;旧候选每轮乘β,β在0与1之间。评分只在候选产生时计算一次,因此无法用随当前问题状态变化的新查询重新检索任意旧候选。
- 3
把整个历史压缩成精确递推
维护分子N与分母D:N←βN+exp(s)z,D←βD+exp(s),再取h=N/D。它与共享评分、指数衰减的历史注意力代数等价;每token只需一个向量和一个标量,不随循环次数增加。
- 4
以自适应步长接纳新状态
同一更新可写成h←h+γ(z−h),γ是新候选权重占总权重的比例。高分候选改变状态更多,低分候选较少;嵌套模型在内外两条循环轴分别维护评分器、衰减和累加器。
- 5
区分训练监督与推理验证
数独训练每段21次共享块调用,仅最后7次回传梯度,跨段做深监督。固定深度评测直接argmax;97.9%系统另在39种深度中分别重启,检查行列宫与已知格约束后接受首个有效解。这项规则检查与内部学习评分不是同一机制。
实验与证据
完整阅读64481字符正文及附录A–D,视检图2,核对官方仓库实际文件、数独实现许可与评测README。未训练或运行基准。
来源证据数独1000道基础训练题,每题约1000种对称/数字增广;422786道测试题。模型宽512、两层共享块,训练H3/L6、12监督段、批量768。 第4.1–4.2节 ↗
我的解读约百万训练样本来自1000基础题增广,不应当作百万独立题;属于专门训练的解谜系统。
来源证据固定32768测试题深度研究:1872层90.9%,3744层92.4%,24960层92.74%;FPRM在3744层90.1%。 图3、第4.4节、附录A ↗
我的解读支持该范围内更有效利用层计算;标题数万“有效步”实际按执行Transformer层计,不是数万个独立外层决策。
来源证据公开数独评测说明:97.9%合并39种深度,每种从初态重启,规则通过即接受;未通过者取最后预测。 官方sudoku/README.md ↗
我的解读不用标签挑解,但确实使用任务专用验证器与更大计算。不能把97.9%套到固定1872或24960层配置。
来源证据batch1、97位置的循环持久状态为582.8KiB:两条BF16状态194.0KiB,加FP32分子分母388.8KiB;无跨循环KV缓存。 附录A ↗
我的解读常量指随循环深度不增,仍随序列长和batch线性增长,且约为carry-last持久状态三倍;不等于总显存582.8KiB。
来源证据数独1872层移除评分重训84.1%,原模型90.9%;只在测试移除评分84.8%,将β置零变carry-last仅1.5%。 附录D、表3 ↗
我的解读重训消融更有说服力;测试时改β打破训练分布,1.5%不能作为公平训练后的传统架构能力。
来源证据首次解出时平均γ约0.91,之后回到等权基线0.56;在第36轮扰动后继续36轮,所测已解集合全部保留。 图4–5 ↗
我的解读解后状态稳定并非γ永远归零,也未证明无限期保留。评分与正确性相关不等于独立可靠的通用验证器。
来源证据ARC-1/2报告49.1%/13.6% pass@2;候选由测试增广聚合,大表其他方法采用各自推理流程。 第4.1–4.3节、表1 ↗
我的解读这是完整系统比较,不能独立归因于残差机制或宣称等计算超过通用LLM;公开代码暂未覆盖ARC。
开放情况与使用许可
2026-10-11核对pixeli99/InfiLoop提交4aa562c23448d04782a59934b2ef994d63245a90,共19个树项,含数独数据、模型、训练和评估Python实现。预训练权重未包含,其他基准代码待发布;README明确独立实现尚未重训达到报告成绩,数据子集与增广顺序也不完全复现原实验。
LICENSE论文及图2为CC BY 4.0;sudoku目录代码MIT,保留TRM/FPRM来源及上游归属。根目录无统一LICENSE,不能将数独代码许可自动覆盖所有媒体资源;本图按论文许可引用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
共享评分与几何衰减允许精确递推,不需要存储所有历史候选;每条循环轴只增加513个可学习参数。
相同1872层预算下,去掉内容评分并重训由90.9%降至84.1%,支持收益不仅来自固定平滑。
反方 · 哪些结论还不够
97.9%是39种深度重启加数独规则接受的整体系统成绩;固定24960层为92.74%,不能混称单次深循环97.9%。
历史状态凸组合不扩大候选最大范数,但候选自身可增长,数学式并未保证无限循环正确或稳定。
论文大表混合不同推理协议、外部报告和旧LLM成绩;作者自己复测ARC-2 TRM为4.6%,与原报告7.8%不同,说明协议影响不可忽略。
综合判断
这是值得研究的循环信息保留机制,证据支持特定解谜任务中减少过度迭代损害。其“小模型超过大模型”应限定为这些专用任务和既定评测,而非通用能力或同预算优势。
我会先做的验证
建议实验,未执行:在相同数据、种子、总FLOPs与墙钟预算下比较内容评分、EMA和传统循环;单列规则验证、39次重启和固定深度结果。进一步在自然语言或代码任务中检验错误稳定点、长循环数值溢出与分布外恢复能力。