Internalizer:把文档生成大模型的LoRA,但重建分数还不是问答能力
共享超网络从小模型迁移到284B目标;训练长度外适配器出现明显失效
Internalizer读取冻结语言模型逐层文档特征,以共享Perceiver主干生成按文档变化的LoRA块;每增加一个512-token分块,适配器秩随之增加。它先在1–3B模型上训练共享部分,再迁移到284B目标,展示较好的文档教师强制重建,但尚未报告实际问答、代码任务或服务成本收益。
图解主要方法
上下文到LoRA的共享超网络能否从小模型迁移到很大的目标模型,且重建证据究竟说明了什么?
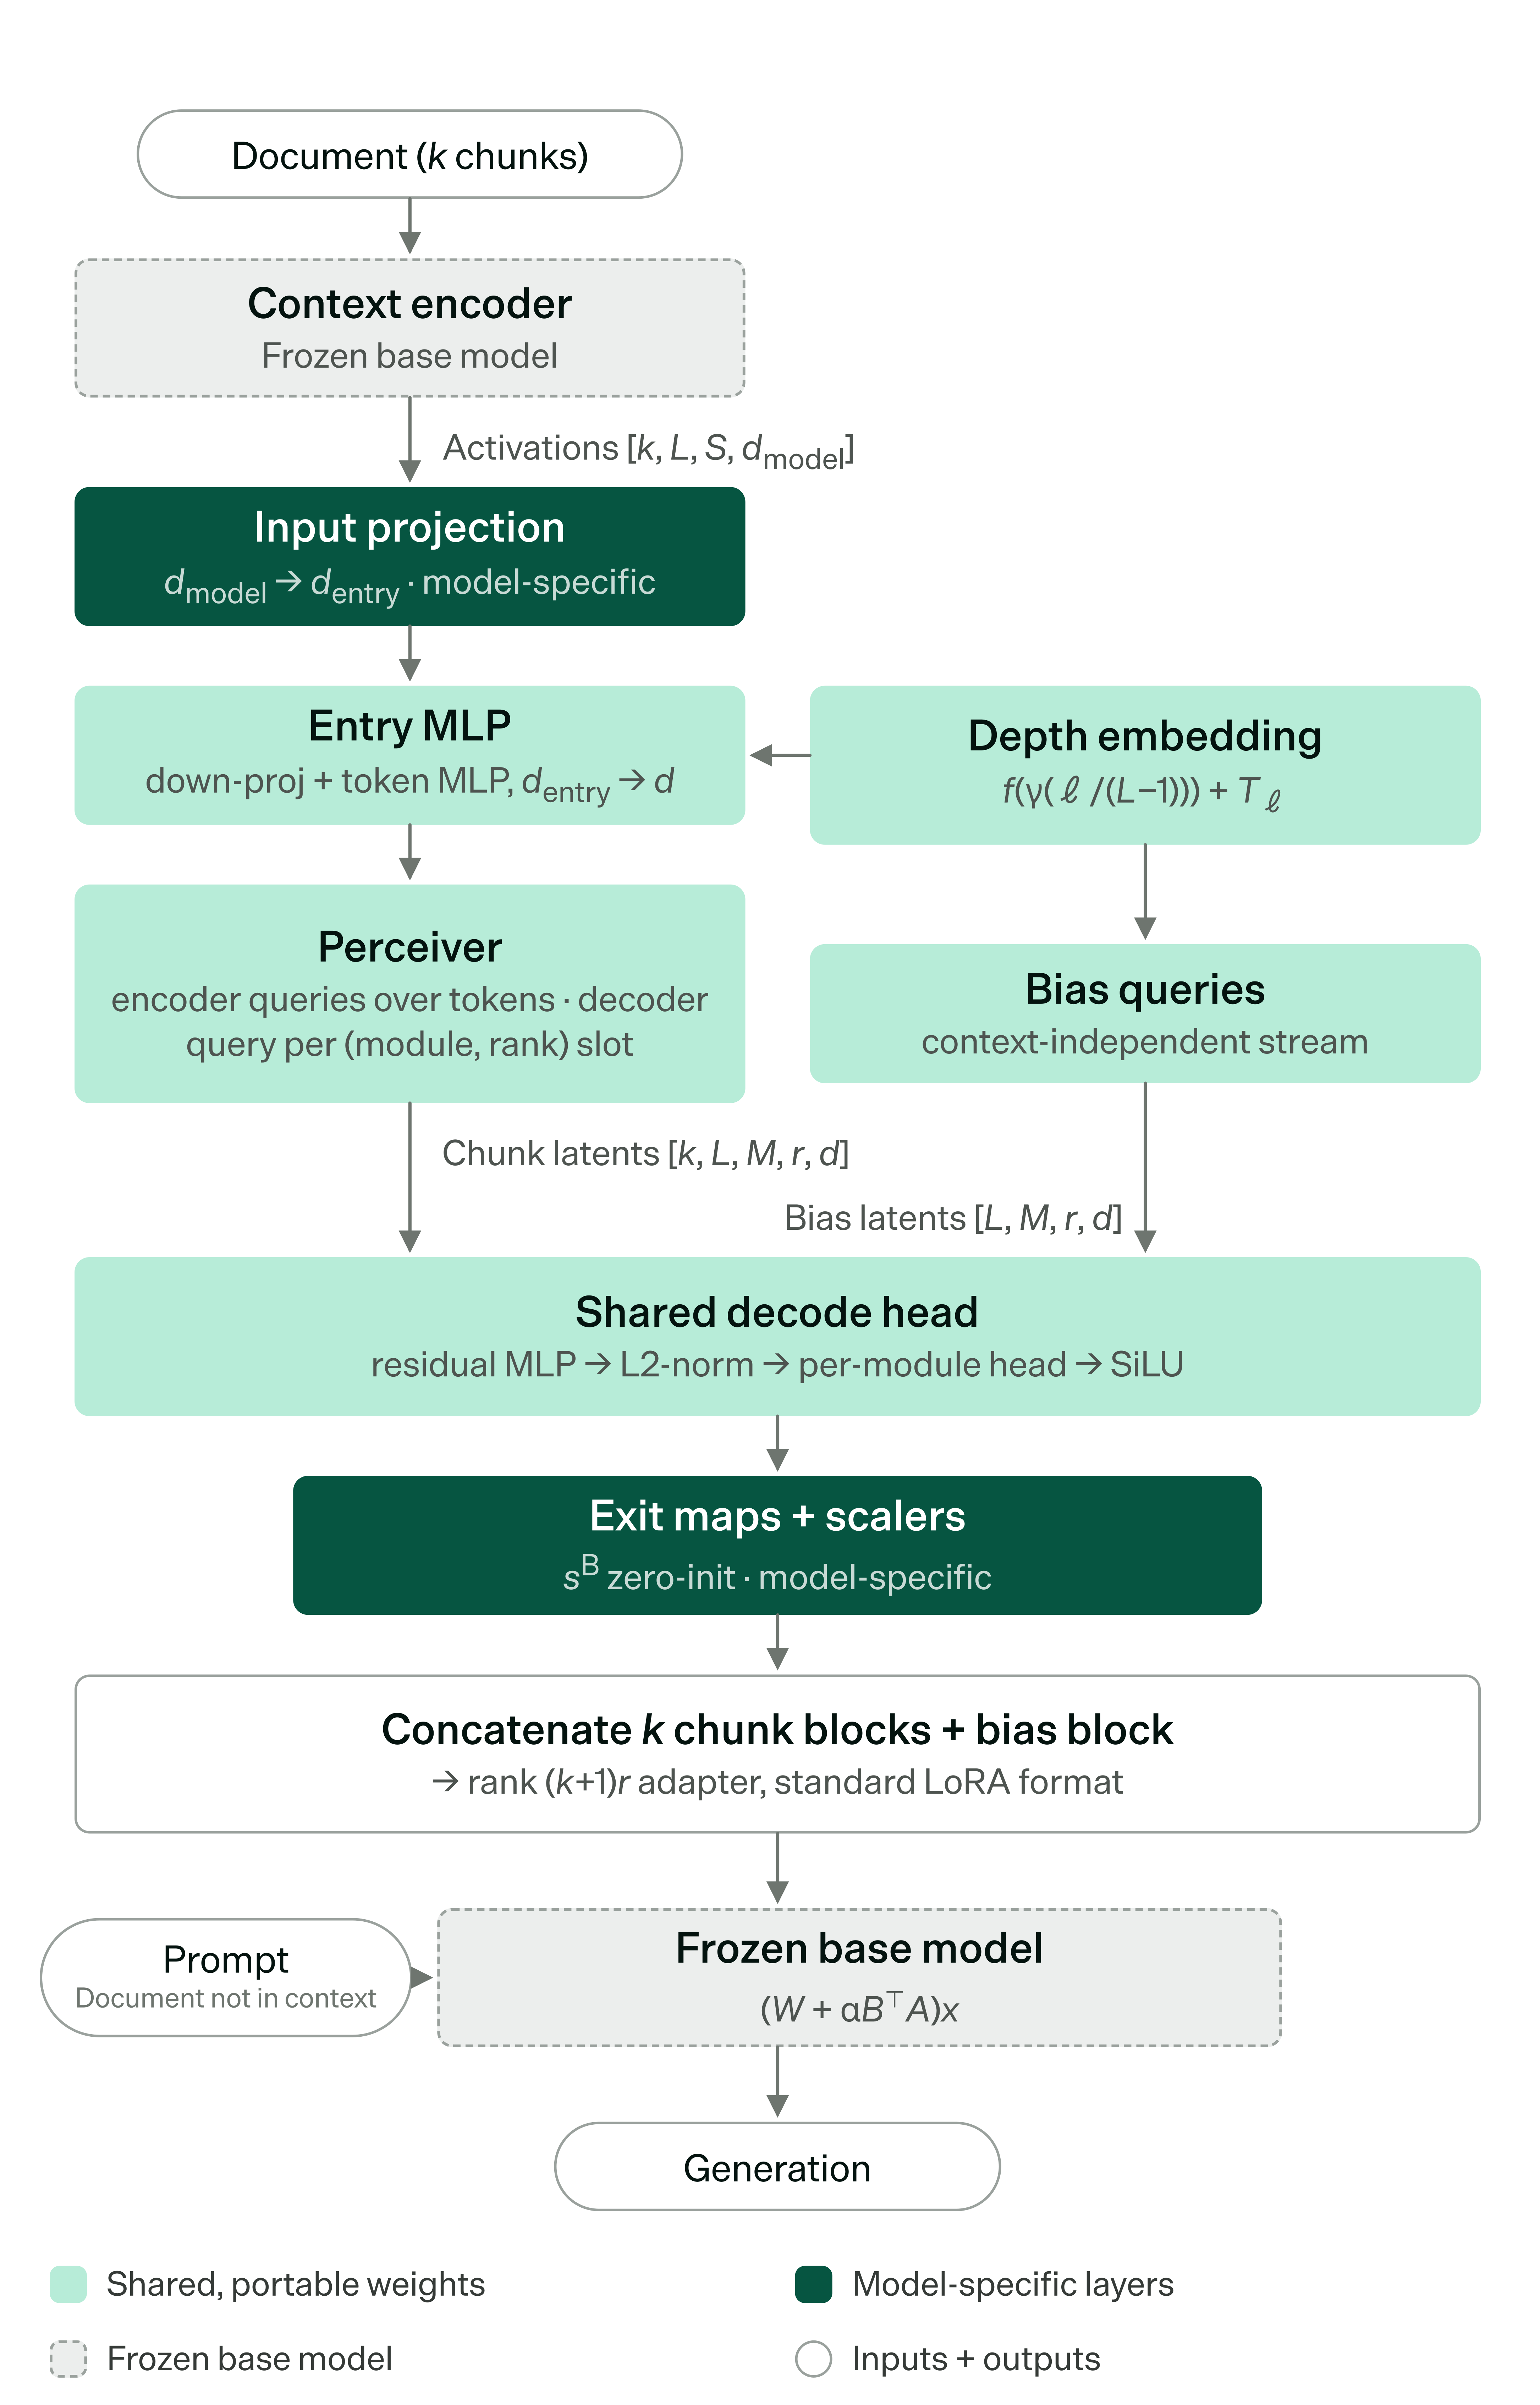
- 1
用冻结目标模型读带位置标签的文档块
英文FinePDFs文档切成最多512-token连续块,加入文档与块索引并包装为目标模型的用户轮。逐层激活先经模型专属投影升到8192,再由共享投影压到1536,加入相对层深Fourier编码及小型专属偏置表。
- 2
共享Perceiver把每层每块压成LoRA槽
256学习查询经过九组交叉/自注意力,再由每模块每秩槽的解码查询产生向量。只作用于MLP的up、gate、down三投影;MoE目标选择每token都经过的共享专家,不改注意力或路由专家。
- 3
分开生成上下文块与一次性偏置块
每块生成rank16更新,另用不读文档的bias查询生成一个公共块,避免公共成分随块数重复。共享解码头经模型专属出口投影产生A/B行,B缩放零初始化使起点不改变基础模型。
- 4
沿秩拼接并保持更新尺度
k个文档块加一个偏置块形成16(k+1)秩。ΔW=αB转置A,α直接乘更新而非通常α/rank;接入标准LoRA实现时必须匹配缩放,否则长文档行为会变化。
- 5
先小模型重建训练,再移植大模型
固定指令要求重现文档,教师强制交叉熵加错误token加权项,只训练超网络。五个1–3B模型共享主干做十二阶段长度课程,再给DeepSeek目标新建投影,先冻结主干适配、后全部解冻;基础模型权重始终冻结。
实验与证据
完整阅读58137字符全文和参考文献,公开版本无附录;视检原图1,核对训练阶段、完整长度表与作者机构网站。未运行训练或复现实验。
来源证据三集合、五个≤4096长度桶宏平均top1为84.9%,基础63.4%;top5 97.8%对83.5%,困惑度约1.7对5.6。 表1、第5.3/6.1节 ↗
我的解读每token条件包含正确历史前缀,不能说窗口始终只有三个词;这里没有证明从零自由生成整篇文档,也不是问答准确率。
来源证据4096长度单点top1:FinePDFs常规80.2%、长文82.0%、PG19 74.1%,相应基础61.7/64.6/60.0%。 表1 ↗
我的解读摘要宏平均受较短、较容易长度桶影响;跨域叙事文本的压缩收益更弱。
来源证据8192长度收益只剩0.3–3.1个百分点;16384长度top1为24.6/25.4/22.0%,困惑度2724/2276/1978。 表1、第6.2节 ↗
我的解读扩大rank到272或528不等于稳定扩展容量,超过训练八块后发生明显分布外失效。
来源证据常规FinePDFs从100文档缩到4096时41篇、16384时17篇;另32篇长文集合各长度固定,PG19最高桶91篇。 第5.1节、表1 ↗
我的解读长度曲线部分混有样本组成改变,固定长文集合是更干净的长度控制;这些桶不是独立新文档。
来源证据适配器监督还含chunk标签及轮结束,约比基础纯文本评分多1.5%token,基础对照没有聊天模板。 第5.3节脚注 ↗
我的解读两种评分跨度与模板并非完全一致,需更严格模板匹配对照后才能把所有差值归因于文档内化。
来源证据64-token迁移实验暖启动两组预算内超过90%,直接在大模型从头训练未超过75%;长4096阶段短暂冻结主干帮助不明显。 图3、第6.3节 ↗
我的解读支持短文本下共享主干迁移,不能将它推广为所有长文档只训薄投影就足够。
来源证据大模型移植使用64 H200、约三天、ZeRO3,FP8检查点先反量化成BF16。 第4.6节 ↗
我的解读约4608 GPU小时只是该阶段量级,尚不含小模型预训练;“便宜”是相对从头大模型训练的主张,而非轻量本机成本。
来源证据速度模式去掉原文、准确模式保留原文加适配器,以及问答/代码/表格任务均列未来工作。 第7节 ↗
我的解读不能把设想写成已测得的部署收益;284B对14B约20.3倍,也不是两个数量级。
开放情况与使用许可
论文与作者机构网页可访问,全文没有提供该方法代码/权重链接,本轮检索未核实公开实现或模型卡。未来工作和产品愿景不能视作已经交付的模型。
LICENSE论文原图为arXiv非独占托管许可,仅用于方法评论;SVG栅格化并铺白底。代码和权重未核实,不能由基础模型开放推断该超网络许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
分块秩增长和共享主干设计清楚,三文本集合完整表格展示训练范围内的重建收益。
64-token迁移对照中冻结预训练主干也能超过90%准确率,支持共享部分确实承载可迁移能力。
反方 · 哪些结论还不够
84.9%宏平均包含256到4096五个长度,并非4096长度单点;教师强制提供正确前缀,不能等同自由生成准确率。
16384-token时准确率22–25%、困惑度上千,增加适配器秩并没有自动获得长上下文泛化。
大模型阶段仍用64 H200约三天,最终解冻主干;没有服务时延、总成本或真实任务对比,商业效果尚未验证。
综合判断
该工作主要证明上下文到参数超网络可扩展到很大的目标模型,并有从小模型共享主干迁移的迹象。它仍是重建预训练研究,尚不足以声称替代RAG、长上下文问答或每任务微调。
我会先做的验证
建议实验,未执行:固定模板和监督token,增加自由重建、随机事实检索、引用与文档问答;比较全文上下文、RAG和逐文档LoRA,计入目标编码、适配器存储/加载和多查询摊销成本,并测8192以上训练后的稳定性。