IQuest-Q1:把架构稳定性、工具强化学习与多专家蒸馏串起来
320B 总参数、15B 激活,工程优势能否跨评测框架成立?
技术报告把 StableSplitNorm、Muon/μP、长上下文中训练、多工具环境强化学习与多专家在线蒸馏组织成完整训练链。值得关注的是训练与部署的系统配合,而不是把单项榜单领先解释为普遍最强。
图解主要方法
320B 总参数、15B 激活,工程优势能否跨评测框架成立?
- 1
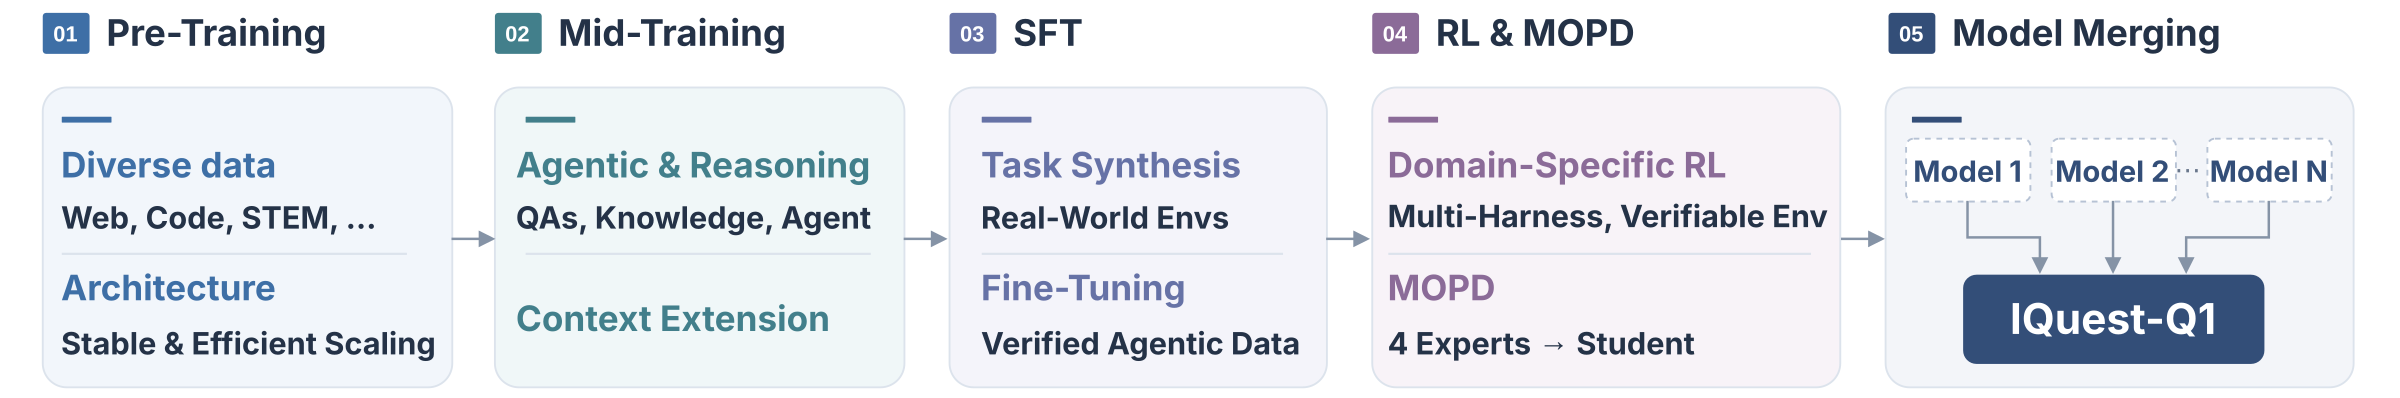
图2第一段:先稳定扩大稀疏模型
模型有88层、256个路由专家、每token激活8个;StableSplitNorm规范化注意力分支而保留FFN恒等残差。Muon配合μP在小宽度/深度代理模型上调学习率,再迁移至320B模型,减少大规模试错。
- 2
图2第二段:代码与长上下文逐步增加
预训练与中训练共29T token,代码比例由40%升至70%,上下文由32K扩展到128K、512K。两阶段SFT再引入工具轨迹及真实验证环境,不能把512K窗口长度直接当作所有长文任务的可靠检索率。
- 3
图2第三段:环境奖励与专家反馈合流
强化学习跨Claude Code、Codex、OpenCode等工具框架,控制奖励漏洞;四个冻结领域专家为学生自己的轨迹提供对数概率差反馈,最后校准参数增量再合并模型。其闭环仍包含人工问题诊断与授权训练。
- 4
推理端:递归草稿与工具解析
训练时两个多token预测层在推理时化为一个递归草稿模块。工具调用还依赖专用解析器;吞吐要连同批量、硬件、推测接受率和真实工具等待时间一起测量。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据同训练数据条件下报告1.93倍计算效率;约12T的临界模型规模来自外推。 §2 架构受控比较 ↗
我的解读这是损失—计算缩放结果,不能解释成任务正确率翻倍,也不是已经训练12T模型。
来源证据SWE-bench Pro为57.5,Terminal-Bench 2.1为83.2,但Terminal-Bench 4.0为22.7。不同任务采用不同agent及时间预算。 Table 2 与评测附录 ↗
我的解读跨框架结果不一致,发布时不能只抽取最强列;长时工具任务需要固定版本和预算。
来源证据报告一个由人工诊断工具schema偏差后追加2.35B token、约938.7 GPU小时训练的案例。 自改进案例 ↗
我的解读支持模型辅助工程改进;没有证明无人干预、自动递归自我升级。
开放情况与使用许可
已核对HF实际权重分片与模型卡。许可证为Modified MIT:商业产品或服务UI须显著展示IQuest-Q1,不能写成无附加条件的MIT;训练数据完整开放未确认。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
公开报告提供架构、训练配比和工具评测条件,便于拆分“模型能力”和“agent工程”的来源。
反方 · 哪些结论还不够
公开基准与作者复测混合;部分内部任务不可独立核验。320B总权重的存储与多卡部署成本不能用15B激活参数替代。
综合判断
适合作为稀疏模型训练与工具链协同的技术样本,选型仍需自有任务的同预算复测。
我会先做的验证
未执行的验证方案:固定同一工具框架、超时、推理强度和GPU,比较SWE任务成功率、工具schema错误率、峰值显存及端到端成本。