KEEP-Bench:压缩后答对,不代表证据没有丢
如何检查歧义分支、适用条件和少数观点是否仍在摘要里
KEEP-Bench不只看压缩后的问答正确率,而是逐条检查必要命题能否从压缩文本推出。4102个案例覆盖平行推理链、带条件的事实和文本占比很低但仍必要的观点。最强受测模型也只在约三分之二案例中保留全部证据,说明上下文能装下不等于摘要能忠实保留。
图解主要方法
如何检查歧义分支、适用条件和少数观点是否仍在摘要里
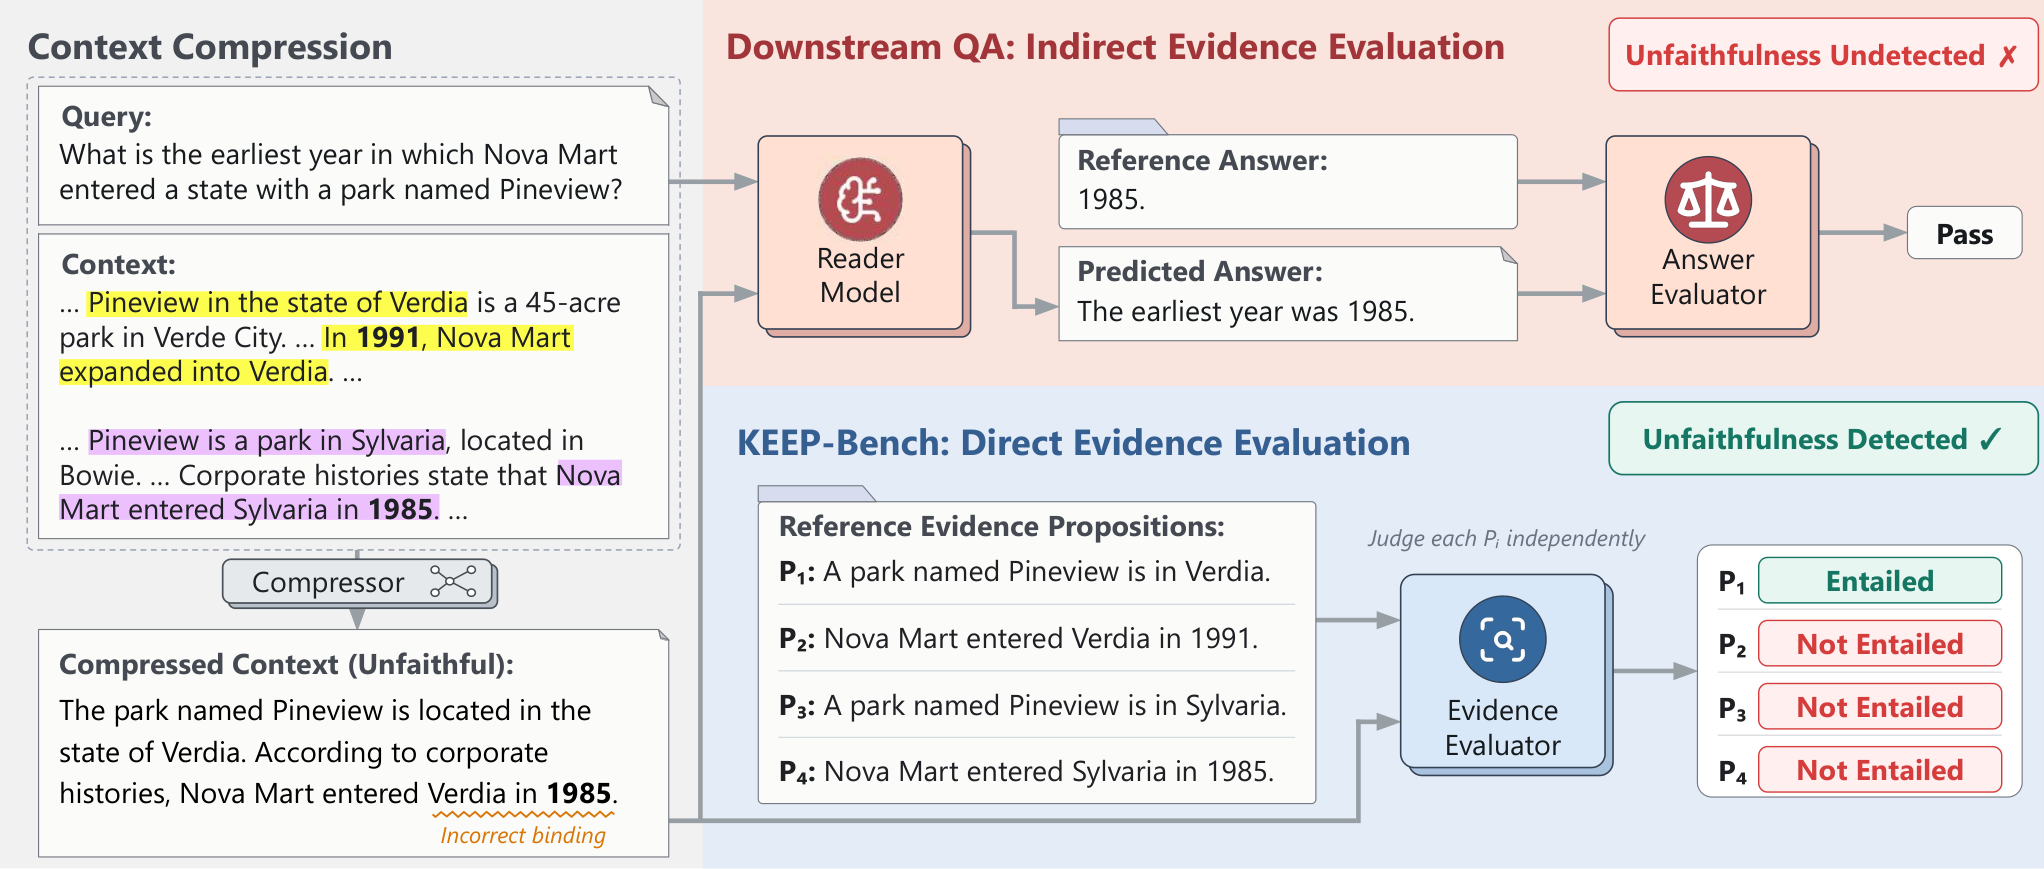
- 1
图1:把答案检查改成命题检查
为每个问题列出最小、自包含证据命题。压缩结果必须保留主体、条件和关系,不能仅保留最终答案。图中把两地公园和年份错误绑定仍能答对最早年份,但逐命题检查会发现缺失与错配。
- 2
分别制造三种证据瓶颈
900个平行案例虚构实体、保留两条互不重叠的多跳链;1364个条件案例让某一跳只在明确条件下成立;1838个不均衡案例用检索段落支持主要观点,将每个少数观点压成一条有来源的句子,全部人工审核。
- 3
固定预算后做蕴含判断
默认多跳案例给2h句、n观点案例给2n+1句,使用示例和针对性指令。GPT-5.2 high逐命题判断,全部成立才计All-Rec;条件判断要求条件与命题共同成立。该指标测完整性,不是平均命题召回率。
- 4
把保留率与压缩成本分开
EPR=6乘以All-Rec百分数除平均TFLOPs的平方根,ICL公共前缀成本摊销。它是架构矩阵计算量估计,不含判断器、预处理、批处理等,也不是延迟、电费或端到端RAG收益。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据17种配置,平均原文3063token。Gemma-4-31B-it总体All-Rec66.8%,Claude-Haiku-4.5为61.6%;专用压缩器均低于10%。主实验统一ICL且关闭thinking。 主表与预算协议 ↗
我的解读不是所有模型各自最优配置:附录中较小Gemma往往无ICL并开启thinking更好;专用RECOMP-abstractive也不受同样长度控制。
来源证据筛选至少存在一份忠实压缩的200个二/三跳问题,原文双答案正确率94%,忠实压缩96%,不忠实11.5%。同一问题的两份压缩可能来自不同模型。 附录A下游试验 ↗
我的解读支持证据丢失与任务失败有关,但筛选后的试验并非所有真实检索任务的因果效果估计。
来源证据300次命题判断人工一致率93%,条件类91%。400个二跳问题构造14种位置排列,多数条件下靠前证据更易保留,但Gemma-E4B在最远两端出现反向例外。 附录D与位置实验 ↗
我的解读自动judge仍有误差,All-Rec要求全对会放大其影响;不能把位置趋势表述成所有模型必然单调退化。
开放情况与使用许可
2026-10-21核验GitHub实际压缩和评分脚本及MIT LICENSE;HF存在四类测试JSONL,数据卡为CC BY-NC 4.0并限制非商业研究、网页摘录单独再分发及评测模型训练。论文为arXiv非独占许可,所引图1仅作必要研究评述引用。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将“答案仍能猜对”与“推理证据仍完整”分开,尤其适合评估长任务摘要和RAG中容易被压掉的条件、分支及低频信息。
反方 · 哪些结论还不够
三类人为控制结构、短上下文和单次judge限制外推;主要测试必要信息召回,不是所有新增幻觉的全面检测。总分依赖命题粒度和严格全保留规则,成本不含下游读者。
综合判断
是有价值的压缩回归测试集,应结合事实精确率、真实任务和端到端成本使用,不能只凭EPR选择生产压缩器。
我会先做的验证
未执行的验证方案:固定最终token预算比较摘要器,以双人盲审检查条件与实体绑定;加入自然长会话、反证和新增幻觉,再测下游成功率、总延迟及包含judge的总成本。