L2-SmoothRot:量化误差中,哪些能补偿、哪些不能
用正交残差解释随机符号旋转,再检查困惑度与任务准确率的分歧
这篇论文把线性层量化误差拆成可通过权重补偿的部分与正交残差,据此组合 L2 通道缩放、带随机符号的在线旋转和候选筛选。其 W4A4KV4 模拟结果改善困惑度,但不在所有模型上提高下游准确率,也未测实际部署加速。
图解主要方法
为什么权重量化补偿仍会留下误差,原图 1 的候选筛选又解决什么?
- 1
先保持未量化线性映射等价
对 Y=XWᵀ,引入可逆变换 P,使 Z=XP、V=WP⁻ᵀ,未量化结果不变。P 组合通道缩放、随机符号和 Hadamard 旋转;量化发生在变换后的激活与权重上,目的在于改变数值分布而不改变原始函数。
- 2
将误差分成可补偿项与正交残差
量化激活 Ẑ=Z+A 后,可在 Ẑ 的列空间内调整目标权重,得到激活引导的补偿目标 V*。但 (I−Π_Ẑ)AVᵀ 落在该列空间之外,固定变换下再优化权重也无法消除。这解释了为何改进 GPTAQ 的权重补偿仍需要同时控制激活误差。
- 3
用随机符号削弱持续通道离群值的叠加
固定 Hadamard 变换可能让多个跨 token 持续出现的离群通道相长叠加。随机 ±1 符号使交叉项在期望上抵消,理论还给出高概率界。论文的离群值与常规部分分析属于误差上界,不应说成又一次完全精确的误差分解,更不保证单个随机种子一定更好。
- 4
L2 缩放平衡激活和权重的通道能量
通过 Frobenius 范数代理得到与激活、权重列 L2 范数相关的平方根缩放;实践中主要用于 FFN down 投影,并融合到相邻运算。在线符号旋转还覆盖注意力输出、FFN down 与 RoPE 后成对的 Q/K;后者在未量化时保持点积不变。
- 5
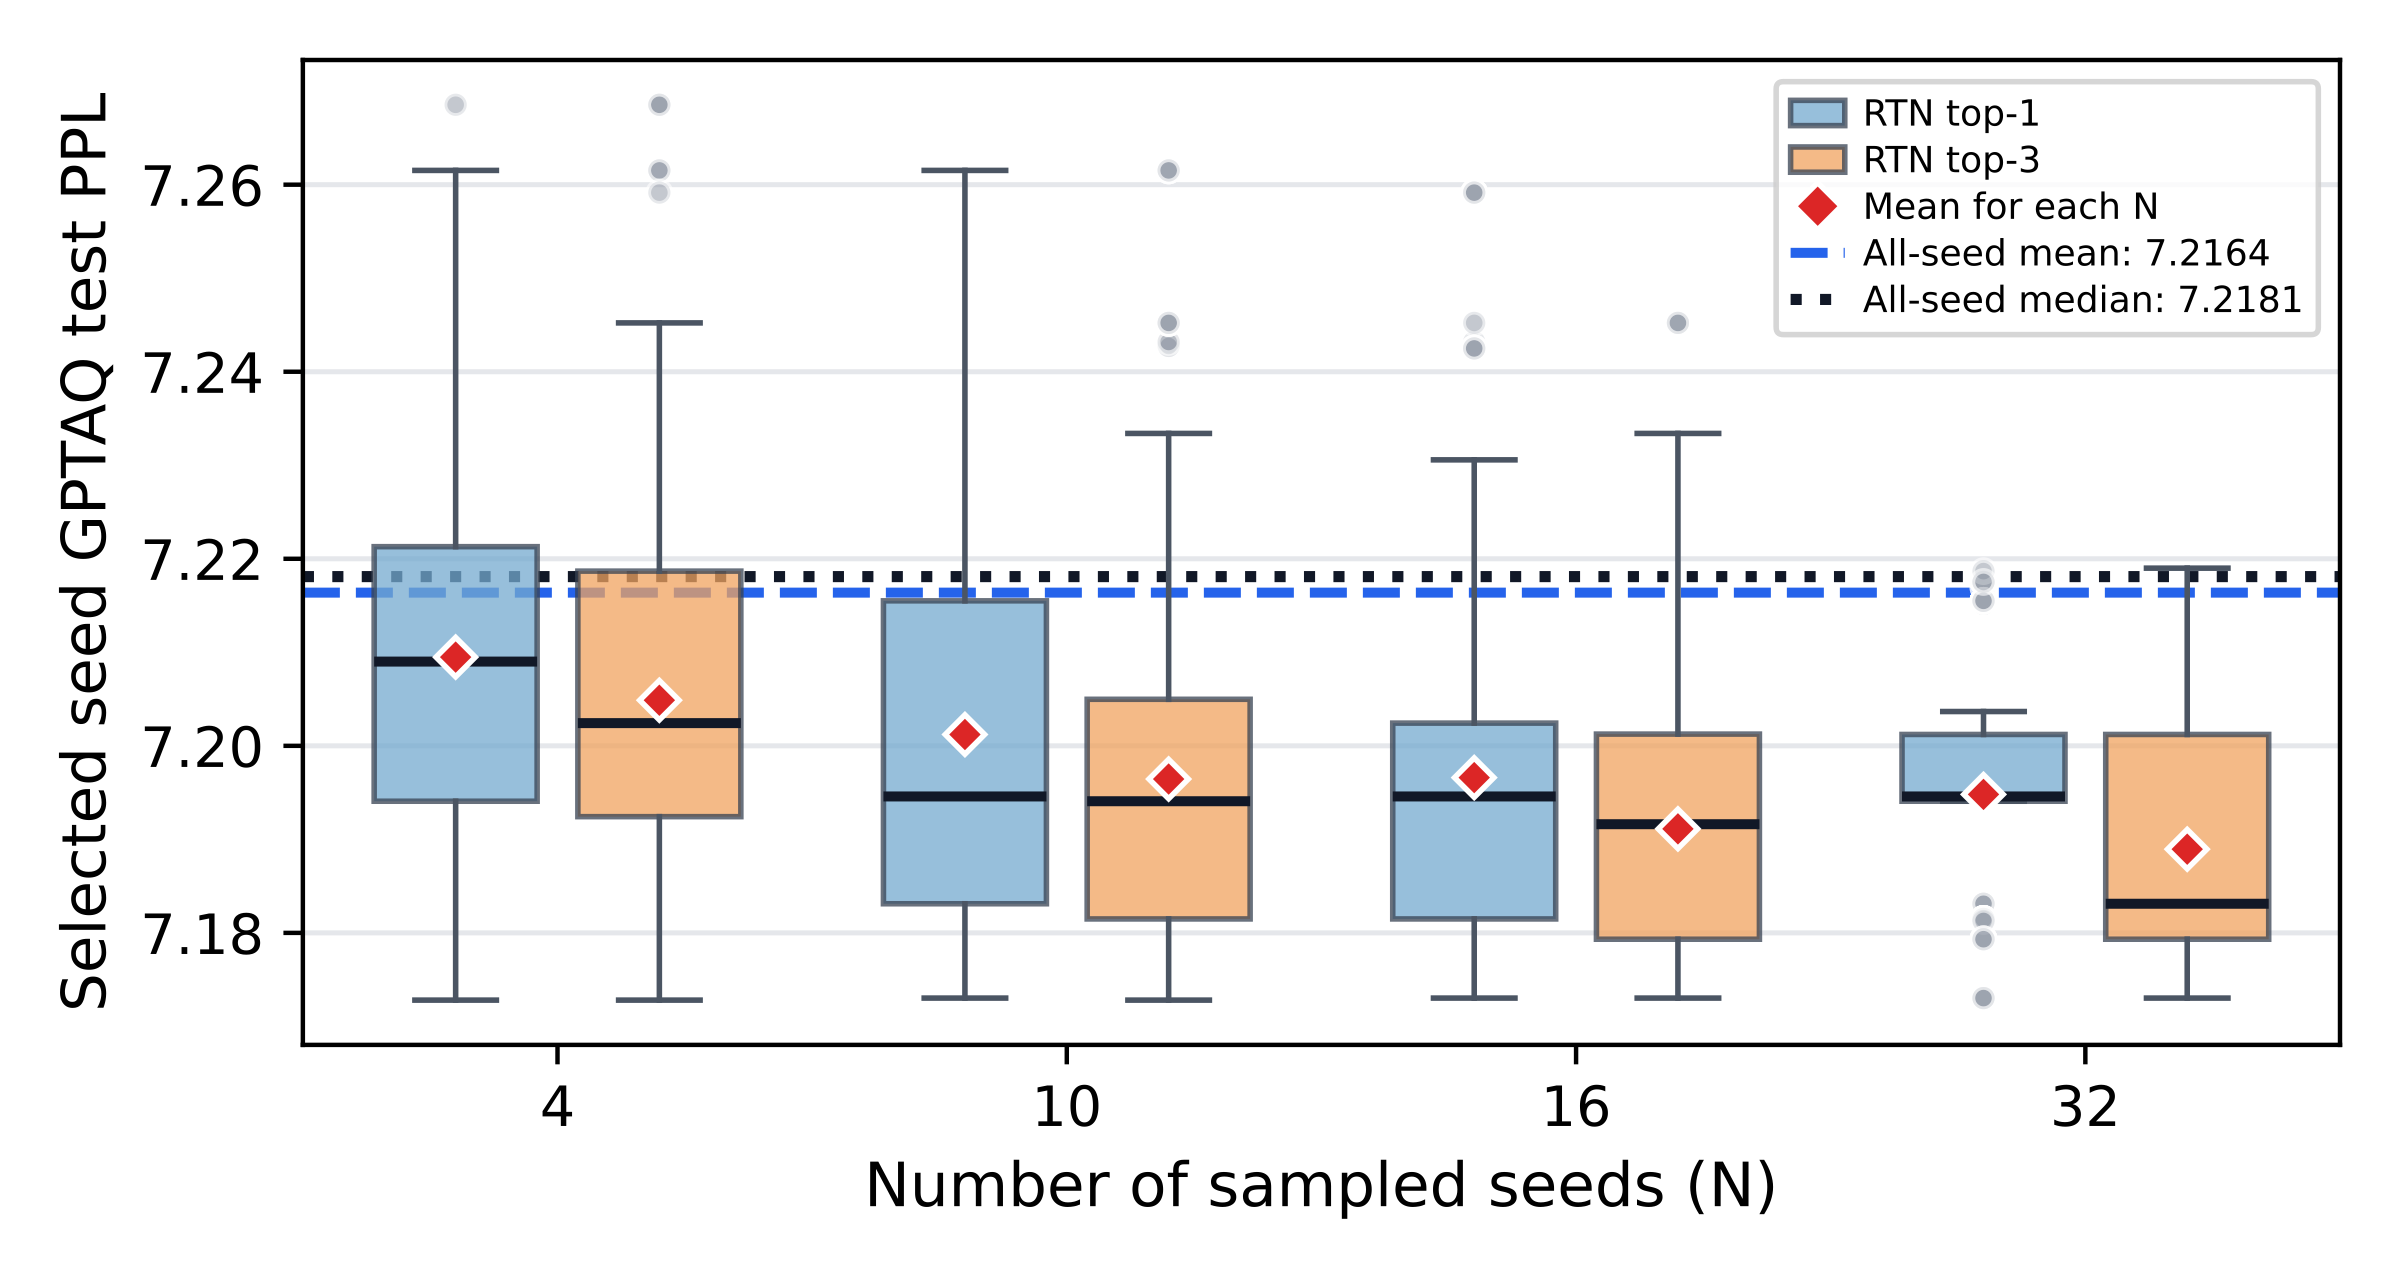
图 1:便宜预筛后,再用完整量化重新排名
图是消融结果,不是架构图:横轴候选种子数量,纵轴选中种子的 GPTAQ 测试困惑度,越低越好。标准流程采样 10 个候选,以 RTN 预筛前三,再做 GPTAQ 并按验证困惑度选取。橙色 top-3 的优势说明廉价代理与最终量化排名并非完全一致;没有反向训练仍需多次校准计算。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【§5.1】八个 Llama/Mistral 模型进行 W4A4KV4 模拟;权重逐通道、激活逐 token,激活与 KV 有裁剪,GPTAQ 用 128 条校准样本,缩放用 512 条。 §5,实验设置 ↗
我的解读实验存在裁剪和上游误差传播,而局部理论有更理想的条件。数学解释与端到端结果应视为不同层级证据。
来源证据【表 1】所有八个模型的 WikiText-2/C4 困惑度最低,但六项零样本任务的平均准确率仅五个模型最优。Llama-3.2-3B 为 60.94%,SpinQuant 为 62.03%,全精度为 68.20%。 §5,表 1 ↗
我的解读不能用困惑度全面改善替代任务质量结论。量化选型必须保留具体模型与下游任务。
来源证据【表 2 与图 1】Llama-3-8B 的组合消融由 QuaRot 7.45 到完整方案 7.20;候选池扩大通常改善选中结果。 §5,消融 ↗
我的解读这些是精度与搜索预算的关系,论文没有提供同条件硬件吞吐、延迟、实际显存的数据,不能声称部署提速已验证。
开放情况与使用许可
已读正文及附录 A–C;未找到可确认的作者实现或发布权重。
LICENSE论文 CC BY 4.0;软件开放范围待确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
正交残差分析指出“继续优化权重仍修不回来”的部分,使通道缩放与旋转的作用更容易归因。
反方 · 哪些结论还不够
任务准确率反例与未提供部署时延,限制了其工程收益结论;候选数量增加还会改变校准预算。
综合判断
理论与量化精度证据值得读,实际部署收益仍待验证。
我会先做的验证
未执行的验证方案:固定模型与校准数据,分别移除缩放、符号旋转和 top-3 重排;在分布外任务上测精度,并使用真实低比特内核记录校准时长、首 token、吞吐和峰值显存。