Lapras:传感器语言模型能否先在连续空间推理,再给文字答案?
六个潜在步骤自蒸馏;效率收益明确,可读解释仍缺忠实性验证
Lapras让时间序列语言模型学习显式推理教师在答案位置的隐藏状态,推断时用六次连续向量反馈代替长段文字推理。它在多种传感器分类问答上减少生成成本并提升若干骨干的平均F1,但不是每项任务都获益,事后读出的文字也尚未证明就是模型真正依赖的因果依据。
图解主要方法
传感器信号的语言描述会丢信息,能否从文字教师学习却在推断中保留连续计算?
- 1
传感器编码沿用骨干现有通路
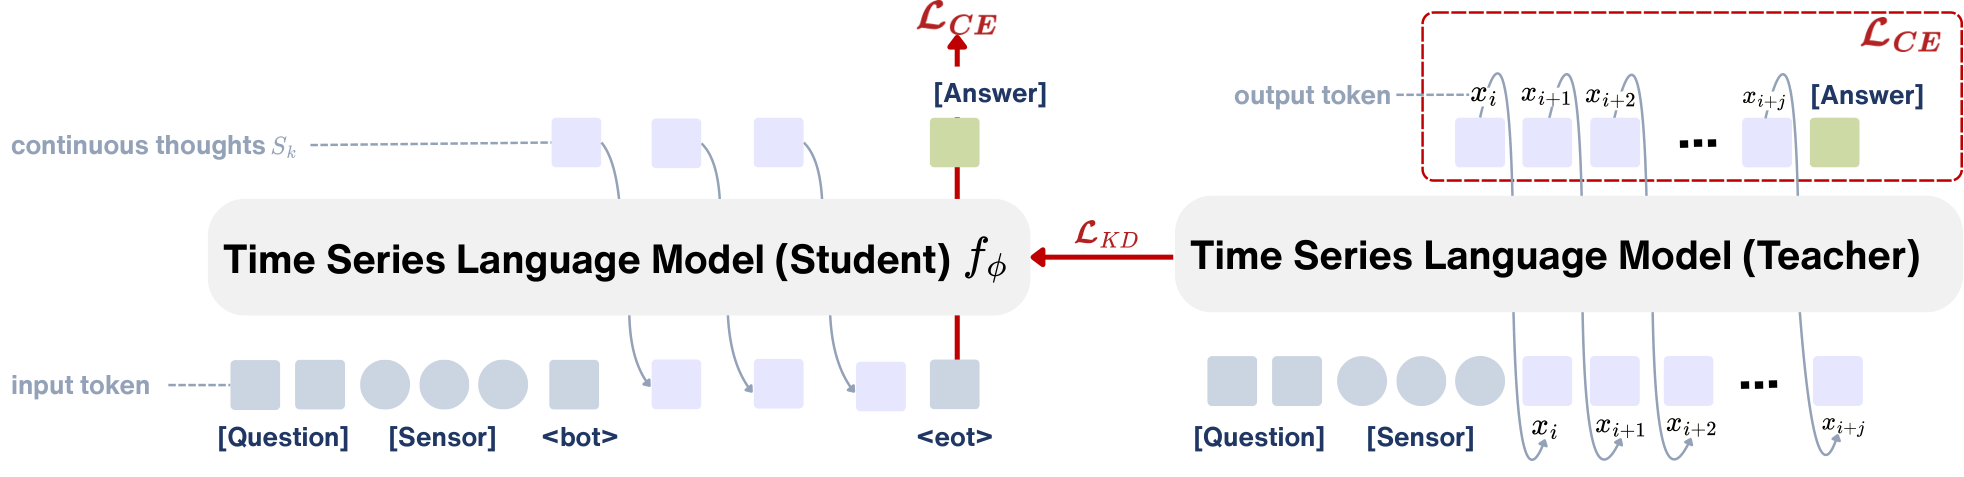
图3输入包含问题和Sensor表示。ChatTS将每个通道分块后作为token拼接;SLIP和OpenTSLM经固定查询压成64个表示,再交叉注意进入语言模型。Lapras不把原始数字统一强制写成文字。
- 2
教师读取参考理由,学生只做连续反馈
教师与学生共享参数,训练教师读取参考CoT与答案。学生在bot标记后,将最后隐藏状态通过小MLP投影回输入空间,连续执行默认六步,不在中间采样文字token;eot后才生成最终答案。
- 3
在首个答案预测位置对齐各层状态
图3中KD损失把学生答案锚点各层隐藏状态拉向教师的对应状态,对教师目标停止梯度;另有教师理由加答案交叉熵和学生答案交叉熵。它不要求六个潜在步骤逐一对应六句话。
- 4
联合训练并遮挡部分传感器patch
总损失为学生答案项、蒸馏项和教师项,教师权重1,蒸馏权重按任务取1/10/20;训练默认遮挡30%传感器patch。完整微调,最后检查点评估,不靠测试挑最佳轮。
- 5
推断仅保留学生,解释额外读出
正式推断先六步连续计算,再文字答案。作者另用共享语言头从连续状态贪心解码,展示可读片段;这是诊断读出,不能自动认定它等于决策所依赖的真实中间推理。
实验与证据
完整阅读73377字符论文、参考文献和附录A–G,视检图3,核对GitHub实际实现、模型卡、文件清单、运行配置与分目录许可。未下载128GB全套权重或运行传感器评测。
来源证据五测试集分别ECG643、Sleep923、HAR8222、TSR4094、Engine193例;每任务分别微调,全部转为二分类或多选答案。 表4、模型卡 ↗
我的解读模型卡也说明每个检查点只负责自己的任务,不能当作一套模型跨全部传感器任务即插即用。
来源证据所有方法同骨干同轮数与学习率,batch128、4张H200、bf16、AdamW、ZeRO2;贪心解码最多512个新token。 附录D ↗
我的解读同轮数不等于同训练FLOPs,教师分支和六步循环有额外训练成本;推断省token的收益应与训练投入分开。
来源证据ChatTS表中CoT平均F1 57.73、Lapras68.52;SLIP57.63→62.70;ITFormer44.15→44.03。 表1 ↗
我的解读前者提高10.79个百分点,而非相对10.79%;“所有骨干都优于CoT”与最小骨干表格不符,采用数值而非笼统主张。
来源证据SLIP Engine No-CoT为准确率37.82/F1 34.02,Lapras38.86/26.49;去mask时TSR准确率69.17还高于默认67.32。 表1、表3 ↗
我的解读平均改善掩盖任务与指标分歧,不能把每个组件宣称为所有任务都必要。
来源证据单A6000、SLIP1B,生成token减少6.9–23.9倍,时延加速5.9–15.1倍;相比No-CoT额外开销小于8毫秒。 图6 ↗
我的解读数字是该硬件、骨干和测量设置,六次连续前向仍需计算。23.9倍token压缩不等于任意设备23.9倍速度。
来源证据用训练时K=6的模型推断,K=1/6/8平均准确率64.82/68.38/68.07;去投影或去蒸馏为62.23/64.34。 表2–3 ↗
我的解读支持默认循环和蒸馏组合,K扫描同时有训练推断不匹配,不能据此推出普遍最优推理步数。
来源证据代表性TSR样例第一层传感器注意份额CoT3.39%、Lapras17.35%;logit-lens另示例显示更迟形成高置信答案。 附录E–G ↗
我的解读这是个案诊断而非全测试集因果证明;注意份额受上下文长度和归一化影响,可读解释需额外忠实性干预检验。
来源证据论文ChatTS7B表格与发布模型卡ChatTS8B列出相同结果,公开实现仅三骨干、15任务检查点。 论文表1、官方README和模型卡 ↗
我的解读版本命名差异未被独立澄清;复现时应固定具体检查点哈希,不默认为代码与论文四骨干完全一致。
开放情况与使用许可
2026-10-11核对yuc0805/Lapras提交b840a6da018798bf1f0668c1a03f251d44a4ea1f,含训练、评估和三骨干实现。HF提交9304c301c14aa70acac45863264808a95c961f52列出15个实际权重目录及投影文件。公开版本ChatTS写8B,论文表格写7B;发布未覆盖ITFormer,完整论文复现需核对该版本差异。
LICENSE论文与图3CC BY 4.0;项目Apache 2.0,第三方代码保留各自通知。chatts检查点Apache 2.0;opentslm和slip检查点遵守Llama 3.2 Community License及Acceptable Use Policy,不将其等同无限制Apache权重。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
训练目标与推断流程具体,公开了投影、任务配置和权重;去投影或去蒸馏消融明显降低平均准确率,支持连续步骤需要学习而非随意多跑几轮。
1B/较大骨干平均F1和单A6000时延均提供可比较结果,且保留No-CoT对照,避免只与长而弱的文字链比较。
反方 · 哪些结论还不够
论文摘要10.79%对应表中57.73→68.52,是10.79个百分点;最小ITFormer平均F1为44.03,低于No-CoT44.48,也略低于CoT44.15。
Engine上SLIP准确率38.86高于No-CoT37.82,但macro-F1为26.49低于34.02;准确率与类别平衡表现分歧不可省略。
知道正确答案生成的参考理由可能更容易给出答案;早答实验支持现象,但尚不能独立证明性能差异只来自离散语言瓶颈,事后文字解码也可能是合理化。
综合判断
有公开实现支撑的时间序列潜在推理方法,值得在相同骨干上复现效率与类别平衡收益。其解释性和“连续推理更忠实”的因果主张仍需要干预实验证据。
我会先做的验证
建议实验,未执行:固定模型版本、总训练预算和传感器mask,比较直接答、CoT与Lapras;报告多种子macro-F1、每类混淆矩阵、真实时延。对关键传感器片段和潜在向量分别置换,检验答案与解码解释是否同步响应,再检查原始/反事实成对样本是否跨训练测试泄漏。