Lafa:把连续流草稿交给模型自己的 AR 校验
块内连续去噪、块间因果缓存与自推测解码,如何兼顾质量和速度?
Lafa 将连续流语言模型扩展到7B和8B,在同一模型中联合学习块去噪和自回归预测。连续流负责批量提案,AR负责逐项验收,融合验证与下一轮起草减少前向次数。论文最高2.54倍吞吐来自单H100、batch1特定设置,公开权重目前为块长4,不能直接套用块长16的最高速度。
图解主要方法
块内连续去噪、块间因果缓存与自推测解码,如何兼顾质量和速度?
- 1
1 · 在词嵌入空间学习块内流
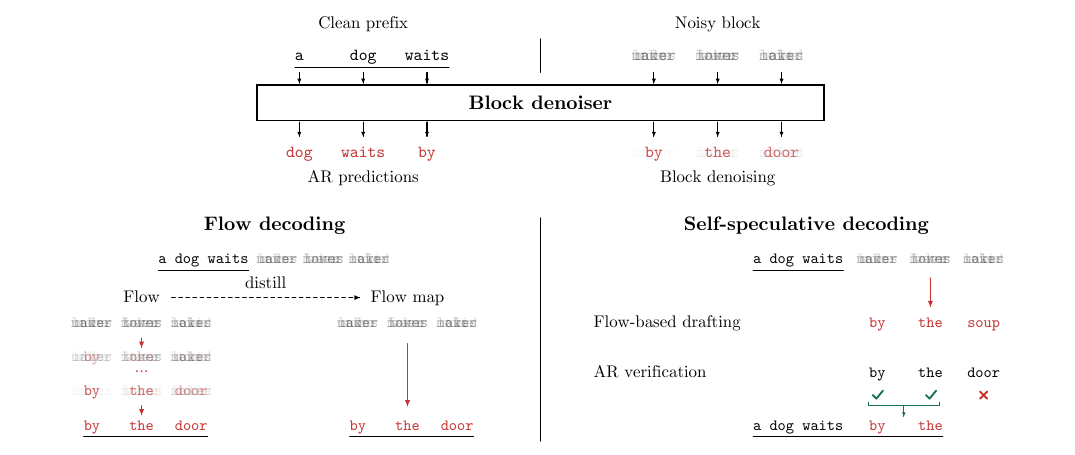
图2上部,干净前缀使用因果注意力,含噪块双向交互;各位置采用异步时间调度,较早token更快变干净,贴近语言从左到右的依赖。学习嵌入方向并固定范数,训练同时包含去噪交叉熵、嵌入MSE与前缀AR交叉熵。
- 2
2 · 保留可缓存的前缀
训练用干净与含噪双流掩码避免偷看其他目标块,时间条件经AdaLN注入。前缀时间固定,KV可跨轮复用;这与每次重做整段扩散不同,但上下文和块长仍受训练设置约束。
- 3
3 · 蒸馏 flow map 以快速提案
图2左下将多步流蒸馏为一到少步映射,使用对角一致性与半群组合约束。理论结论依赖零损失等理想条件,实际一步直接生成仍有明显质量差距,因此快速提案不等于最终可信文本。
- 4
4 · 融合验收与下一块起草
图2右下用同一检查点的贪心AR预测验收草稿最长匹配前缀,并把不同可能接受长度的后继块打包进一次前向。选择实际接受长度对应的草稿继续;保证针对的是适配后模型自身的贪心AR轨迹,不是原始底座或随机采样分布。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据7B块长4的六项均分60.9,对照AR SFT58.4;HumanEval却由78.7降到76.8。块长16均分58.0,8B块长4均分63.1对56.8。 表6、7 · 六项质量评估 ↗
我的解读多任务均值显示潜力,同时存在代码任务与块长增大的代价,不应称每项都提升。
来源证据单H100、BF16、batch1、32token预热,IFEval/GSM8K/HumanEval三项平均:AR39.5 token/s,块长4为79.9,块长16为100.2;后者约2.54倍,三项均分74.5对73.9。 表8 · 实际吞吐 ↗
我的解读这不是大并发服务吞吐,也不能用每次前向token数直接替代端到端token/s。
来源证据7B块长4的一步flow map三项均分49.0,而32步flow为75.2;公开0.5B、7B、8B检查点均为块长4。 表5与公开模型卡 ↗
我的解读一步模型适合作草稿;下载当前权重不能自动复现块长16最高加速点,须匹配发布配置。
开放情况与使用许可
已核查 large-flow-lms 的训练/推理实现与 Apache-2.0 LICENSE;所核 lafa-7B模型卡为 Apache-2.0、BF16、B=4,提供三种解码。最高2.54倍对应论文B16而非当前发布B4配置。
LICENSE论文与原图 CC BY 4.0;代码及所核模型卡 Apache-2.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
连续流与AR可以在同一骨干中互补,尤其适合对延迟敏感、允许同模型验收的生成链路。
反方 · 哪些结论还不够
训练9–27B token与部分扩散基线500B不是统一预算比较;只在Qwen适配、较短训练上下文及batch1上验证。公开B4权重与B16速度峰值要分开;无需外部草稿模型也不等于零额外计算。
综合判断
证据支持可用的质量—延迟折中,尚不能认定全面替代AR服务。
我会先做的验证
未执行的验证方案:以公开B4检查点在同一硬件比较贪心AR与自推测,逐token核对输出一致性;再测长上下文、代码任务、首token和P95延迟,记录显存及并发1/4/16的退化。