LEAP-CBF:用“最少破坏努力”衡量机器人安全余量
允许短时强扰动,但约束整段扰动的累计代价
LEAP-CBF 不只问每一瞬间扰动有多大,而是估计在固定后备策略下,把系统推向失败至少需要多少累计努力。这个值可指导切换和安全滤波;理论保证依赖精确势函数,学习到的近似值不能自动继承严格证书。
图解主要方法
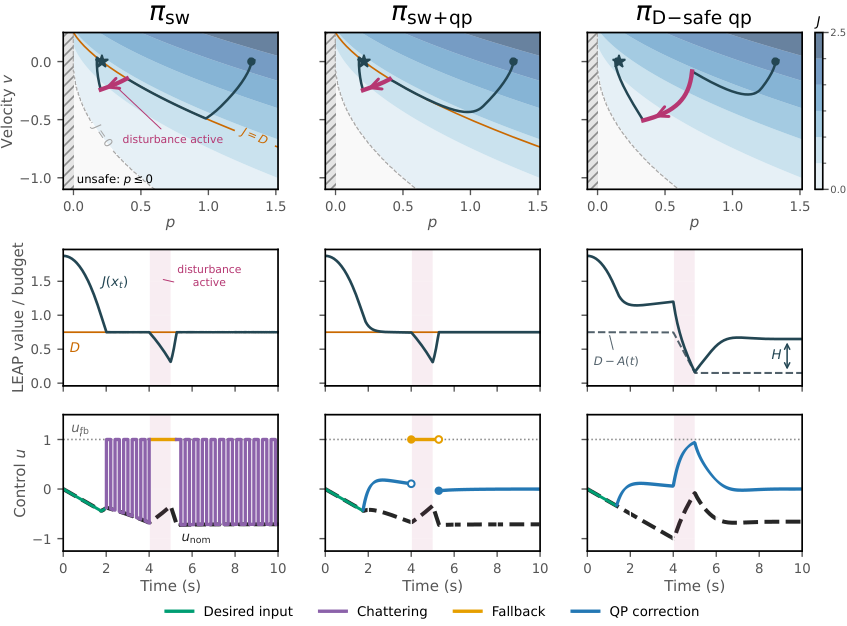
图 5 中三种控制器为何对相同扰动采取不同的介入方式?
- 1
定义在后备策略下到达失败的最低代价
J 表示对手要让系统离开安全集所需的最小累计扰动努力。与到障碍物的几何距离不同,它同时依赖动力学、扰动通道和固定后备策略;较大 J 表示对手更难制造失败。阈值 D 是整段轨迹允许的总预算。
- 2
先由切换控制守住预算余量
当势值接近阈值时切换到后备策略,离开危险边界再恢复期望动作。图 5 左列显示这种硬切换可能抖振;中列加入二次规划修正来平滑介入,同时保留需要时的切换。两者不要求实时观测累计扰动 A。
- 3
可观测预算时使用动态安全边界
图 5 右列的预算型 QP 用 J−D+A 构成屏障,A 是已经消耗的累计扰动努力,因此剩余门槛从 D 降为 D−A。这个更宽松的边界必须能追踪 A,不能在未知外力预算的部署中直接假设可用。
- 4
学习后备策略与势值,再区分经验和证书
高维实验交替训练 PPO 对手与后备策略,最后固定后备策略继续校准对手价值网络。神经网络估计与分类器是近似机制;精确 J 的理论安全性不等于未经形式验证的网络输出必然安全。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【受控仿真】每配置 200 个种子,扫描 20 个 D 值以及不同扰动代价参数;作者报告可在部分相同观测安全率下减少介入。 仿真实验与安全—介入曲线 ↗
我的解读我的解读:应同时画安全率与控制改动,而不是只挑一个较少干预的配置;零次观察碰撞也不是概率为零。
来源证据【解析机制例子】相同扰动下,切换型出现抖振,QP 加切换更平滑,预算型 QP 保持 J≥D−A。 图 5 ↗
我的解读我的解读:图示说明三种边界语义;后者的信息需求更强,不能把性能差异全部归于优化器更好。
来源证据【真机】Go2 与 Crazyflie 展示约 30 秒实验窗口下的扰动处理。 机器人实验与讨论 ↗
我的解读我的解读:真机展示支持可运行性,但不足以给出长时安全失效率;短时大扰动超出 HJI 的逐时界限也不是对 HJI 理论的反例。
开放情况与使用许可
论文及实验说明公开;未核实到本研究完整实现或权重。文中引用的 gcbfplus 等上游代码不能视为 LEAP-CBF 已发布。
LICENSE论文 CC BY 4.0;本方法代码与模型许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
累计努力能表达短促但强烈的扰动,将安全余量与具体后备行为联系起来,而非仅依赖距离阈值。
反方 · 哪些结论还不够
学习势值的误差、扰动代价标定和累计预算可观测性,决定理论能否落到实际机器人。
综合判断
适用于能明确失败集合、后备策略与扰动代价的控制问题;部署必须另测近似证书失真和传感延迟。
我会先做的验证
未执行的验证方案:在相同安全集和动力学模型下,分别对齐逐时与累计扰动假设;扫传感延迟、势值误差、预算估计偏差,报告碰撞上界、介入幅度和抖振,不能仅比较平均成功。