OnTrack:扩散语言模型应该在哪一步揭开哪些token?
正确的最终答案,并不意味着这个token现在就可以安全提交
在冻结LLaDA或Dream骨干的前提下,一个小策略网络选择每轮提交的位置。研究把监督标签与训练状态分开控制,发现沿参考轨迹可达的提交目标,比只看最终答案是否一致更可靠。
图解主要方法
正确的最终答案,并不意味着这个token现在就可以安全提交
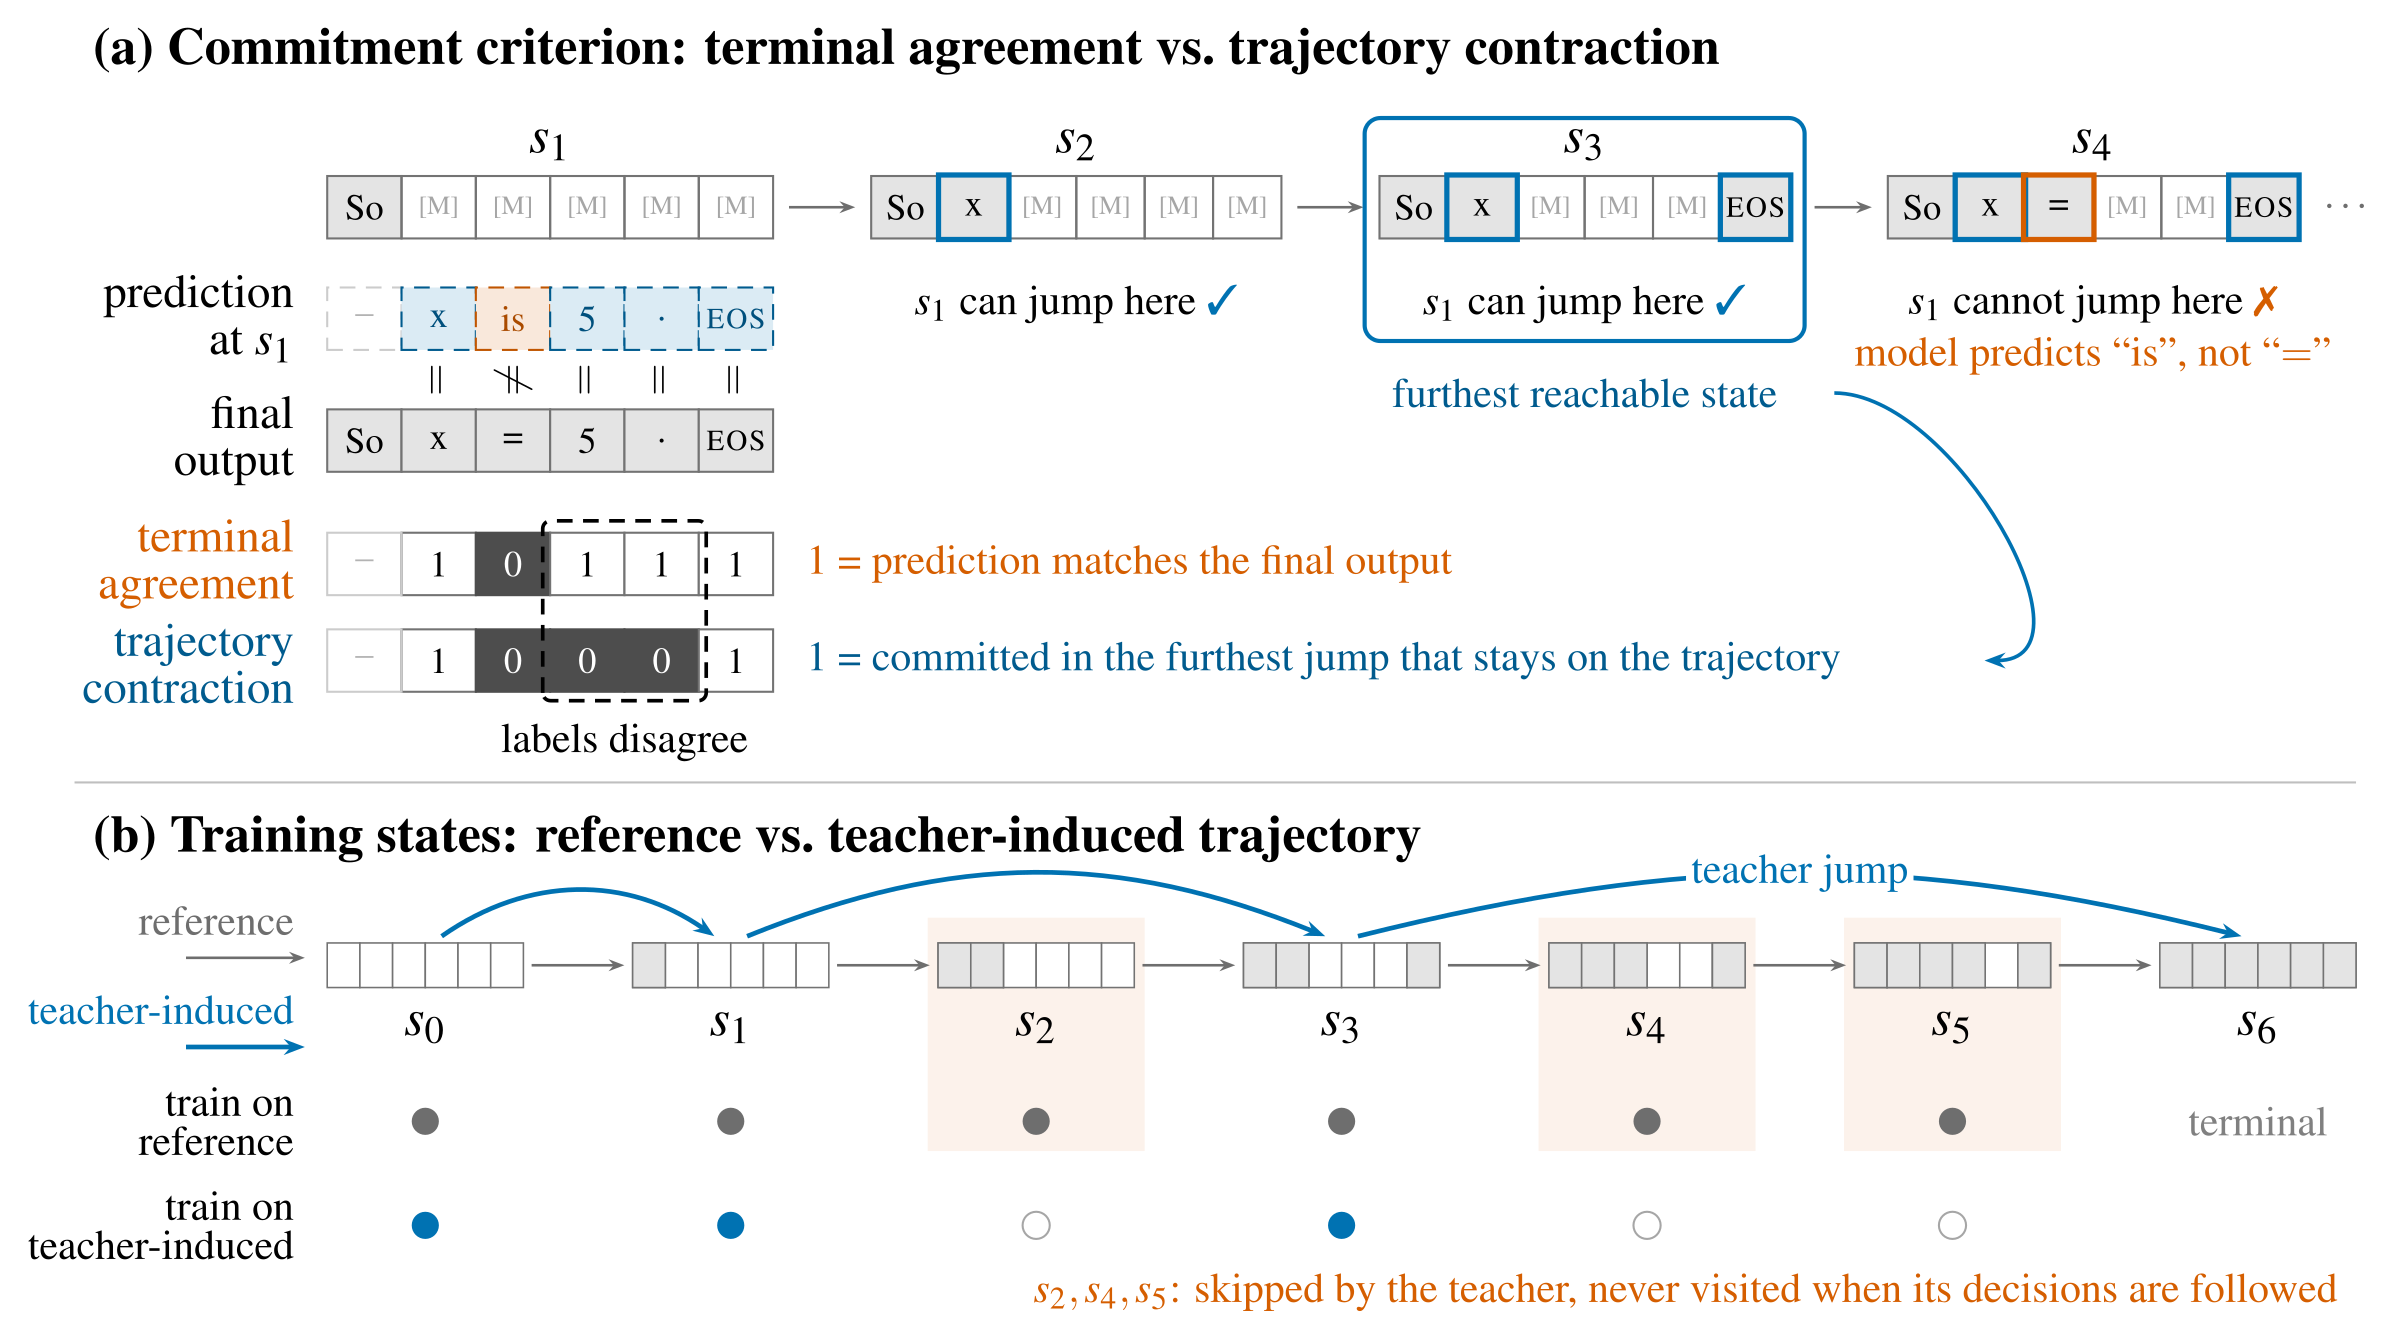
- 1
图1a:从答案一致改为轨迹可达
最终答案中出现的token可能在当前状态过早提交并改变后续预测。轨迹收缩标签寻找当前预测能精确重返的最远未来参考状态,只提交这一跳允许的位置。
- 2
图1b:保留被跳过的训练状态
若只学习教师实际跳跃后留下的状态,会丢掉大量监督。OnTrack保留完整参考轨迹,再在每个状态生成收缩标签;参考数据来自确定性Fast-dLLM解码后的正确数学轨迹。
- 3
小网络决定位置,骨干决定内容
856K参数DiT读取冻结骨干的最高token置信度和最终隐藏状态,输出揭示分数;阈值决定提交集合,没有位置通过时退回最高分,避免停滞。
- 4
按质量目标选择阈值
推理阈值扫描形成准确率—前向次数—token吞吐曲线;缓存、提示长度、生成长度及骨干变化都要单独验证,不复用一个阈值宣称所有场景加速。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据14,958数学样本筛得9,169条正确轨迹、686,052状态;策略训练约3小时15分,骨干冻结。 §4 与Appendix A–C ↗
我的解读选择正确轨迹可能引入容易样本偏置,训练成本也需要计入部署收益。
来源证据无前缀缓存时OnTrack为331 token/s、Fast-dLLM为232;加缓存后分别249和276。 Table 3,GSM8K 98%相对质量目标 ↗
我的解读减少模型调用次数不必然提高实际吞吐;缓存设置甚至反转胜负。
来源证据部分MATH/HumanEval高质量目标无法达到;同时改变领域和长度会退化;Dream使用另训策略。 跨任务与长度实验 ↗
我的解读不能把任务内数学结果外推为所有代码任务或零训练跨骨干迁移。
开放情况与使用许可
GitHub含teacher/train/eval实际目录;HF存在LLaDA与Dream两套model.safetensors。策略与代码标Apache-2.0,骨干和第三方代码仍各自授权;未执行模型。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
控制变量拆解了“标签是否合理”和“状态是否覆盖”两个常被合并的问题,小策略便于做消融。
反方 · 哪些结论还不够
吞吐测于特定GPU与批量;高精度工作点、缓存隐藏状态扰动与分布迁移仍会损失优势。
综合判断
适合在可接受精度下降的扩散解码场景实验,不能仅凭NFE宣布加速。
我会先做的验证
未执行的验证方案:在固定H200/批量/长度下复测缓存开关与阈值扫描,报告绝对准确率、端到端吞吐、策略开销和失败样例。