LeWAM:在 JEPA 特征里同时学习动作与未来
推理只生成动作,0.4B 是可训练参数量
LeWAM 以冻结 I-JEPA 特征为视觉输入,让一个 Transformer 联合学习动作流与未来视觉嵌入。结构化注意力防止演示动作泄漏,随后以与演示的距离排序候选做偏好训练;上线时不再生成未来画面或执行搜索。
图解主要方法
图 3 怎样让动作学习使用世界建模监督,又不偷看未来?
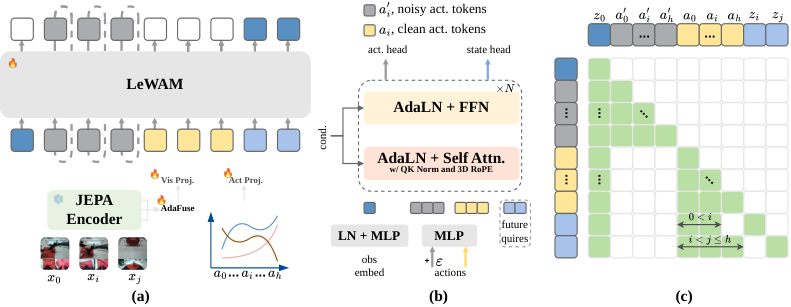
- 1
汇合冻结视觉层的特征
冻结 I-JEPA-Huge 约 0.6B 参数,AdaFuse 为不同层、不同通道学习共享 softmax 权重并做归一化。权重不是随每张图动态生成;加上约 402M 可训练预测器,总参数约 1B。任务条件使用离散 ID,不是自由自然语言。
- 2
用注意力掩码隔开训练信息
同一预测器接收当前视觉、带噪动作、干净演示动作及未来查询。带噪动作不能读干净演示;未来查询只读对应预测时距以内的动作前缀。随机时距监督冻结编码器的未来特征,避免未来答案直接泄漏到动作分支。
- 3
联合训练,部署去掉未来分支
动作使用流匹配损失,未来使用权重 0.1 的特征均方误差;部署移除干净动作和未来查询,十步去噪生成动作。世界模型在这里提供训练约束,不代表每次执行前都在线想象和规划。
- 4
DemoDPO 以演示距离构造偏好
冻结参考策略生成四个候选,用与演示动作的 MSE 排序、过滤距离差过小的对,再比较共享噪声和时间下的速度误差。β=5000、额外训练 1000 步;它学习的是接近演示的偏好,不能当作真实执行成功奖励。
- 5
控制理论解释的适用范围
论文的表示论证依赖线性高斯、全局最优和特定 KL 约束。编码器实验还同时改变了架构与预训练数据,不能由结果推出所有视频 VAE 必然抹去动作相关信息。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【RoboTwin 2.0】50 任务、27500 演示,16 张 H800 训练十轮。I-JEPA 基线 86.17,加入世界监督 87.02、AdaFuse 90.69、DemoDPO 92.28;LingBot 为 92.20。 主实验与消融 ↗
我的解读我的解读:消融解释逐段贡献,最终比另一系统仅高 0.08 个百分点;部分外部基线数字来自原文,并非全部统一重跑。
来源证据【单 H800,十步去噪、CUDA Graph】31.9 ms、1.988 GiB;对照 π0.5 为 53.14 ms、7.037 GiB。 效率实验 ↗
我的解读我的解读:动作长度 32 对 50,且不含 CPU 预处理、传输、执行和图捕获开销,不能直接当机器人端到端实时周期。
来源证据【真机】双 Piper,三任务各 400 演示、每任务 50 次评估;任务进度 84.9/60.7/53.0。 真机实验 ↗
我的解读我的解读:这是里程碑进度而非二元成功率;偏好版比普通策略多 1000 次更新,须将额外训练预算单列。
开放情况与使用许可
已检查推理模型、注意力布局代码与 RoboTwin 评估入口,Hugging Face 确有预测器和视觉编码器 safetensors。当前发布以推理为主;根目录未见统一 LICENSE,模型卡没有预测器许可证字段。部分源文件保留 Apache-2.0 头,捆绑 I-JEPA 明确 CC BY-NC 4.0,不据此推断整套可商用。
LICENSEI-JEPA 编码器 CC BY-NC 4.0;预测器及整仓许可未明确,文件级条款另计。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
结构化掩码使未来表征监督与动作预测共享参数,同时保持上线计算简洁。
反方 · 哪些结论还不够
偏好来自演示距离,任务 ID 与训练分布限制泛化;参数、延迟和真机指标容易被误读。
综合判断
值得作为紧凑 WAM 基线;先确认视觉表示、掩码和动作长度,再评估新任务与真正的闭环成功率。
我会先做的验证
未执行的验证方案:在同任务、相同动作长度和总更新量下比较额外 SFT 与 DemoDPO;记录完整传感到动作延迟,并用执行结果而非演示距离核验偏好排序。