LIBERO-PeRM:完成任务之外,机器人是否遵守你的偏好?
把动作、技能与用户习惯拆开测,成功率高并不等于偏好对齐。
机器人能把杯子放对地方,却可能忽略“慢一点”“使用指定动作”或“我习惯用红色杯子”。LIBERO-PeRM 用固定任务目标、可控偏好变化和组合冲突测试,揭示通用 VLA 在任务完成与个性化之间的缺口。它尤其值得作为家庭机器人验收补充,但还不是现实家庭长期个性化的证据。
图解主要方法
把动作、技能与用户习惯拆开测,成功率高并不等于偏好对齐。
- 1
图3:目标不变,只改变偏好相关因素
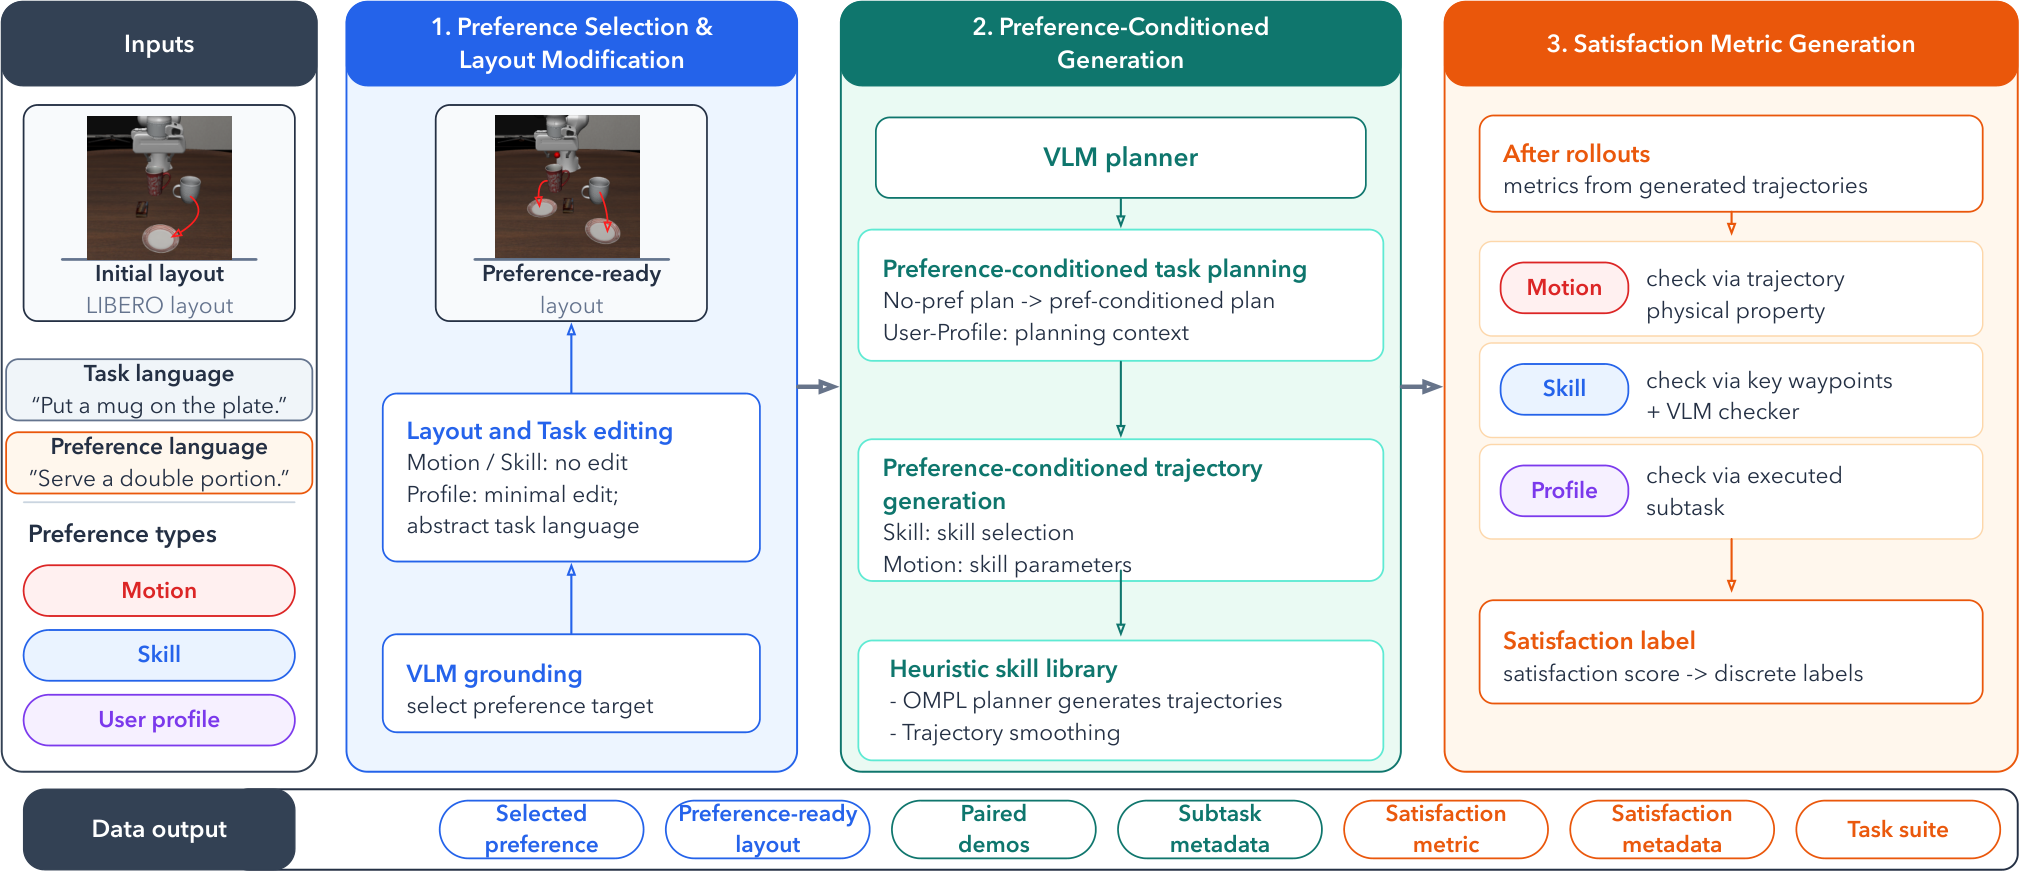
基准定义动作8类、技能14类、用户习惯15类,共37类单偏好及18种组合。动作和技能变化尽量保持场景与任务目标;用户习惯场景由 VLM 做最小编辑,例如加入另一种颜色的同类物体,使偏好有实际选择空间。
- 2
从计划和轨迹生成可控数据
VLM 分别生成无偏好与有偏好计划;技能结合人工参考路点和 OMPL 随机初态规划,必要时通过平滑偏移修正,72%的技能无需偏移调整。312项任务包括无偏好任务,合成与增强后共4.08万条 rollout,不能称为4.08万条人工示范。
- 3
分别测任务完成和偏好满足
动作偏好需检查运动学轨迹,不能只看终态照片;技能使用路点与视觉判定,习惯检查实际执行子任务。满足度离散为0、0.25、0.75、1;SA 对 success×满足度求均值,失败按零计,所以不是“成功任务中的偏好满足率”。
- 4
用泛化与冲突定位学习代价
测试包含规模、未见布局、偏好组合和冲突,ComprePref 复用已有场景而非增加312个任务。训练比较 π0.5 的偏好 SFT、无偏好混合与顺序训练,主要用8张 A6000 Ada、学习率5e-5。冲突评分允许满足其中一种偏好,并不检测模型是否主动澄清。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据π0.5 无偏好成功率97.6%,全部偏好平均 SR66.67%、SA37.92%;动作 SR97.5%、SA24.38%,技能100%与25%。 表2:零样本 ↗
我的解读目标完成与遵从偏好差距很大;这些指标共享失败惩罚,不能相减得到独立的“偏好能力”。
来源证据偏好 SFT 总体 SR84.96%、SA82.48%,未见布局降为37.49%与28.36%;表中误差来自固定检查点10次评估,而不是10次独立训练。 表3及泛化实验 ↗
我的解读对已覆盖偏好训练有效,布局迁移仍弱。不能以单一检查点的评估波动代表训练稳定性。
来源证据混合训练使 ComprePref 的 SR/SA 从44/42.64提升到72.83/70.07,但动作偏好从90/85.37降到66.88/66.06;组合任务约25%/25%,分解提示37.5%/0%。 混合训练与组合实验 ↗
我的解读保留基础任务有益但不是所有偏好同步提升;把指令拆开也不等于会联合执行。
开放情况与使用许可
论文和项目页可访问。附录称资源采用 MIT,但本次项目页没有找到可核实的代码或数据下载及实际许可文件,暂不计为已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
该基准把“做成事”和“按用户方式做事”落实到不同观测与可复查指标,可用于检查个性化微调是否以基础技能或其他偏好为代价。
反方 · 哪些结论还不够
只覆盖可语言表达且可自动评分的预设偏好,没有真实机器人、长期用户历史或隐式偏好学习。15人的合理性调查不能替代真实家庭使用;自动生成与视觉评分也可能共享偏差。组合只到两项,冲突指标不要求澄清。
综合判断
适合作为个性化操作的诊断基准;当前结果支持“需要单独训练和评估偏好”,不支持机器人已能可靠理解复杂用户习惯。
我会先做的验证
未执行的验证方案:固定任务与随机种子,分别测试未见布局、未见用户偏好和三项冲突;并列报告 SR、无条件 SA、成功条件下满足度,增加人工盲评和主动澄清指标。