线性可读知识,更容易被微调迁移
答得出旧事实,与学会建立在旧事实上的新关系,是同一回事吗?
将预训练关系的答案随机换成动物名,再微调部分实体并测试未见实体。跨11个模型、70种关系,微调前线性探针的可读性比直接事实召回更能预测迁移;研究揭示了“记得”与“可利用”之间的区别。
图解主要方法
答得出旧事实,与学会建立在旧事实上的新关系,是同一回事吗?
- 1
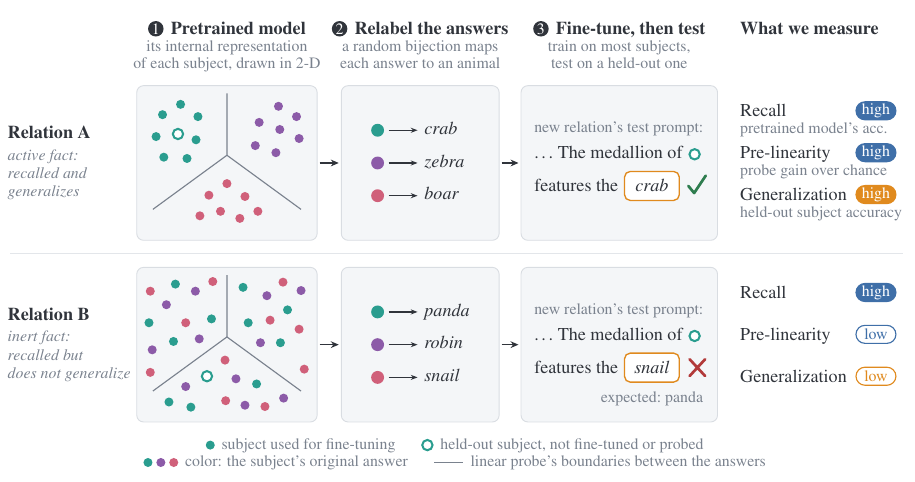
图1先拆开召回和表示结构
预训练模型对两类关系都可能答对,但主体最后一个token的隐藏表示未必能被线性边界按答案分开。作者提取各层表示,训练分类探针衡量超出多数类机会水平的可读性,称Pre-linearity;图中的点颜色表示原答案而非新标签。
- 2
随机重命名,避免沿用语言答案
把旧答案一对一映射到动物标签,如欧洲→crab,构造全新关系;从179个名称中排除语义邻近、首token冲突等线索。每个答案至少4个训练主体、1个留出主体,只对新答案第一个token计算微调损失,评测限定候选集合,因此不是开放式事实生成。
- 3
训练和探针严格隔开留出主体
训练用4种模板,测试第5种;全参数微调20轮、每事实80次曝光。探针经16维PCA与白化,带正则的线性分类器用10折外层、5折内层选层,均只在训练主体中完成;留出主体不参与选层或新关系训练。图1空心点表示这些未见主体。
- 4
比较关系间相关性与错误方向
11个2B–27B开权重模型分别对70关系计算召回、可读性与新标签泛化。控制答案数、训练样本量、旧事实召回和Dolma频率,再分析错误是否落在探针偏好的旧答案所对应的新标签上。这里的active/inert是针对该迁移任务的描述,不是知识永恒的内在属性。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据模型内跨关系Pearson相关为0.87–0.92,中位数0.90;同时控制四项因素后仍为0.70–0.82。单独旧召回相关0.63–0.74,控制可读性后0.40–0.58。 正文结果、附录统计 ↗
我的解读我的解读:线性组织提供了额外预测信息,但相关性不能证明只要人为线性化就一定改善迁移。
来源证据主实验11模型70关系;替换13类标签在MiniCPM上检验。3种随机种子/映射的全面复测主要在MiniCPM,其他模型只选17关系,不能说每一格都有同等重复证据。 附录标签与重复实验 ↗
我的解读我的解读:减少标签巧合的设计有价值,但规模、重复范围和模板敏感性仍应分开。
来源证据37,571个错误来自757个微调任务;探针top-3的Shapley贡献21.5,相应打乱对照8.8;召回贡献11.5、对照7.3。Dolma频率只是预训练出现频次代理。 错误分析与限制 ↗
我的解读我的解读:错误方向与表示结构一致,但任务本身是保留分类结构的重命名,这可能天然偏好线性可读关系。
开放情况与使用许可
作者仓库active-inert-facts含关系数据、标签、提示及artifacts_v1/code实现。根数据许可CC BY-SA 4.0,代码子目录MIT;BEAR、Hernandez、WordNet及第三方排行各保留原条款。未确认全部微调检查点发布,未运行复现。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:这是选择微调任务和诊断失败的有用思路。即使模型能回答旧事实,也应检查其表示能否支持新的分组规则,而非只看知识问答分数。
反方 · 哪些结论还不够
候选答案限制、首token损失、人工重命名关系都比真实知识组合简单;未通过干预证明线性结构的因果作用。不同模型预训练数据不可知,频率控制并不彻底。
综合判断
可将线性探针作为迁移前诊断信号,不宜作为通用知识深度排行榜或微调成功保证。
我会先做的验证
未执行的验证方案:固定召回率及样本量,加入自由生成、未见模板、非线性组合关系,并随机干预表示中的线性方向;分开记录探针变化与真实新任务EM,验证预测是否仍成立。