Logit 几何:输出分数的规律,有多少来自训练?
排序后的近直线形状并不专属于语言模型;斜率与训练变化才是更关键的证据。
论文把每一步的词表logit排序,拟合截距和对数秩斜率,并与随机分布及训练中间检查点对照。它展示了压缩排序概率谱的可能性,但没有恢复尾部词元身份,也没有证明能直接省掉词表计算或可靠判断事实真假。
图解主要方法
排序后的近直线形状并不专属于语言模型;斜率与训练变化才是更关键的证据。
- 1
在每个上下文内排序拟合
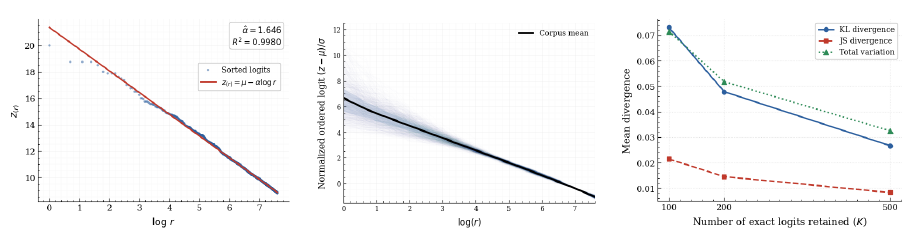
图1左将logit按降序排列,对前K项拟合z(r)=μ−αlog(r)。主分析K=2000,普通最小二乘输出斜率、截距、R²和RMSE。先按上下文拟合,再按书本汇总;这研究的是单次条件预测,不能与整本书的词频Zipf定律混为一谈。
- 2
把排序自带的形状扣出来
对均匀、高斯、指数、对数正态随机样本应用相同拟合,并改变K。高斯和指数样本也可有很高R²,因此形状好看不是学习证据。再看Pythia训练检查点:初始化α约0.2,训练后约1.6;中途还出现拟合变差的阶段,不能说从初始化起就具有完全相同的规律。
- 3
保留头部,外推排序尾部
图1右保留前100/200/500项精确logit,用拟合的μ、α外推剩余秩,再softmax并比较KL、JS和TV距离。该重建只知道某个概率排第几,不知道尾部词元是谁;论文也没有测实际推理加速。
- 4
将斜率与预测状态分开检验
附录F在128词元不重叠窗口上,对40个模型×书本组合分别计算相关,再做随机效应汇总、符号检验和不筛R²的复核。附录G说明标准化曲线重合本身是仿射函数z-score后的代数结果;理论给出条件推论,并没有解释训练为什么必然产生该斜率。
实验与证据
已阅读正文§1–4及附录A–G(实验、统计和全部理论证明),核对实验条件与原图;未独立复现。
来源证据四家族十个模型,GPT-2到Llama3.2-3B;十本Gutenberg书各取前20000词元,128长度、步长1;GPT-2另测WikiText-2和法语Wikipedia。表2斜率1.413–1.695,R²实际0.9889–0.9918。 附录B/C:主分析条件 ↗
我的解读不能照搬“所有模型R²>0.99”的概述:表中GPT-2 XL和Pythia低于0.99。样本也偏短窗口和书面文本。
来源证据高斯、指数也达到约0.99/0.97的R²;K=500时Pythia-410M的α从初始化0.203升至最终1.571,中间第64步R²仅0.680。 附录C/D:随机和训练对照 ↗
我的解读训练改变的是尺度及演化路径;高拟合度本身并不足以识别语言能力。
来源证据四模型共39520个上下文,K=500时平均JS=0.0083、KL=0.0266、TV=0.0325;各模型JS范围0.0058–0.0094。 附录E:重建 ↗
我的解读这是排序概率谱误差,不是语义输出无损,也没有端到端时延和显存实验。
来源证据R²≥0.95时α与熵Pearson r=−0.332、NLL=−0.206、真词概率=+0.111;熵相关异质性I²=66.6%。精确log-linear形式在温度T下斜率变成α/T。 附录F/G:相关与理论 ↗
我的解读相关较弱且温度会改变斜率;不能把斜率当跨系统统一的事实正确性分数,或把代数等价当成独立机制证据。
开放情况与使用许可
论文与图为CC BY 4.0。附录称代码可用,但HTML与PDF可解析链接未找到有效作者仓库;因此实现开放状态待核,不按论文声明推定已开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
最有价值的是主动加入排序随机基线、训练轨迹和筛选敏感性分析,避免把统计形状直接宣称为语言模型独有规律。
反方 · 哪些结论还不够
只覆盖预训练decoder模型、有限文本和较短上下文;尾部词元身份丢失。斜率依赖温度和量纲;对真词概率的相关很弱。论文代码脚注未提供本次可解析的实际仓库地址,复现实现仍待确认。
综合判断
适合作为输出分布诊断与压缩研究的假设来源;尚不足以宣传成可靠幻觉检测器或已验证的推理加速技术。
我会先做的验证
未执行的验证方案:固定温度、模型和tokenizer,在中文、代码、长上下文与指令模型上预注册K,比较α对错误的校准与熵基线,并分别记录获取top-K的成本和尾部身份缺失对采样的影响。