Long-WAM:机器人不仅要存下历史,还要学会用历史预测下一步
自回归视频预训练与异步执行协同,但更长记忆有延迟和数据覆盖代价
Long-WAM先进行无动作标签的机器人视频自回归预训练,再用相同因果结构接上动作专家:先预测带噪未来latent,再据此生成动作。历史长度增加能帮助部分长任务,但每种长度分别训练;19.2秒历史的收益伴随更高计算时间,不能写成免费扩充同一策略的记忆。
图解主要方法
更长历史何时真正帮助机器人,又怎样避免它拖慢下一次动作?
- 1
先用机器人视频学因果预测
从LongLive-2.0的16秒自回归检查点继续训练,视频监督不需要统一机器人动作空间。分块因果注意力让带噪目标只读取之前的历史;缓冲预测误差加入训练输入,但恢复目标仍是原始干净视频,训练模型纠正滚动误差。
- 2
保持视频因果结构,接入动作专家
视频token只能读取自身和过去视觉块,不读取动作;动作读取观测历史、预测未来和整个待去噪动作块。训练有独立视频和动作两遍,动作损失通过分离缓存不回传到视频专家,动作专家与本体状态适配器负责动作学习。
- 3
先做部分未来预测,再用固定缓存生成动作
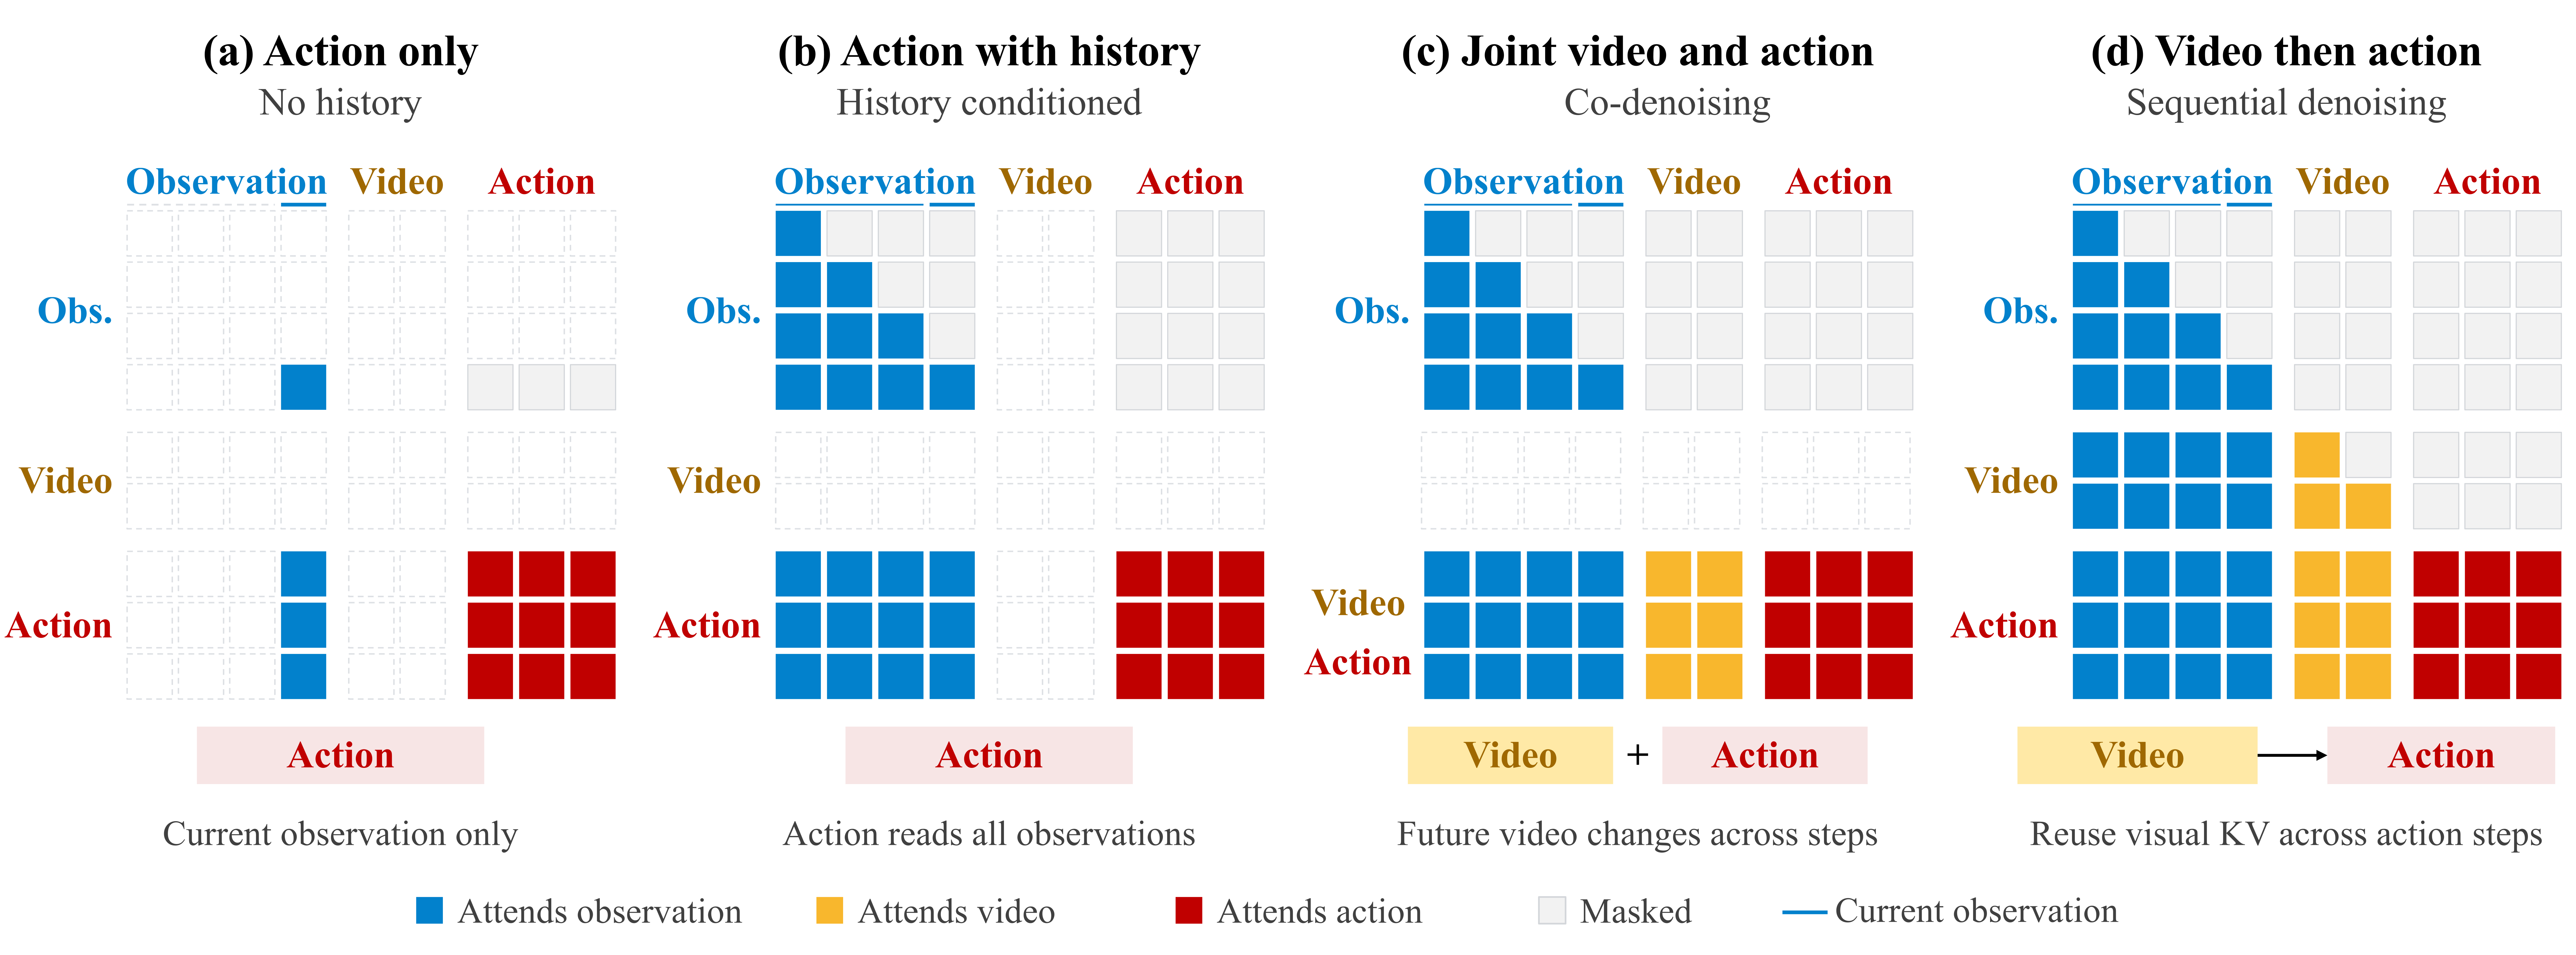
IDM推理从随机噪声做四步视频预测,停在σ=0.9,不解码成像素,再让动作专家条件于这份视觉KV去噪。训练对应条件来自加噪真实未来,推理来自模型预测,不能视作完全相同的数据分布。图2同时比较无历史、只用历史、联合去噪和先视频后动作四种方式。
- 4
把观察编码移到机器人执行期间
流式因果VAE持续处理到来的观测,推理与正在执行的动作块重叠。交接时丢弃新块中已过去的前缀,执行时间对齐的后缀;若新块迟到仍须等待。缩短重叠可改善平滑度,但固定执行长度下也意味着更晚触发、更低决策频率。
- 5
以硬件优化兑现时间预算
视频线性层用NVFP4四位权重与激活,动作计算与KV保持BF16;编译、CUDA Graph、共享量化和分段在线softmax减少重复工作。KV复用主要限定一次动作求解内,本体状态、历史淘汰和时间位置变化会使跨决策缓存失效。
实验与证据
完整阅读正文和附录A–H共80911字符,查看图2、图6,核对实际源代码树、推理入口、许可证、公开权重文件及模型卡。未下载或运行模型权重,未执行机器人命令。
来源证据预训练2294889个样本,其中2251021训练样本各按16秒折算为10004.5小时;64张H100共30720 GPU小时,下游16张GB200。 附录B.1、第5.1节 ↗
我的解读“一万小时”是窗口等效时长,不是独立原始录像;重叠与填充会影响信息量,不应当作一万小时去重机器人数据。
来源证据各历史长度单独训练,保持预测与动作时域不变;早期缺历史重复初帧。GR-1平均训练轨迹12.1秒,38.4秒窗口80.4%填充。 第3.3、5.3节、附录A ↗
我的解读该实验比较学习不同上下文的策略,不能声称同一个已训练模型临时多读历史即可重现全部增益;长窗口退化解释仍是待验证假说。
来源证据RTX5090的0/2.4/4.8/9.6/19.2秒历史分别为74.6/107.4/138.3/204.5/341.0毫秒。计时包括全观察VAE,但排除预处理、文本编码、控制器与IPC。 附录F、G、表12 ↗
我的解读107.4毫秒只对应2.4秒历史配置,不能套到19.2秒模型;延迟倒数是推理计算率,不是机器人控制频率或含通信的完整响应。
来源证据延迟为两个独立进程各30个稳态样本的中位数再取均值,排除各五次预热。Spark/Thor优化V4/A4为328.2/378.7毫秒。 表8、附录F ↗
我的解读这些是具体硬件与形状下的测量;启动、调度和控制截止时间需另验,不能把所有设备统称为约100毫秒。
来源证据RoboTwin固定可执行24步时,触发间隔12/16/20步成功94.2/95.0/94.3%,重叠RMSE和jerk代理持续下降。 附录E、表10 ↗
我的解读更平滑并不单调提升成功率。jerk未除以时间间隔三次方,是离散代理而非统一物理单位的冲击度。
来源证据YAM三项任务各20次,成功80/80/85%,平均81.7%;G1叠杯19/20。 第6.1节 ↗
我的解读样本规模较小,单次结果对应5个百分点;应结合试验数和置信区间,不能推广到任意物体速度和任意场景。
来源证据RoboCasa365同检查点加高层规划,整体31.4%→54.4%,未见组合6.1%→35.0%;纯15步重查策略原子任务84.4%,接近规划85.6%,但未见组合仅5.0%。 第6节 ↗
我的解读高层系统同时分解指令、选执行前缀并可作有限末端修正;组合任务收益不能简单归为更短动作块,也不能全部归为语言推理单一因素。
开放情况与使用许可
2026-10-11官方NVlabs/LongLive/Long-WAM提交e5fa48cc5b1f995637b987195d25b5bd16e26086包含实际训练、推理与部署代码,src下150个Python文件。核对LIBERO-IDM模型仓库提交eca2710140fc0d03a2b0259db1d49d5ca60d5122,确有model.pt、config.yaml、dataset_stats.json与SHA256SUMS;未下载权重验证内容。作者验证文档明确完整基准复现仍未完成,CPU检查不能当作策略成绩复现。
LICENSE论文和图2为CC BY 4.0;原创代码Apache 2.0,第三方组件保留各自许可。所查LIBERO-IDM权重模型卡标记license: other,未见独立许可正文,不能据代码许可推定权重商用授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
图6及正文支持GR-1从当前帧的63.3%提升至19.2秒历史的78.7%;LIBERO-Long从94.5%到2.4秒历史99.5%。
真机每策略每条件20次:7.5厘米/秒传送带抓取成功90%,动态叠杯19/20;所比两策略在后者均0/20。
反方 · 哪些结论还不够
38.4秒历史GR-1降到75.2%,80.4%历史帧是填充;更长并非单调更好,也尚未证明下降唯一原因是填充。
主文表4把63.3%标为2.4秒,而正文及图6给2.4秒66.3%、零历史63.3%;主表LIBERO-Long CoD95.8%,段落写97.8%,后者也是主表平均值。
优化V4/A4从356.0降到107.4毫秒,但RoboTwin成功率94.4%降到93.5%;不同基线用各自原生去噪预算,不能只归因于统一架构优势。
综合判断
贡献在因果视频先验、历史控制和部署工程的结合,证据支持所测任务中的实用收益。它不是无限记忆,也不是已验证所有平台与公开权重都可直接达到论文速度和成功率。
我会先做的验证
建议实验,未执行:在同一权重上训练可变历史策略,固定总算力和动作预算比较;报告真实机器人完整历史扫描、冷启动与通信开销、跨种子置信区间,并测带噪真实未来到生成未来的分布差异。对表4与CoD冲突要求作者给出对应原始评测日志。