LongZero:先编出事实骨架,再扩写长上下文
同一个模型自造练习,怎样避免答案随长文扩写一起漂移?
LongZero 先生成结构化虚构世界、问题和答案,再安排证据所在文档并扩写长文;随后筛出模型时对时错的问题进行强化学习。小模型有增益,但“零数据”不代表零模板、零预训练知识或零生成成本。
图解主要方法
同一个模型自造练习,怎样避免答案随长文扩写一起漂移?
- 1
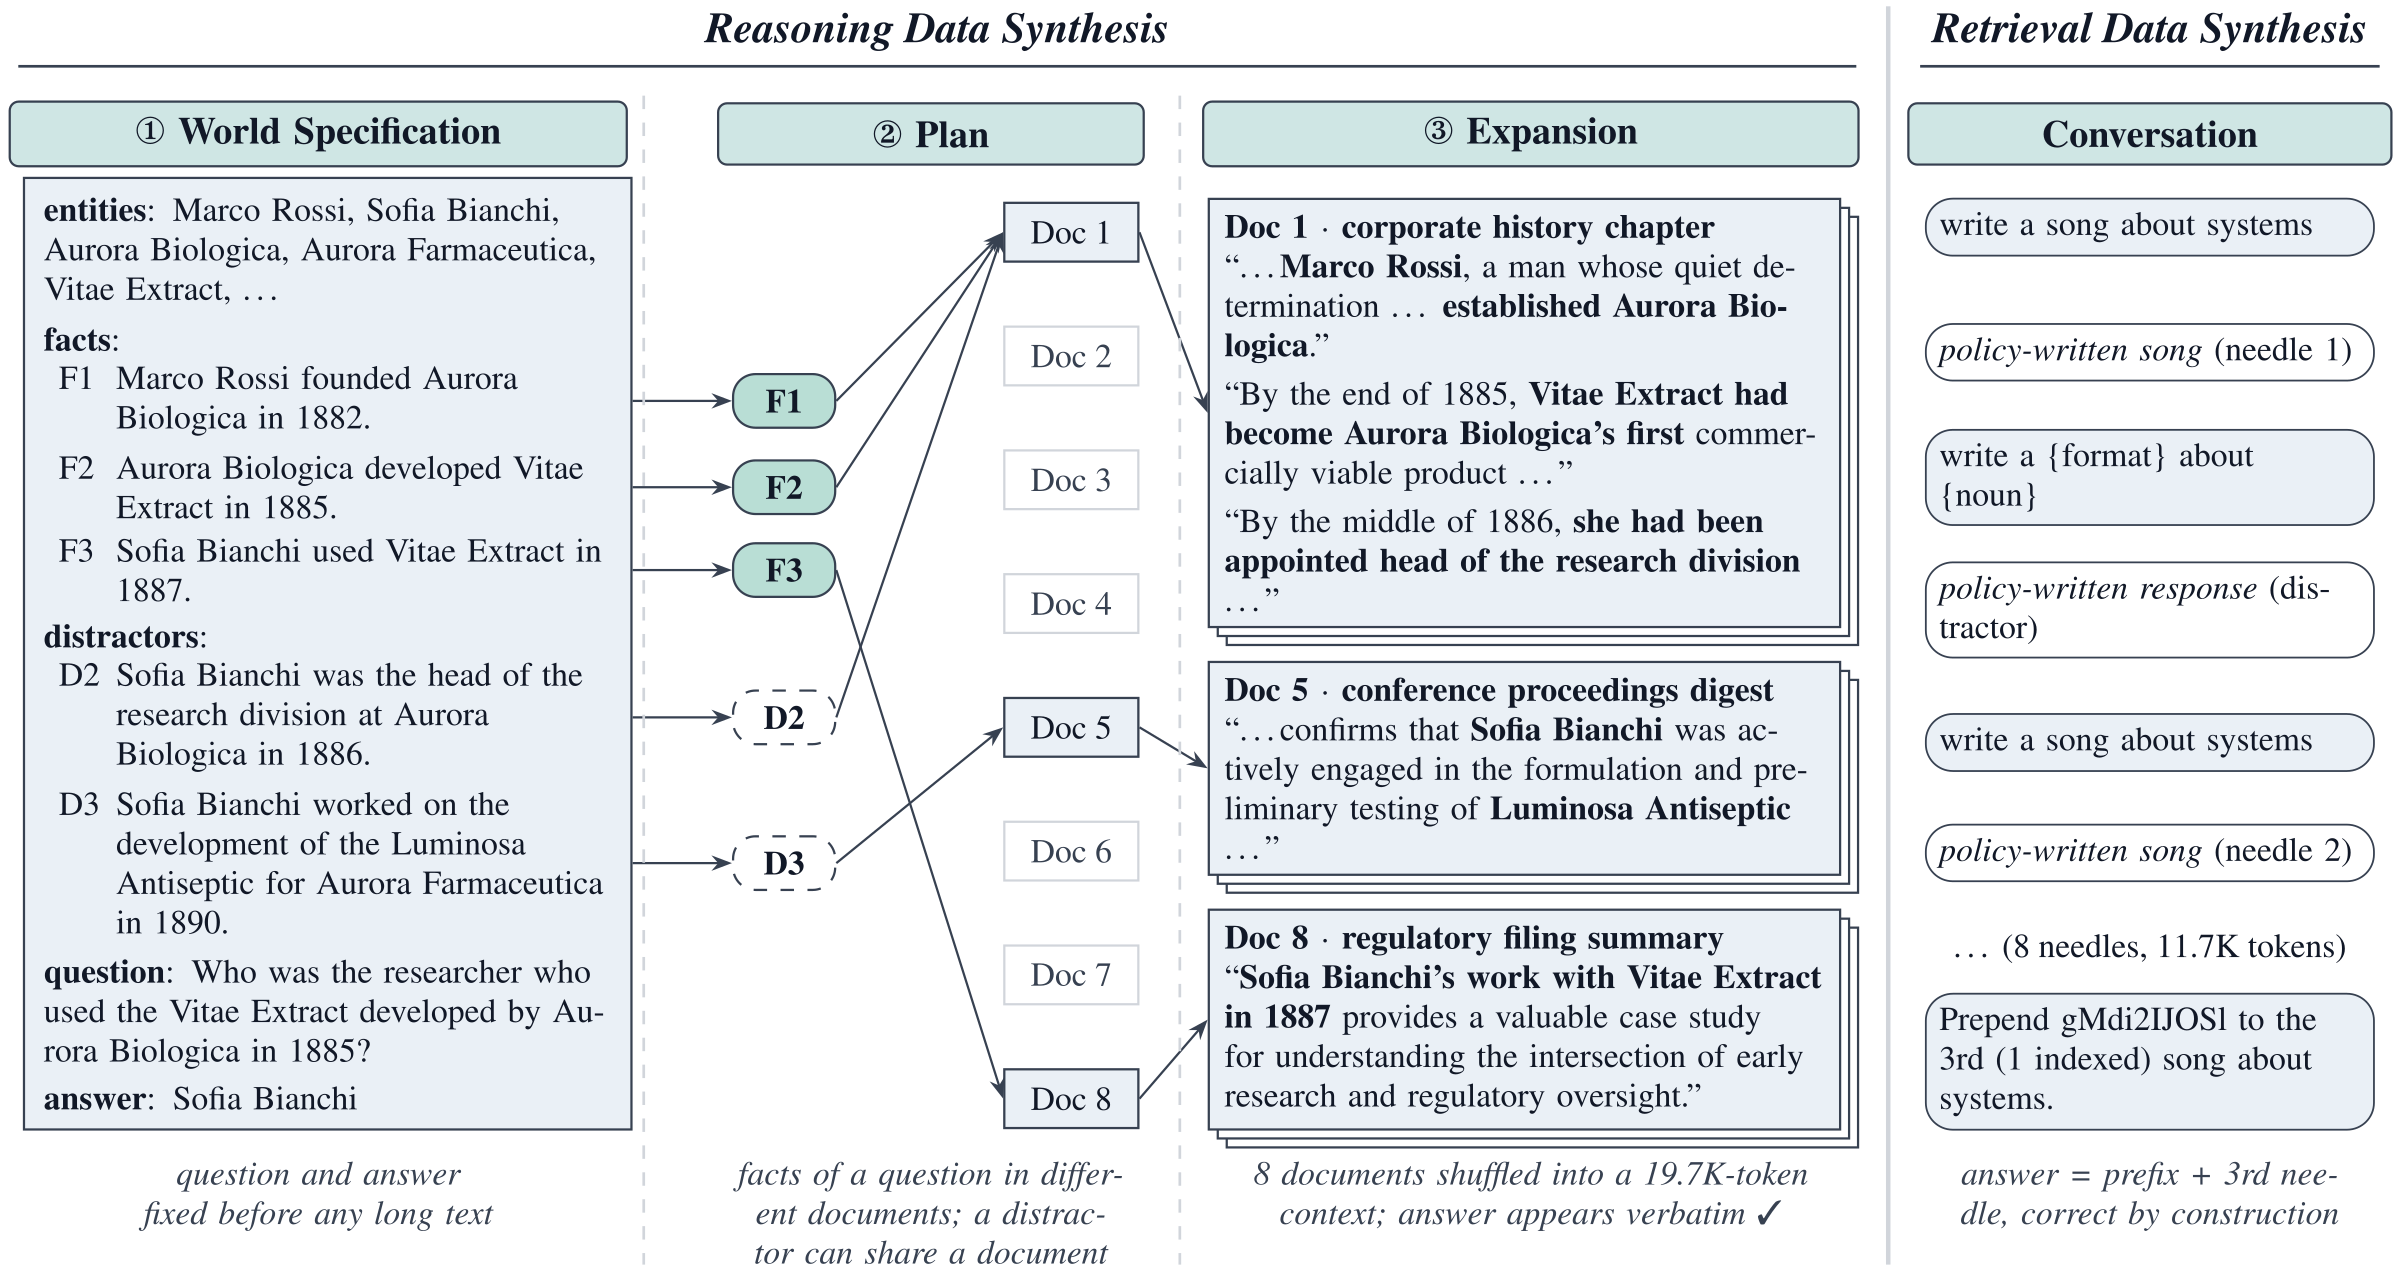
图2左侧:答案先于长文固定
模型写出8—14个实体、3—5跳问题链和干扰事实,安排8篇文档分别承载证据。扩写时约束事实ID与禁止重复内容,最后打乱文档,减少直接从某一段抄答案的机会。
- 2
把忠实度和难度分开筛
程序检查支撑事实、别名和答案是否在扩写中保留;另让模型多次作答,只留存在成功与失败的题。字符串和别名门控不能证明每条推理链语义正确,年份答案还有豁免。
- 3
混合推理与检索,再做GRPO
检索样本由模型自写回复组成,但采用公开MRCR任务格式和名词表。训练用2304推理题加1152检索题,2:1混合,世界级划分训练验证;每提示采样8次,输入上限32768、输出8192,4B训练72步、8B108步。
实验与证据
已阅读全文正文与附录A生成、筛选、训练配置,核对实验条件与原图;未独立复现。
开放情况与使用许可
官方仓库包含 synthesis、training、evaluation 与 MIT LICENSE;第三方基座和训练依赖保留各自许可。数据链接已提供,本次未下载全量数据或训练模型。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
结构化事实先行提供了比“直接让模型写长文再出题”更可审计的合成数据入口。
反方 · 哪些结论还不够
验证依赖模型自身与规则门控,错误可能自洽地保留下来;仅两种小模型、有限训练长度,难以推及超长文档或专业事实密集任务。
综合判断
适合作为低外部数据依赖的训练方法候选,但不能宣传完全无数据或普遍超越教师数据。
我会先做的验证
未执行的验证方案:人工盲审随机保留和拒绝的问题链,统计证据完整性;用等生成token预算比较其他合成方法,并单列128K以上外推失败率。