LoOPSD:重复一段网络层,给原模型造一个教师
不换更大模型,怎样用层循环改善学生自己的推理?
LoOPSD 先在少量带答案题目上搜索值得重复执行的连续层区间,以同一组权重构造更深的教师,再蒸馏学生原始路径采样的回答。每轮重新搜索,最终部署仍走原始网络;搜索需要标签与额外计算,推理收益也不保证逐轮单调。
图解主要方法
不换更大模型,怎样用层循环改善学生自己的推理?
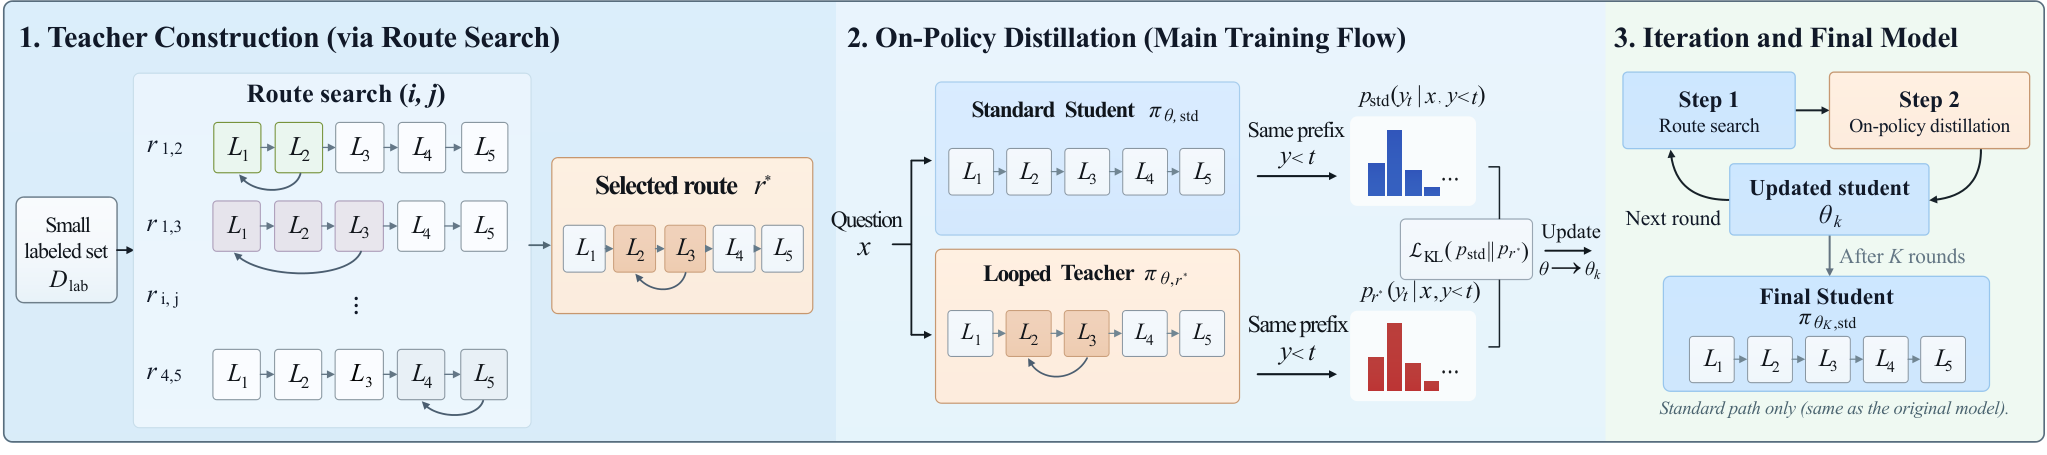
- 1
搜索循环教师路径
图2左侧路线 r(i,j) 让连续的第 i 至 j 层重复一次,每个词元多执行 j−i+1 层。先用128条带标签题筛选候选,再用872条重排,最后在100条独立验证题上选择;始终包含标准路线,严格胜出才采用循环。
- 2
学生先生成,教师只评价相同前缀
图2中央标准学生每批12题、每题4条回答,最多1024词元、温度1。冻结循环教师在学生实际走过的前缀上给出词元概率,使训练分布贴近学生自己的错误路径,而非仅模仿教师成稿。
- 3
用采样估计蒸馏梯度
目标写作反向KL,实际采用采样词元的对数概率差,差值截断到[-10,10],配合重要性比率与停止梯度;并非每步精确计算全词表KL。每轮200次更新、学习率2e−6,更新后同步采样模型。
- 4
重新搜索后仍部署原网络
图2右侧最多10轮,按新学生再次搜索教师。最终学生只运行原始层序列,不带额外循环。带†实验还搜索简洁教师提示,不能把这些提升全归因于层重复。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-1.7B 从42.30升到第一轮78.09、最终79.61;Qwen3-4B 从74.98升至89.76,平均生成长度385.04降至299.98。 主表:GSM8K,固定400思考+128回答预算 ↗
我的解读我的解读:相同部署路径的改善有价值,但训练包含路线搜索成本;最终轮数不同的对照不能直接称为等算力优势。
来源证据Qwen3-4B 在128词元设置中,循环教师迭代达50.87,标准自蒸馏为26.38;第一轮循环为33.81。 附录:6轮×200更新的路线消融 ↗
我的解读我的解读:在该受控配置下循环教师确有增益,仍需计入搜索与教师额外层计算,不能说训练免费。
来源证据Phi-4-14B 的简洁教师变体第一轮95.07、最终93.18,未单调增长;GSMPlus 的1000题子集上,冻结GSM训练学生61.40,对照31.70。 跨轮与迁移结果 ↗
我的解读我的解读:迭代可能退化;主表中分别为各任务训练的结果,与冻结学生的跨任务迁移是不同证据。
开放情况与使用许可
论文与公开附录可读;论文未提供可核实的本方法官方实现或权重链接,本次不标为开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把模型自身的深度冗余转为教师,是无需外部大模型的实用研究路线,尤其适合部署结构必须不变的场景。
反方 · 哪些结论还不够
并非无标签训练;主实验固定训练种子42,主要是数学逻辑任务,缺少一般能力保留测试;路线搜索可能过拟合验证题。
综合判断
可作为受限部署预算下的推理微调方法,不能据此认定层循环能普遍提升任意语言任务。
我会先做的验证
未执行的验证方案:固定总GPU时与标签数比较循环教师、标准自蒸馏和GRPO;额外留出未见题型与通用语言任务,报告多种子和每轮退化。