MambaAct:用小型状态空间动作头替换大Transformer
动作专家缩小十倍,整机控制真的能快十倍吗?
把动作专家从311.5M压到29.7M参数,用状态空间块和复用的上下文调制降低多步流匹配成本。收益集中于动作头,端到端加速小于参数压缩,扰动测试也有退步。
图解主要方法
动作专家缩小十倍,整机控制真的能快十倍吗?
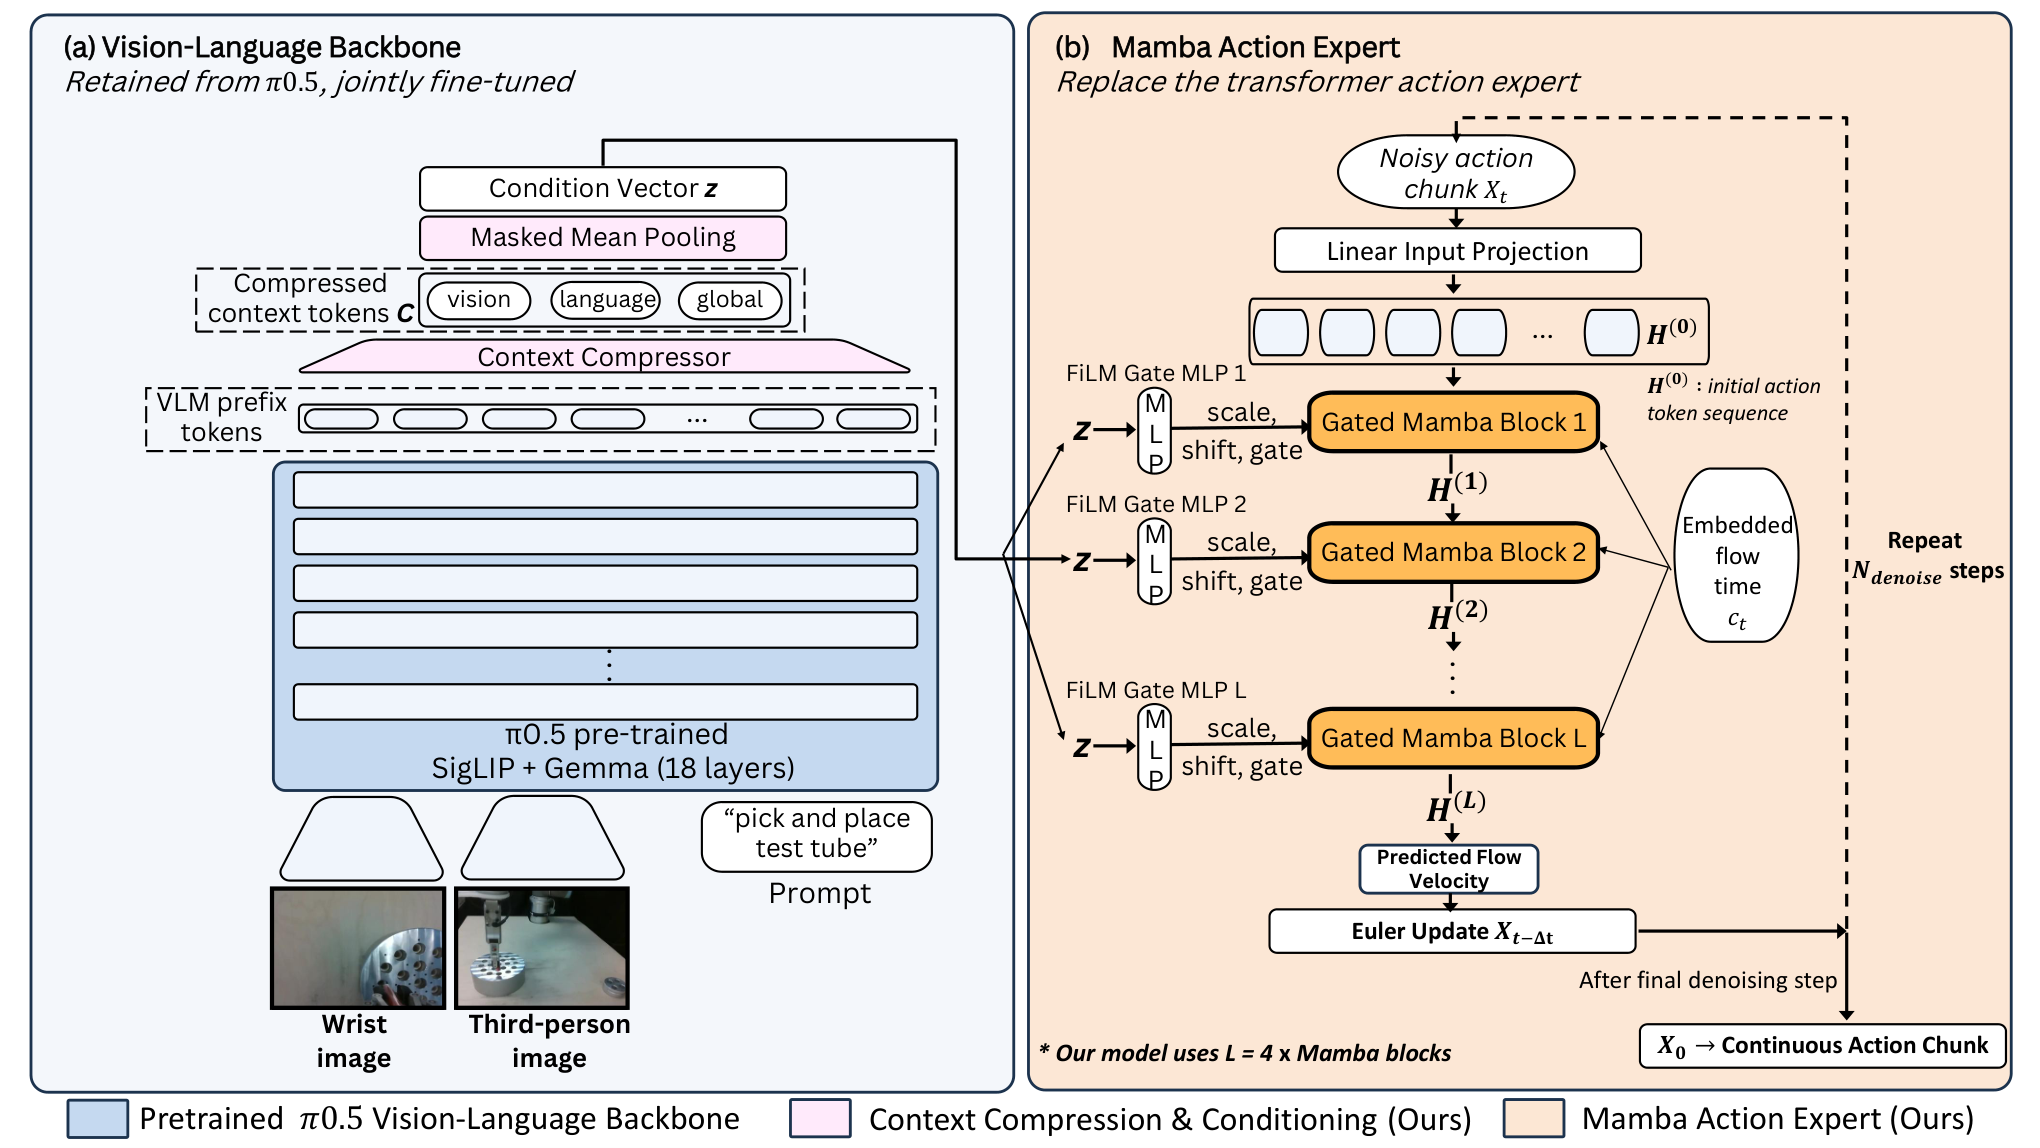
- 1
缩小动作专家而保留视觉语言骨干
图2采用4个Mamba-3块、隐藏维512替代原动作Transformer,并联合微调VLM。311.5M到29.7M是动作专家的变化;全模型约3.62B到2.96B,不能写成整机缩小十倍。
- 2
将跨模态条件池化为固定上下文
64个上下文token包含44个视觉、16个语言和4个全局token;池化后生成FiLM缩放、偏置和门控。避免每次动作去噪反复执行大规模跨注意力,但也可能丢掉空间细节。
- 3
复用条件、逐步更新时间
上下文调制计算一次并在去噪中复用,时间条件门控逐步更新、初值0.2。生成仍使用10次Euler步骤;速度改进来自每步成本,非把10步压成1步。
- 4
按闭环扰动和现实任务检查
除LIBERO外加入LIBERO-Plus噪声、相机变化,以及UR5倒水和插管任务;区分二元仿真成功与真实实验的阶段部分评分。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据H100、30k步、batch16、BF16,训练种子17/27/42;40任务每任务50次、评估种子7。均值从96.72±0.14到97.80±0.43。 同训练预算仿真 ↗
我的解读±为总体标准差而非置信区间;高分饱和区域的提升不代表所有困难因素改善。
来源证据LIBERO-Plus共10030次、每条件一次,平均78.7到79.7;噪声77.4降到73.5,相机61.6降到61.5。 鲁棒性反例 ↗
我的解读总体略升掩盖了传感扰动退步,低延迟不能替代鲁棒性验收。
来源证据去噪160.26到56.40毫秒,下降64.8%;端到端228.6到107.6毫秒,下降52.9%。前缀处理反而40.76到46.61毫秒。 时延拆分 ↗
我的解读动作头收益确实传到整体,但视觉语言前缀成为更大占比;不能用专家参数比例预测用户可感知速度。
来源证据UR5两任务共112条示范,28次ID和52次OOD;OOD倒水部分分86.5到95.2、插管76.9到82.7,5090端到端125到83毫秒。门控30M与跨注意力17–18M消融容量不等。 真实任务与消融 ↗
我的解读真实证据方向积极,但样本与评分边界要保留;Smol版25k检查点81.3到84.95也不能直接对比其他论文100k训练的87.3。
开放情况与使用许可
giakhuyendihoc/MambaAct公开了集成训练评测实现,Apache-2.0,NOTICE保留依赖边界;未独立核实发布了可直接使用的训练后检查点,部分脚本仍需基础权重。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
给出了动作头和全链路两种计时,并在多个训练种子与真实平台上检查,适合关注控制预算的团队。
反方 · 哪些结论还不够
扰动鲁棒性、大小不等的结构消融和真实部分分限制了“无损替换”结论;快速小型Transformer也可更快但精度下降。
综合判断
可作为动作专家的效率方案,当前证据支持约两倍端到端加速的特定配置,而非普遍十倍加速。
我会先做的验证
未执行的验证方案:在目标机器人同相机频率下固定全部训练预算,对比等参数Mamba与Transformer;测p95闭环延迟、传感噪声、相机偏移与完整任务成功率。