MaP-WAM:把长时记忆留给规划,把固定计划交给执行
语言与视觉计划结合进度校准,执行器上下文不随历史增长
机器人记住按钮颜色或已经按过几次,不一定需要每次动作都重读全部视频。MaP-WAM 保存完成段的稀疏真实画面,先生成下一段语言和视觉计划,再让固定上下文的 WAP 模型预测动作及进度,以视觉对齐修正进度漂移。
图解主要方法
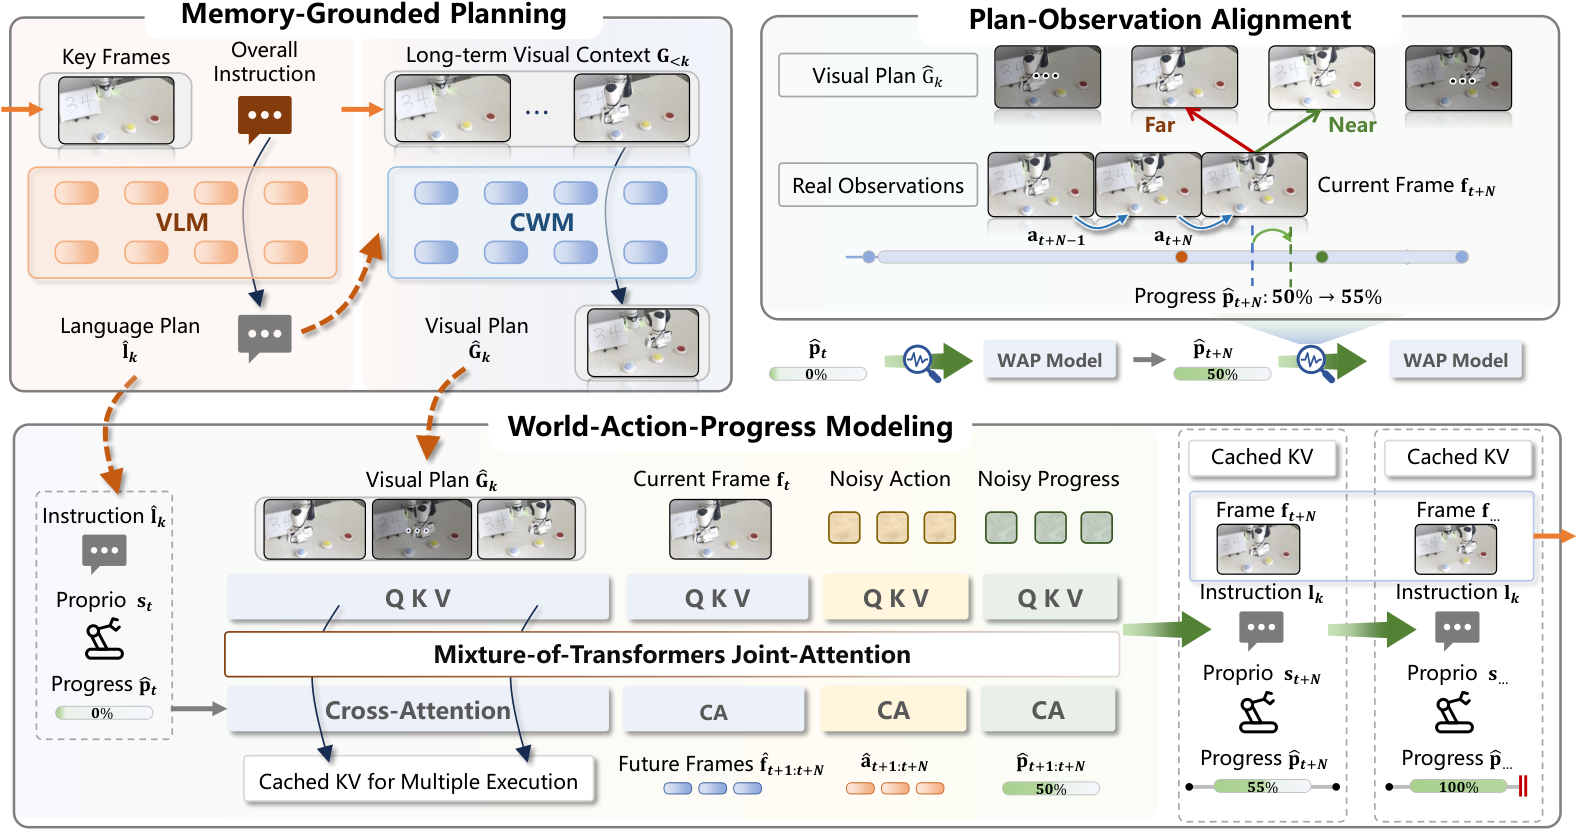
图 2 如何连接历史证据、视觉计划、动作块与真实记忆更新?
- 1
将完成片段保存为真实证据
图左上每段记录语言指令和八个均匀采样画面,初始图另存;语言规划器读取初图与各段末帧,CWM视觉规划器读取更丰富的历史稀疏序列。训练使用基准提供的分段标注,不是自动发现任意任务边界。
- 2
生成下一段语言—视觉计划
微调 Qwen3.5-4B 先给出子目标,Wan2.2 初始化的因果世界模型再给八帧视觉引导。分段因果注意力允许历史缓存,但规划历史仍会增长;固定的是执行阶段的计划输入长度。
- 3
联合预测动作和进度
图下 WAP 的视频、动作、进度专家联合训练,动作和进度不能读取未来视觉目标。训练预测32步,部署执行前8步;未来视频分支在部署可省略,当前进度作为条件反馈,避免把外观相近的不同阶段混淆。
- 4
以视觉匹配校准并切换计划
图右上在当前进度附近选两个计划帧,用RGB平均绝对差找较近者,与递归进度取平均。预测完成分数超过0.95时进入下一段;写入历史的是实际执行帧,替换生成计划,避免把想象当成已发生事件。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【模拟协议】RMBench每任务50示范、100次评估,全局seed0;规划器多任务、WAP单任务。平均83.3%,LingBot-VA77.1%,但Rearrange Blocks为66%对100%。 表 1 与第 4.2 节 ↗
我的解读我的解读:总体提升不代表每类记忆都更好;固定种子和按任务执行器限制跨任务泛化结论。
来源证据【真实与消融】Franka两项任务各50次,Find Button88%、Press Buttons68%。三任务进度消融完整平均96.7%,去校准73.7%;Press Button单项去校准98%反高于96%。 图 3、表 2 ↗
我的解读我的解读:视觉校准主要帮助长序列漂移,不能说所有任务必需;两项真实任务也不足以涵盖复杂环境。
来源证据【延迟口径】单A800、BF16、10去噪步下缓存后执行器约827ms/块;排除模型加载、提示编码、传输、VAE与前缀预填充。 图 5 与附录 H ↗
我的解读我的解读:这不是完整动作回路延迟,也不是整个系统恒定时间。简单RGB匹配对光照和遮挡的敏感性尚需实测。
开放情况与使用许可
作者项目和仓库已核实;仓库目前只有 README,训练/推理代码及检查点均标为待发布,不能称为实现开源。
LICENSE论文及图 2 为 CC BY 4.0;尚无可核实的实现或权重许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把历史取证和短期控制分开,减少执行器重复处理长视频,同时用真实观察更新记忆闭环。
反方 · 哪些结论还不够
依赖分段监督,训练用真实计划而部署用生成计划;RGB校准和规划成本尚不能由执行器曲线覆盖。
综合判断
适合明确可分段、记忆负担高的操作研究;实际采用前要测试自动分段、计划偏差及端到端延迟。
我会先做的验证
未执行的验证方案:固定演示数量,在遮挡/灯光变化与段边界扰动下比较语言记忆、完整历史、MaP-WAM;分别计规划、缓存建立、VAE和动作延迟,并按长短任务测漏按/重复操作。