记忆还是上下文:一次事实冲突测试为什么会随问法翻转
31 个模型、六类事实与五种提问模板,区分参数知识和实验测量
这项研究向模型提供与已知事实冲突的短文本,检查回答更接近参数记忆还是眼前上下文。模型规模、事实频率、问法和填充文本都影响结果;最值得关注的是,同一模型的“偏好”会因测量模板大幅翻转,不能把单次冲突测试当成稳定知识属性。
图解主要方法
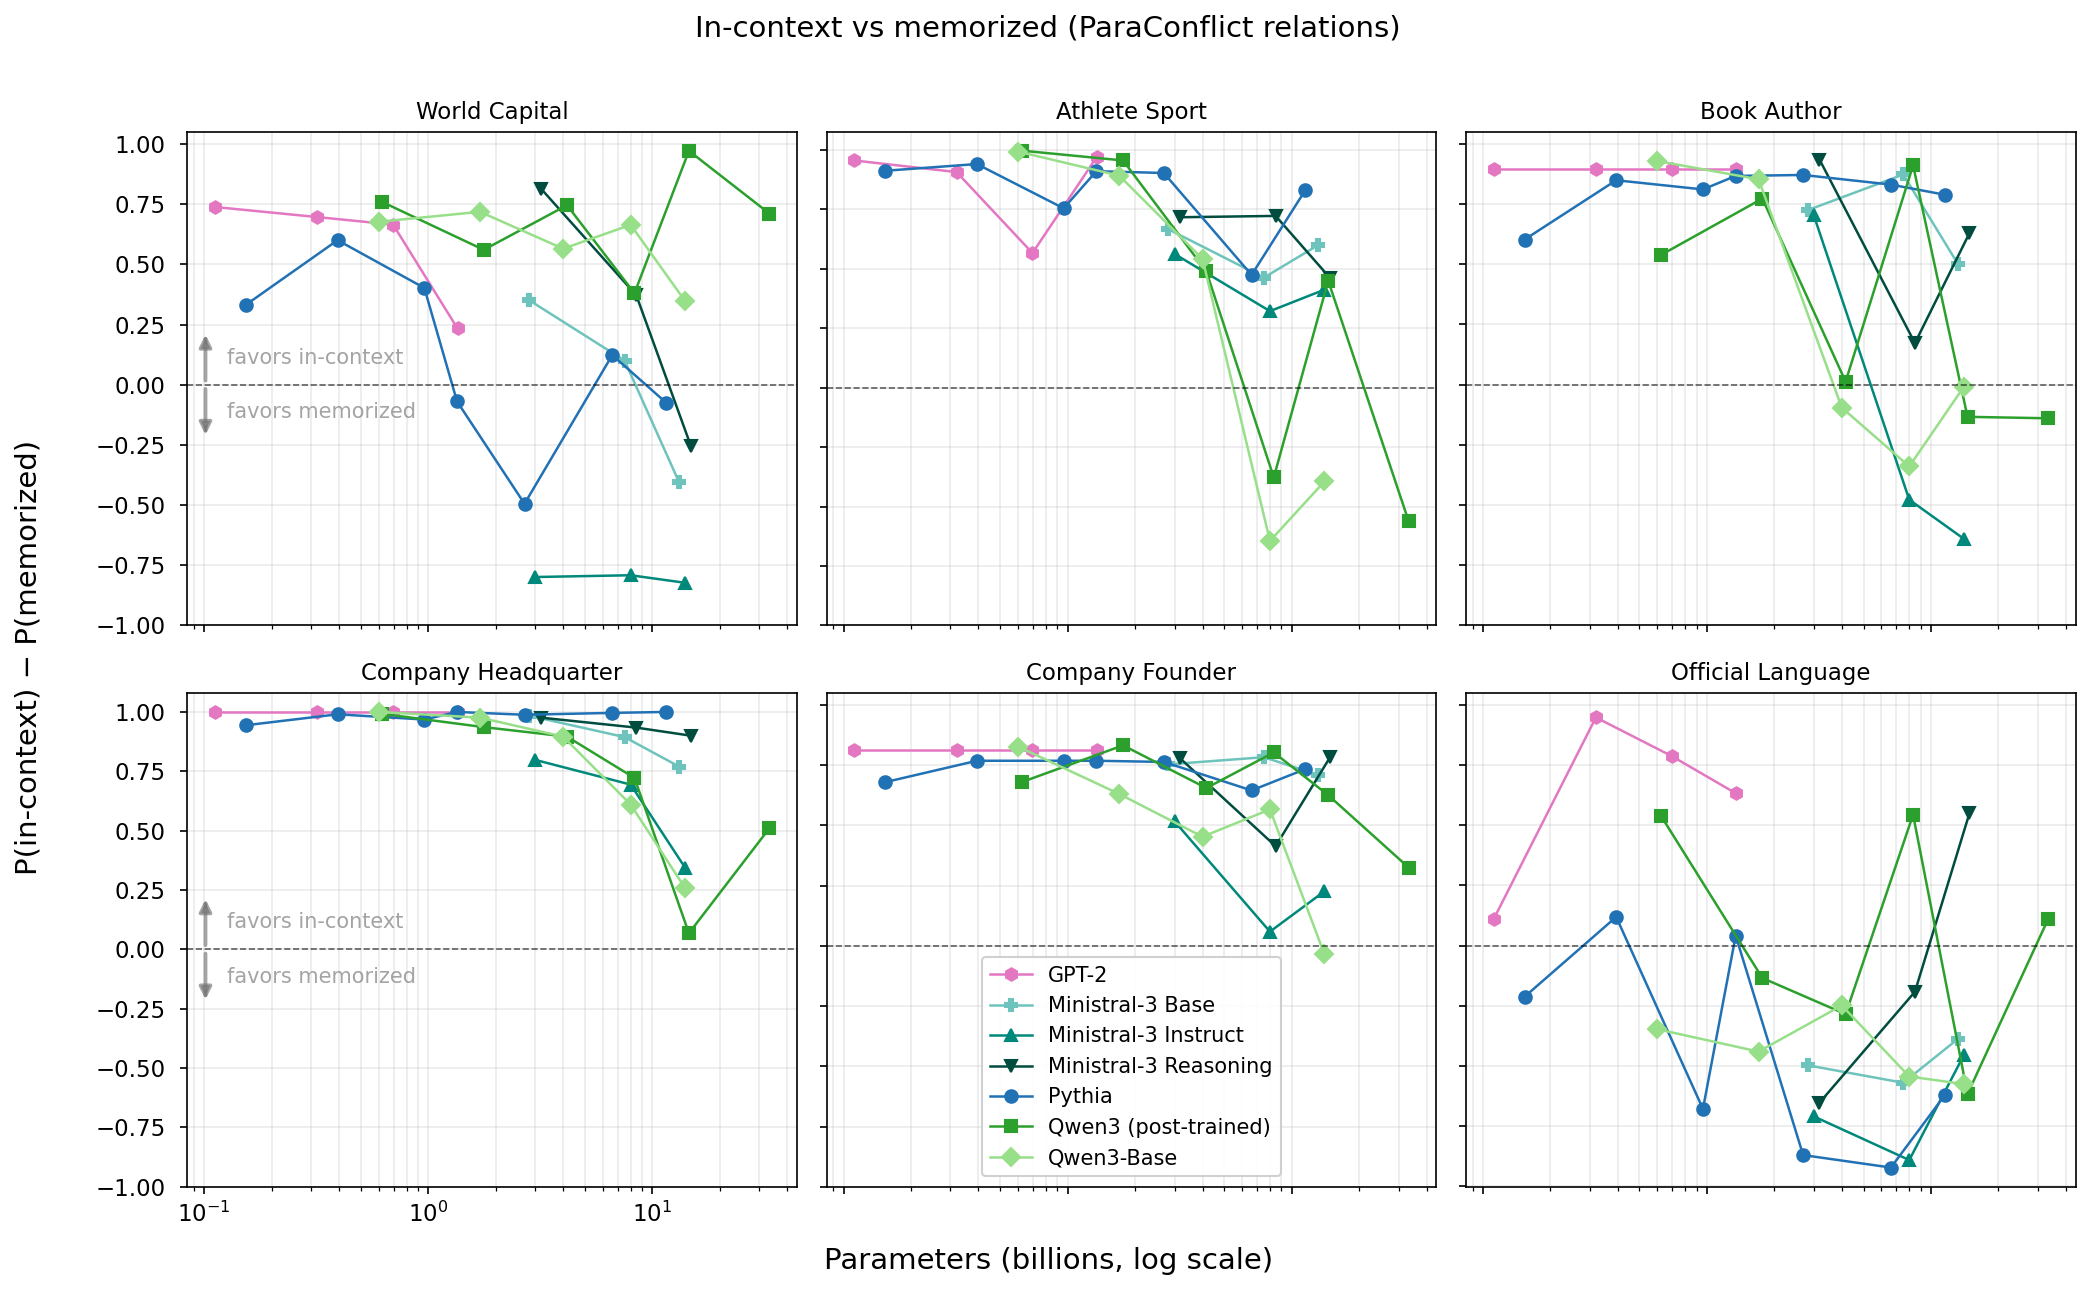
原图 1 的上下文—记忆分数测到了什么,哪些因素能改变它?
- 1
建立冲突,而不是默认模型一定知道答案
首都实验把 218 个国家与错误首都配对,得到 47299 个冲突提示;另加入作者、公司总部、创始人、运动与官方语言等五类关系。干净问题上的召回也要检查:不知道正确事实的模型选择上下文,不代表主动压制了已有知识。
- 2
分别看自由生成和两候选概率
生成评估使用贪心解码与 10 个新 token,并按答案别名判断;另一通道比较完整候选答案的 teacher-forcing 对数概率。前者会遇到拒答、双答案和截断,后者只比较给定两项,二者都不是直接测量参数中“存了多少知识”。
- 3
控制问法、填充长度和冲突位置
实验更换问答式、裸问句、所有格以及暗示已有知识的五类模板;加入生物学段落、真假首都噪声等,长度从 0 到 1024 token。相同事实内容必须按模板分别报告,不能只挑最支持假设的问法。
- 4
用图 1 看模型差异,再用分层分析排除混淆
图中正分数表示更偏上下文,负分数偏记忆。规模相关性是跨模型观察,不能解释为单纯增加参数就会造成该变化;不同模型家族和后训练同时变化。词频来自外部频率代理,也不等于模型实际预训练曝光次数。
- 5
把 logit lens 当成可读出性证据
逐层投影显示候选答案何时能从隐藏状态读出,但未进行因果干预,不能据此定位“事实储存层”。附录所有模型都采用原始补全格式、没有聊天模板,10-token 限制尤其可能不利于推理模型,产品对话场景需要重测。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【表 1、31 模型】六关系汇总的规模—记忆倾向 Spearman ρ=+0.53。 表 1 与频率附录 ↗
我的解读这是混合家族的关联;频率假设仅在 17/31 模型中得到支持,不能写成普遍规律。
来源证据【附录 K】Qwen3-14B 在不同问法下,记忆回答比例可从 0% 到 95%;这是特定模板实验。 附录 K,模板敏感性 ↗
我的解读问法可以改变结论方向。它不是整套数据平均提高 95 个百分点,也不等于知识被新增或删除。
来源证据【表 2】后训练相对基础模型的六关系均值变化:Qwen −12.7 个百分点,Ministral Instruct +20.9,Reasoning −5.0。 表 2 ↗
我的解读不同家族甚至方向不同,不能将“指令训练使模型更听上下文”当成统一结论。
来源证据【图 2】Pythia-2.8B 在一组生物学填充条件下,0 到 128 token 的上下文回答由约 29% 到 93%。 图 2 与填充实验 ↗
我的解读内容连贯性、长度和位置均会影响测量;其他家族并不保证同幅收益。
开放情况与使用许可
已核实作者仓库包含评估脚本、数据构造与预计算汇总,并打开 evaluate_capitals.py;未找到仓库 LICENSE,代码可见不等于许可明确,未在本机复现实验。
LICENSE论文 CC BY 4.0;软件许可未明确。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把提示格式作为自变量公开,能帮助 RAG 和记忆系统识别评估不稳定性,而不是只比较一个总分。
反方 · 哪些结论还不够
原始补全格式与短生成上限限制了结论向聊天及推理产品迁移;logit lens 和词频关联也不能替代因果证据。
综合判断
适合作为事实冲突评估的设计检查表,现有证据支持“测量条件很重要”,不支持给每个模型固定贴上信上下文或信记忆的标签。
我会先做的验证
未执行的验证方案:固定同一事实库,同时测试原始补全、正确聊天模板和足够推理预算;加入真实过期文档、可信来源标记与拒答选项,报告逐事实覆盖率及置信区间。