MDL:检索到的记忆,什么时候应该拒绝使用
低幻觉率与高拒答率必须放在同一张成绩单里
Memory Decision Layer 在检索与生成之间加入可解释门控,用相关性、记忆间可靠性和任务风险决定主动使用、辅助使用、忽略或拒答。关键不是“零参数消灭幻觉”,而是阈值怎样影响回答覆盖率,以及简单启发式是否足以识别真实冲突。
图解主要方法
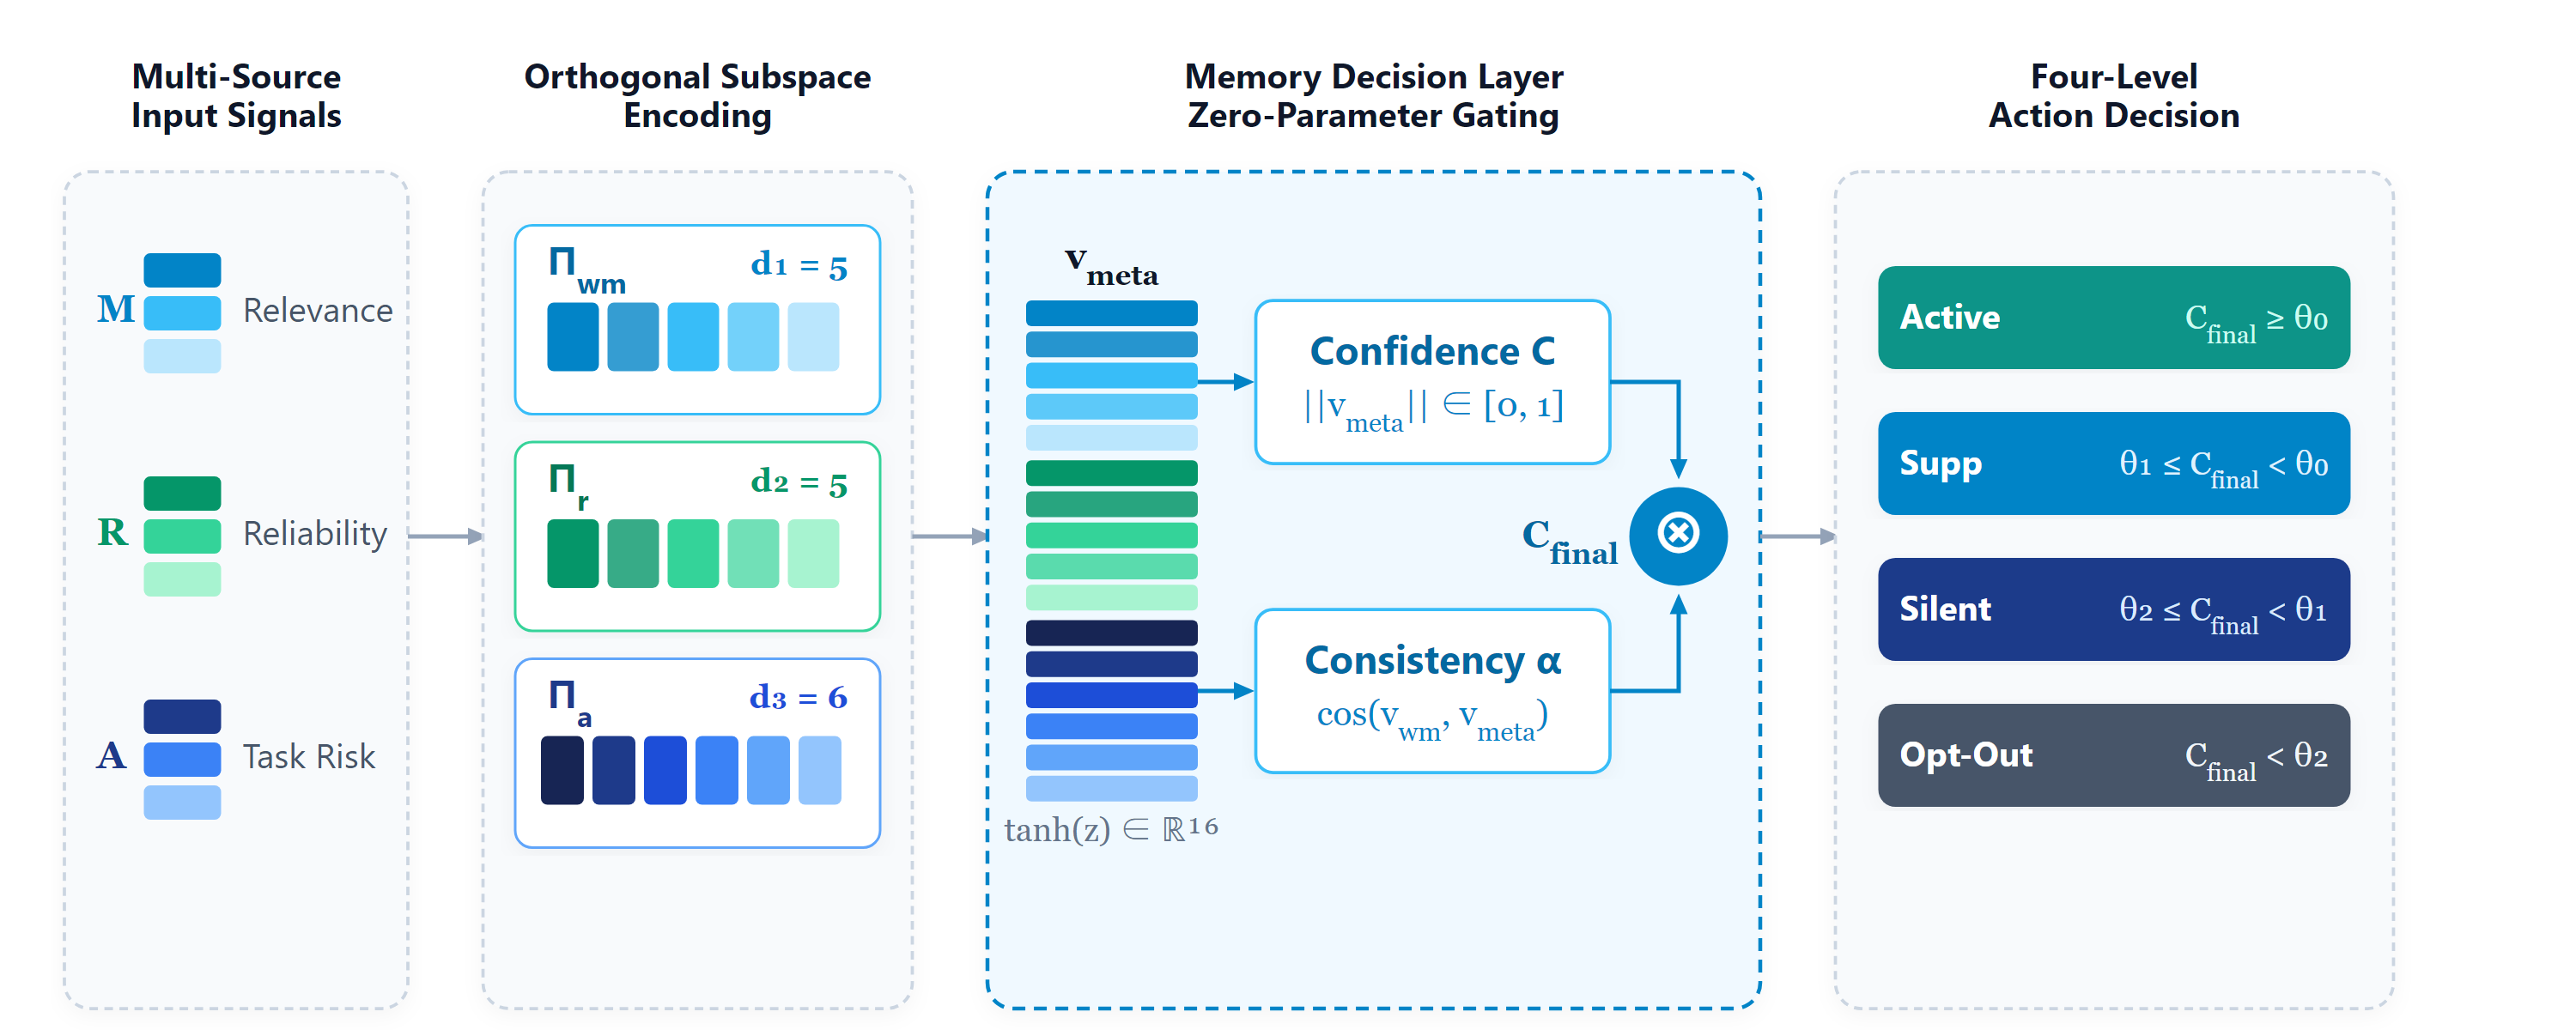
图 1 的三个信号怎样变成四种决策,实验又付出了多少拒答代价?
- 1
图 1 左:把相关、可靠与风险分开
M 取问题和记忆的最大嵌入余弦;R 对相关记忆计算两两相似度,再乘词汇冲突率的惩罚,少于两条时设为 0.5。冲突检测依赖否定词、反义词等规则;风险 A 由类别和关键词赋值,再用 1−A 抑制高风险注入。这些信号不是经过事实核查的真值。
- 2
图 1 中左:在固定子空间编码三个标量
各标量经高斯形状编码进入 16 维表示,用 QR 构造的 5/5/6 维正交子空间投影,再加固定增益、少量跨空间混合与 tanh。正交化方便追踪信号来源,不意味着自然语言里的相关性与可靠性真正独立。
- 3
图 1 中右:幅度和方向共同决定分数
归一化向量范数作为置信度 C,相关性表示与汇总表示的余弦作为一致性 α,再组合 Cfinal=C(0.3+0.7α)。两个数在实验中相关系数约 0.902,因此“解耦”是计算接口的区分,不是统计独立。
- 4
图 1 右:分数映射到使用、辅助、静默与退出
四档阈值决定给生成模型什么记忆及是否明确拒答。系统没有通过梯度训练的控制器参数,但会使用每数据集 80 条留出问题标定阈值与归一化范围;不能把 zero-parameter 翻译为无需校准、没有超参数或不会过拟合。
- 5
回到实验的记忆与评价构造
记忆由基准的正确答案、错误答案和干扰项构成;幻觉评价使用 MiniLM 与正确/错误参考的相似度规则,并将拒答计为安全。这是受控冲突记忆测试,不是自然企业知识库的端到端事实审计。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【Gemma 实验】150 道问题、两个种子,标准 RAG 幻觉率 53.0%,MDL 23.3%,无记忆基线约 23.0%。 正文结果与附录实验设置 ↗
我的解读相对 RAG 下降约 56%不代表相对无记忆有同等改善,且收益取决于基础模型受错误记忆影响的程度。
来源证据【DeepSeek 实验】200 道问题、三个种子,TruthfulQA 总体幻觉率由 RAG 0.043 到 MDL 0.047,HaluEval 由 0.065 到 0.070;高风险子集部分改善。 跨模型结果 ↗
我的解读总体数值略差与高风险改善可以同时成立。不能把 Gemma 上的降幅推广给所有模型、数据集和风险等级。
来源证据【表 5–6】另一组 200 题、两个种子的比较中,MDL 拒答率 87.7%,幻觉率 4.8%;RAG 分别为 88.0% 与 4.8%。移除 QR 的决策准确率 64.0%,完整模型 61.2%。 表 5、表 6 ↗
我的解读高拒答会降低被计为幻觉的机会;还应比较回答覆盖率和已回答问题准确率。消融未证明完整几何构造必不可少。
来源证据【时延实验】约 0.14ms 包含轻量信号处理,使用预先算好的嵌入和少量记忆;附录与正文硬件描述存在差异。 效率段与附录 ↗
我的解读不能把这个局部门控时间当成嵌入、检索、模型生成的总延迟,本次不据此给出端到端加速结论。
开放情况与使用许可
论文称代码采用 MIT,但全文未给出可核实的发布地址;本次未确认正式仓库,不能按代码已开源标记。
LICENSE论文为 arXiv 非独占分发许可;作者声称的 MIT 软件许可尚未通过实际仓库核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
门控动作和输入信号可追踪,便于定位究竟是检索失败、冲突检测失败还是阈值过严。
反方 · 哪些结论还不够
高拒答和多项消融反例削弱了“完整设计普遍更优”的主张;零训练参数不等于无校准偏差。
综合判断
问题值得跟踪,现有证据更支持受控实验中的拒答机制,尚不足以宣称普遍可信的记忆层。
我会先做的验证
未执行的验证方案:用人工核验的自然检索库加入过期、矛盾和同义干扰,统一回答覆盖率比较 MDL、简单阈值与无记忆基线;报告风险—覆盖曲线、已回答问题准确率与全流程延迟,阈值仅在训练侧选择。