Memory Tax:记忆系统帮对了多少,也答错了多少
结构化记忆的净收益应如何与可检索的原始记录比较?
论文将记忆收益拆成两组题:记忆答对而 RAG 答错,以及 RAG 答对而记忆答错。后者是“记忆税”。通过金标准检索与信息保留审计,作者区分记录构造损失和访问损失,避免只用平均准确率解释复杂记忆系统。
图解主要方法
结构化记忆的净收益应如何与可检索的原始记录比较?
- 1
建立足够强的原始记录基线
原始对话按约1024字符切块、不跨会话,使用 BM25 与 Qwen embedding 混合检索和重排;两轮RAG可判断是否需要补查。因此这里的“naive”不是只做一次简单向量查询。
- 2
按题计算收益与税
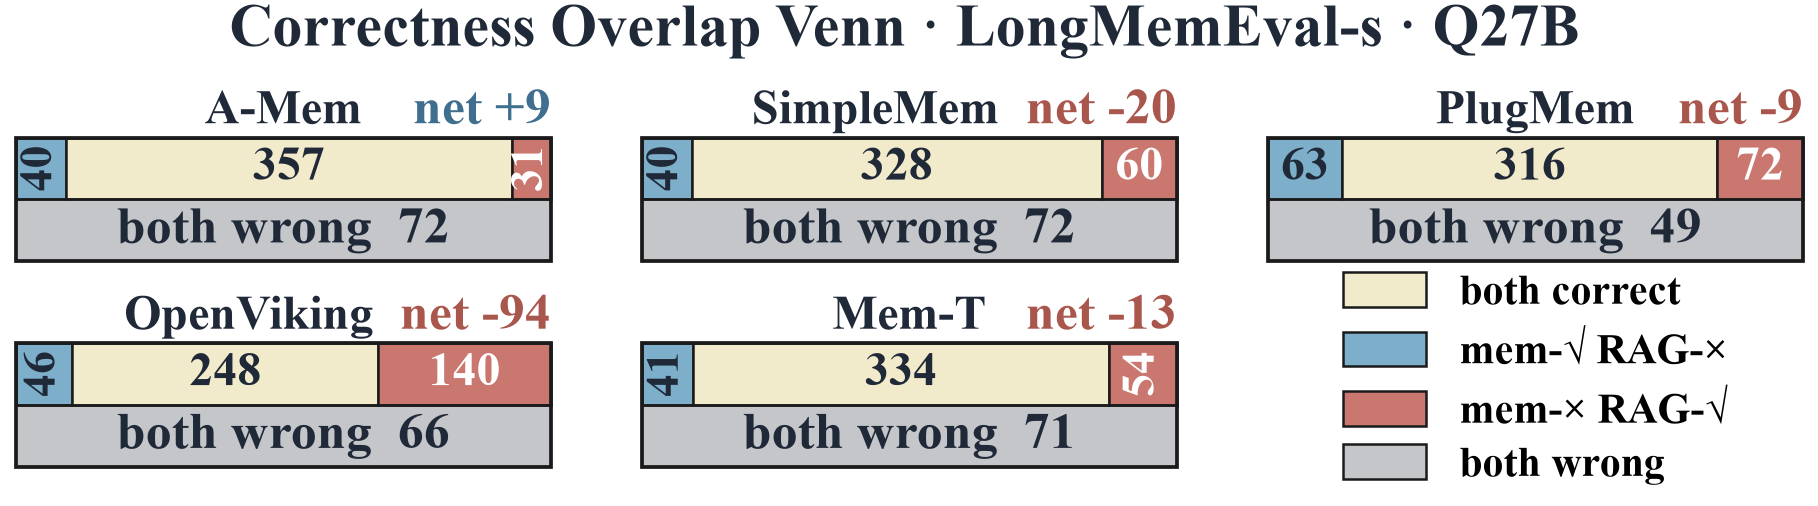
图2展示相同问题上的正确性重叠。记忆独有正确减去RAG独有正确才是净收益;图中税以一轮RAG为参照,不能直接套用二轮RAG的平均分。
- 3
用 oracle 拆开两类损失
将检索替换为金标准记忆单元,检验访问瓶颈;再与原始记录和人工映射核对构造时是否遗漏。扩大检索范围表示暴露的库内token比例,不能误写为所有系统输入token预算相同。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据11个记忆系统、3个回答骨干。LongMemEval共500题,但Luna仅100题;PersonaMem为40个人物934题,MINT为60语料1557题。LME二轮RAG在三骨干为72.2/81.4/90.0,A-Mem为70.4/79.4/84.0。 表1与附录基准 ↗
我的解读系统排序随骨干与任务改变;MINT上部分结构化系统更强,不能概括成“记忆无用”。
来源证据500条原始轮次人工审计中,MemoryOS有98.4%未丢失信息,却仍有回答损失;OpenViking则出现大量无法映射到单元的记录。 信息审计与访问分析 ↗
我的解读存在不同机制的税:保存下来未必能找出来;不应把所有退化都归咎于压缩。
开放情况与使用许可
官方仓库有 common、reproduction 目录及 MIT 许可;README仍将各基线复现代码列为未完成,不能称全套复现已开放。作者提供结果数据入口,完整性未下载审计。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
逐题反事实比较和 oracle 访问将平均分展开为可定位的故障,适合用于长期助理的记忆质量审计。
反方 · 哪些结论还不够
静态离线、主要英文对话;裁判仍有误差。检索比例不等于等token成本,跨系统构造模型与训练策略也不完全一致;尚未证明线上长期自更新时的净收益。
综合判断
选记忆系统时应同时看净准确率、成本和原文可恢复性,而非记忆条目数量。
我会先做的验证
未执行的验证方案:保留同一批原始记录,对同一问题并行测原文RAG和记忆库,按题保存收益/税;固定token预算,再加入金标准检索以区分存储与访问损失。