MemoType:按事件、个人与一般知识分流的长期记忆检索
类型路由改变检索策略,但过滤召回、评测泄漏与在线成本仍需拆开验证
MemoType先把对话记忆分为事件、个人和一般知识,再针对事件对齐要素、针对个人反推可能问题、针对一般知识生成假想记忆进行检索,最后用两次回答筛除无关记录。四个基准显示收益,但类别硬过滤并非所有召回指标都更好,低写入费用也不等于低端到端成本。
图解主要方法
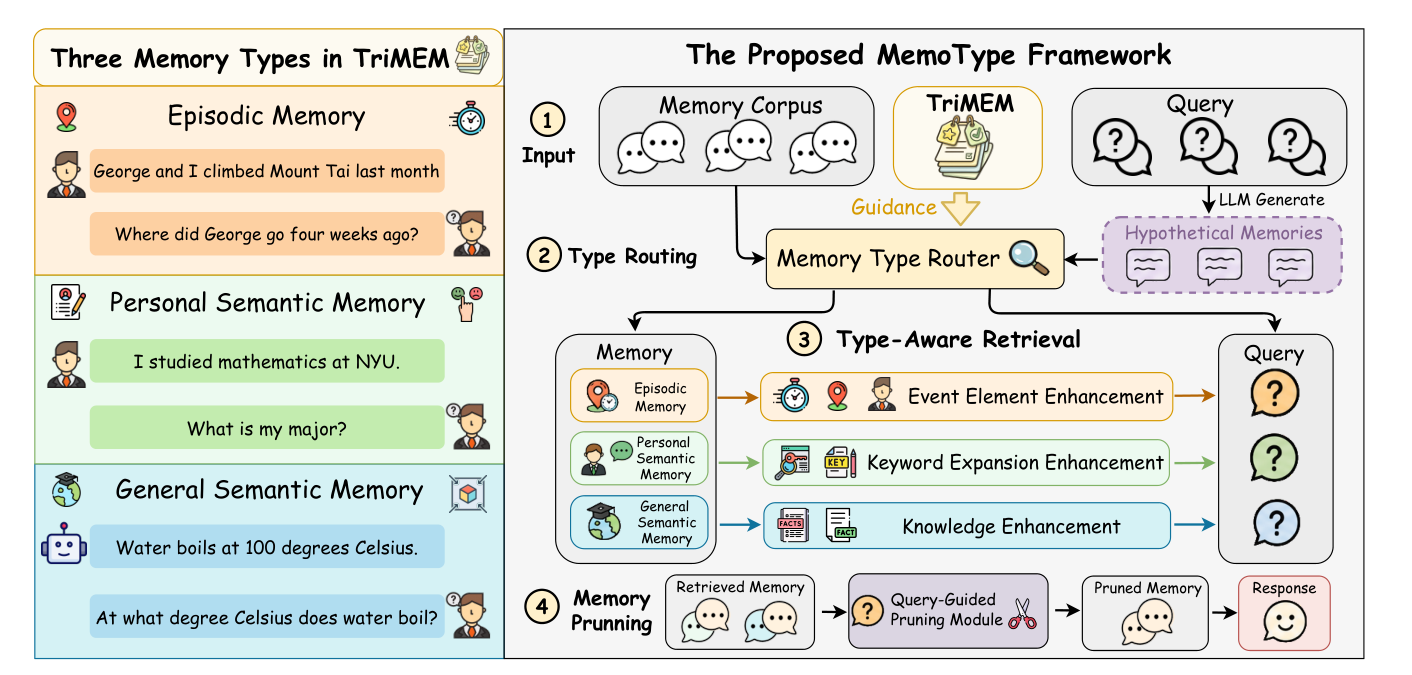
图2如何把三类记忆变成三种检索操作,哪些收益来自额外调用?
- 1
先把存储记忆标成多标签
图2左侧将事件记忆EM、个人记忆PM和一般记忆GM分开;一条可多类或无类。作者用6000条TriMEM训练Qwen3-1.7B的LoRA路由器;训练脚本为3轮、学习率2e-4、秩16,并未自行构造留出集。t-SNE聚类图只提供动机,不能证明原空间类别天然可分。
- 2
给短查询生成路由代理
查询信息不足时生成5条假想记忆,投票决定主策略,并用候选类别并集筛选真实库。它们是寻找记忆的代理,不是事实。类别筛选先减少候选,也可能永久丢掉与当前问题相关的另一类证据,需另设回退。
- 3
按类型改变表示并融合排名
EM对齐时间、地点、参与者与事件;PM从每条记忆反推可能问题,以最大问题相似度匹配;GM把查询扩为假想记忆做HyDE。图2中PM的关键词增强标签是概略表达,正文和代码实际使用反向问题生成。实现再用RRF融合原始、HyDE及类型特定排名,细节并非只靠一个分类器。
- 4
从候选证据生成、筛选、再回答
图2末端的剪枝在附录实现为先生成答案和支撑索引,再用入选记忆重新回答,因此包含两轮生成,而非免费的二元过滤。假想查询、PM增强和剪枝调用都应计入上线成本;论文写入费用表没有涵盖完整请求路径。
实验与证据
已阅读v1完整正文、附录A–F与检查表;检查仓库固定提交73c5380、完整目录、6000行TriMEM及路由训练/检索实现。全部数值为作者报告,未独立训练或复现。
来源证据【主检索】Contriever、GPT-4o-mini、温度0;LME-S的R@1为59.15,对照LightMem56.99;LME-M为48.09,对照SeCom31.91,差16.18个百分点。LME-S的R@10为92.77,低于HippoRAG2的93.53。 主实验检索表 ↗
我的解读我的解读:收益依赖截断深度,不能写所有指标领先;M集若干大方法因构建成本未跑,领先只对应实际报告的对照。
来源证据【回答与消融】LME-S裁判分56.8,对照A-Mem47,相差9.8点;裁判实际使用GPT-5.2。只加类别筛选使R@1从43.40到50.21,但R@10从94.26到92.34。 问答表、分类与剪枝消融 ↗
我的解读我的解读:分类提高前排纯度同时牺牲后排覆盖;回答收益不能仅归因检索,因为剪枝又调用生成器。主表和剪枝表F1也有20.13/20.31差异,应分表解读。
来源证据【费用口径】作者报告LME-M付费写入约3.77美元;对照HippoRAG2约548.98美元由5/500对话外推。表中未涵盖本地路由训练及全部在线调用。 费用分析与附录实现 ↗
我的解读我的解读:这不是完整账单或延迟测量,不能宣称端到端便宜146倍;尤其PM反向问题与两次回答的成本需逐调用补记。
来源证据【理论与数据】定理3.3对独立抽样查询、文档的类别混合平均内积给上界。TriMEM改写下游同源对话;仓库默认训练脚本使用完整CSV,未提供同脚本内的训练/测试分离。 定理3.3、附录数据与训练代码 ↗
我的解读我的解读:即使不同类别完全正交,每个查询仍可把同类正确文档排第一,故平均相似度界不直接限制召回。改写也不自动切断结构泄漏;这属于复现和泛化证据缺口,不是已证明发生作弊。
开放情况与使用许可
公开仓库含实现及6000行TriMEM;检查固定提交未见路由模型权重。README声称MIT,但所链接LICENSE缺失,目录也无对应许可文件,暂不认定授权已核实。
LICENSE代码和数据授权范围尚未确认。论文采用arXiv非独占托管许可,图2版权归作者,仅作必要方法评论,不等同于图片开放授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
按类型选择策略比单一增强更好,且多项消融显示类型划分和增强各有作用;可追查的实现与数据让部分复现条件可检查。
反方 · 哪些结论还不够
同源数据改写与默认脚本无留出划分,使泛化证据需要独立数据审计;附录图19的多类基线提示将事件记忆误写为一般知识,可能影响对照公平性。
综合判断
这是有实证支撑的类型化检索方案,但不能把平均相似度理论推成单一策略必然失败,也不能把部分召回提升和写入费用优势外推为普遍更准、更便宜的助手。
我会先做的验证
未执行的验证方案:在改写前按原始对话族隔离训练与测试,公开留出清单;修正图19事件定义,在统一模型和调用预算下比较。计入路由训练、假想问题/记忆、两次回答的完整成本,报告跨类型任务召回、答案质量、置信区间与回退收益。