Meta Expert:跨层共享专家,减少 MoE 存储冗余
不同层是否必须各自保存一整套专家?
Meta Expert 把部分 MoE 专家从层私有改成跨层共享,并保留局部专家和注意力层。在相同激活专家数量下,一些模型可用约70–80%的专家匹配基线损失;这支持参数复用,但不等于推理延迟同比下降或每项任务都提高。
图解主要方法
不同层是否必须各自保存一整套专家?
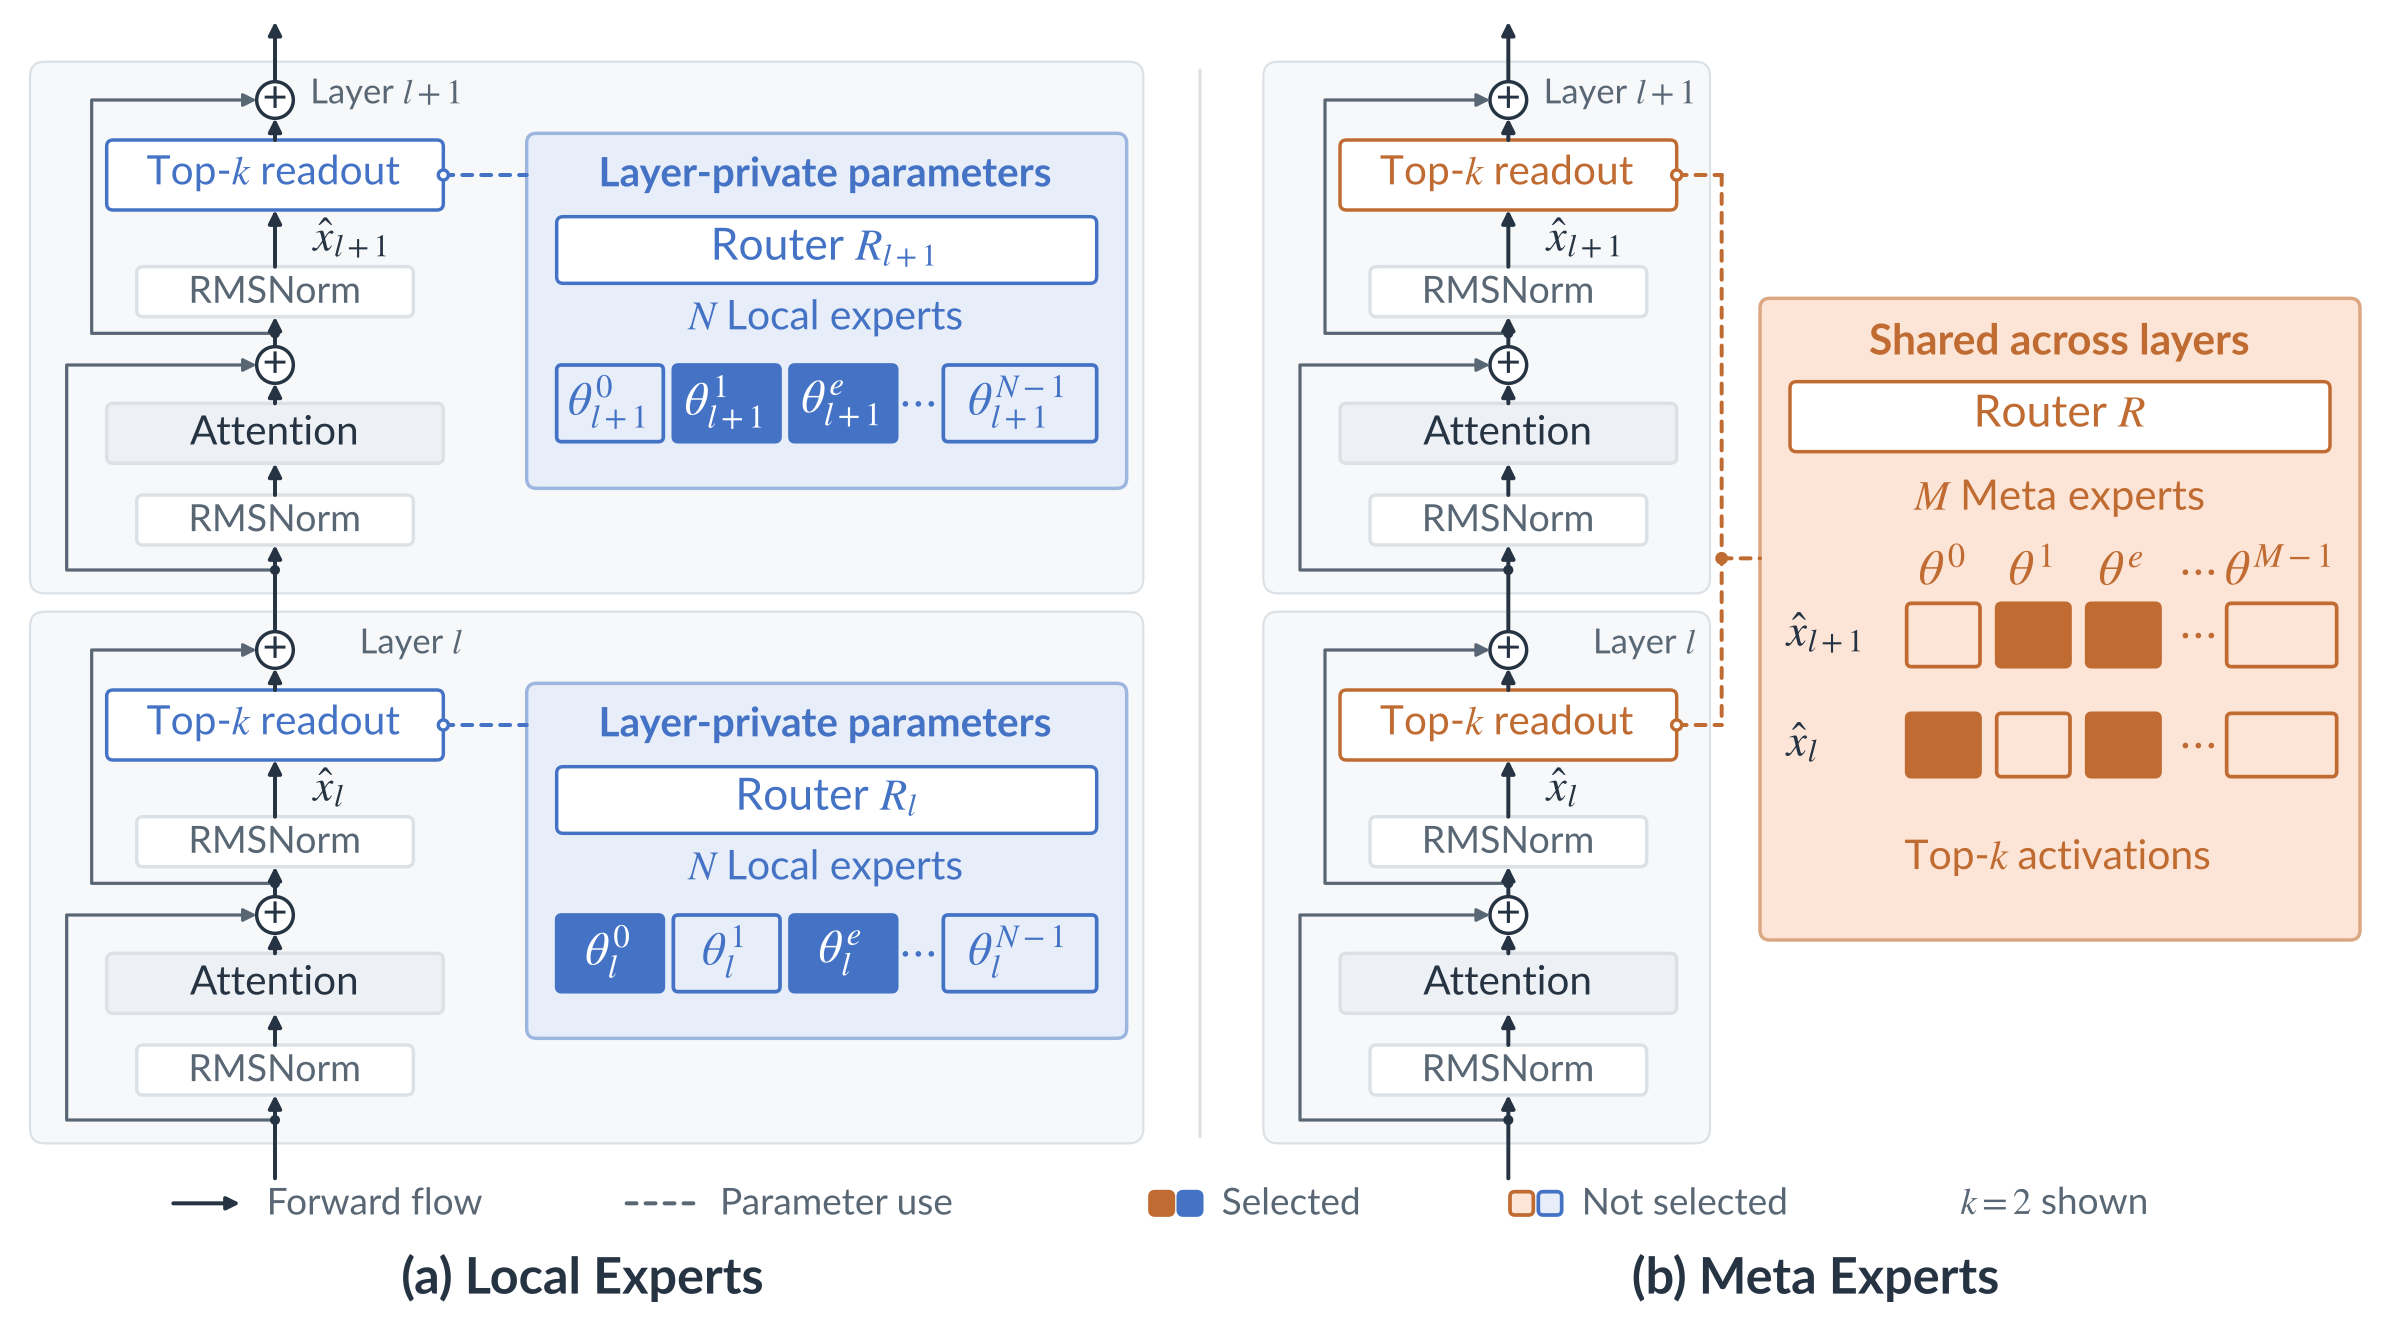
- 1
第一步:把层私有专家改成可跨层调用的池
图2左边的普通MoE在每层放一套路由器与专家,右边把橙色专家池及其路由跨层共享,蓝色注意力和局部参数仍属于各层。同一个专家因而可处理不同深度的隐藏状态;共享的是权重,不是把未来层激活送回当前层。
- 2
第二步:控制总专家数与每次激活量
比较同时固定专家粒度和每层top-k激活预算,部分实验保持总专家数为128乘层数。MR75指总专家配置中共享专家的比例,不等于每个token有75%激活计算来自共享池;对应配置可为4个共享加4个局部专家。这一区别决定参数节省与实际算量不能混为一谈。
- 3
第三步:用局部边界和分池缓解跨深度冲突
作者比较全局池、交错子池以及保留首尾局部层的拓扑。F2L2保留前后各两层局部结构,Loop2将共享调用分到两个交错池。这里的Loop是共享拓扑,不意味着额外反复执行层;保留局部专家给特定深度的需求留出容量。
- 4
第四步:区分训练的信息交换与推理路径
附录A4分析共享参数同时收到多层梯度,使某层学习到的信息能通过权重更新影响其他层。该作用发生在训练时;推理仍按因果顺序前向计算。CKA、谱和Gini分析用于观察冗余与分布,不是直接测量知识容量的量尺。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据H200实验覆盖12、16、20、24层,训练token分别约5.31B、11.06B、20.47B、34.92B。作者报告约70–80%专家数可匹配普通MoE的损失。 §3,缩放阶梯 ↗
我的解读主要损失取训练最后10步,不能当作独立留出集泛化成绩。专家数量节省比不同段落中略有出入的总参数比例更适合准确引用。
来源证据MR75 Loop2的MMLU为41.75,普通MoE为40.87;但结合F2L2的Loop2配置为40.52。MR75的BBH为29.12,对照29.72。 下游任务表,6B-A1.6B / 200B token ↗
我的解读跨层共享在部分设置中改善效率,但拓扑组合并不单调增益。不能将最佳配置的各项结果拼接成一个全胜模型。
来源证据论文提供共享比例、深度和拓扑消融,以及关于残差路径与梯度交换的分析;没有给出生产服务端吞吐或端到端延迟对照。 附录A1–A4,结构与理论 ↗
我的解读参数驻留减少可能有利于显存,但跨设备共享池通信与负载集中可能抵消收益;这是需要实测的工程问题。
开放情况与使用许可
2026-10-25核查:论文与原图以CC BY 4.0公开;本轮未核实到作者发布的对应训练实现或模型权重,因此不标记代码已开源,也不把论文可读视作可复现包已齐备。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:MoE扩容通常把专家数量当主要杠杆,这篇工作把跨层重复存储变成可控制变量,给显存受限训练和部署提供了值得测试的结构选择。
反方 · 哪些结论还不够
训练损失与少量下游收益不足以证明服务效率;共享池可能引入跨层梯度冲突、热点路由和通信成本。下游有退步项,也没有延迟实测支持等比例加速。
综合判断
适合研究参数效率,而不是直接替换生产MoE的成熟方案。先在固定激活算量、数据和并行策略下验证,再判断共享池是否值得迁移。
我会先做的验证
未执行的验证方案:用同一数据顺序和三个随机种子比较普通MoE、MR75及Loop2,固定top-k和训练FLOPs;同时报告留出损失、MMLU/BBH、专家负载、峰值显存、跨卡通信及固定batch吞吐。