MiMo-V2.6:规模化RL之外,怎样避免奖励把错误行为放大?
任务、框架与评分共同扩展;9B开放权重不能等同旗舰模型开源
MiMo把长轨迹RL扩展到代码、通用、视觉和安全任务,结合多种轻量agent框架。离线组间比较生成rubric,在线组内评分重分配成功轨迹的正优势;冻结MoE路由、回放采样条件,并持续清理奖励捷径。
图解主要方法
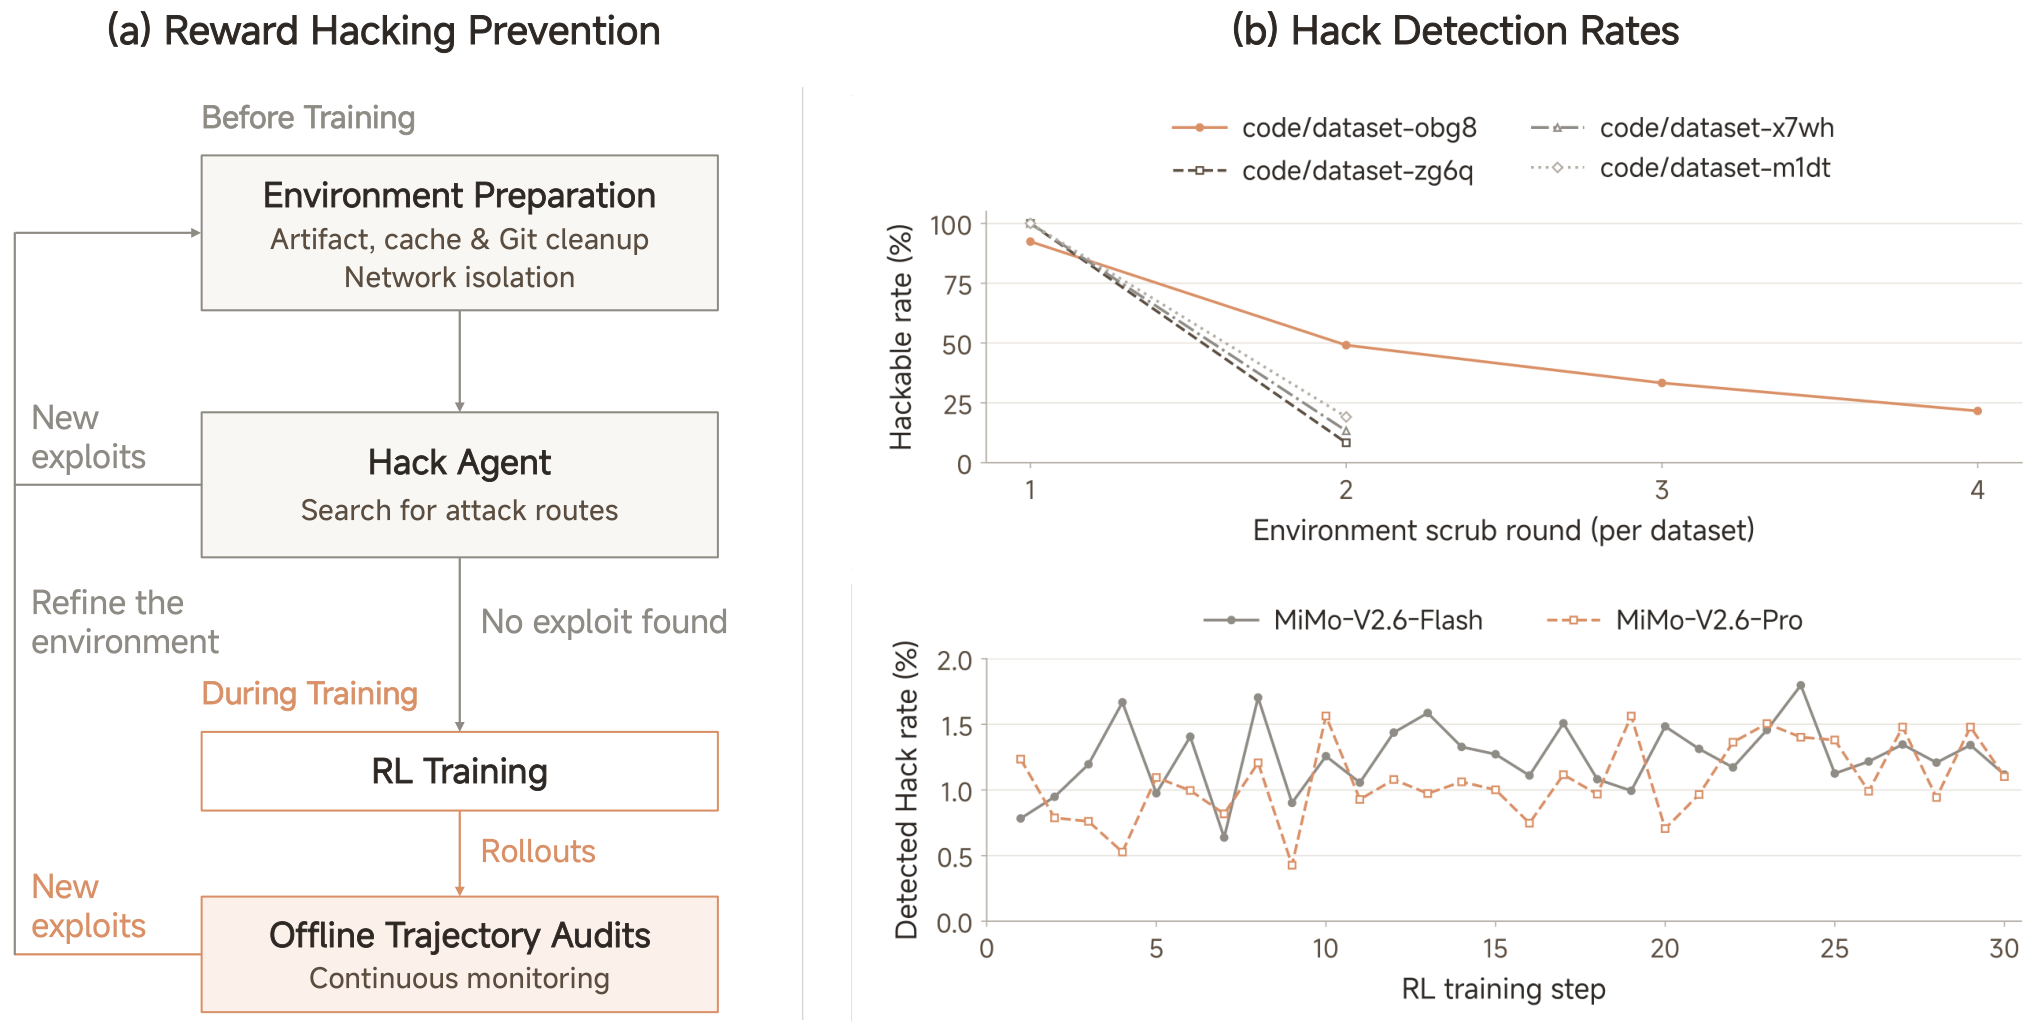
图6的训练前筛查与训练中审计有什么区别,为什么检测率不能代表实际投机率?
- 1
先扩大探索能力,再组织异步长轨迹
Pro总1.02T激活42B,Flash总310B激活15B;滑窗128与全局注意力交替。mid-training扩到1M上下文并用Muown;RL每步1568个prompt各16rollout,约25088轨迹、27–37亿token,不能把1568误写成总轨迹数。
- 2
先清理奖励捷径,再持续审计
图6左侧清理缓存、构建残留和未来Git历史,网络隔离后由专门agent找漏洞,训练期间继续看离线轨迹。右侧曲线是“被检测到”的比例;未发现新的漏洞不代表不存在漏洞。
- 3
分别处理全通过组和混合结果组
GRS为高通过率任务先离线构造实现/行为rubric,奖励等于测试结果乘两个质量分。GAR在线比较混合组,确认投机先归零,再按质量因子重分配成功轨迹正优势;放大因子有上限并重新减组均值,失败轨迹也参与后处理。
- 4
约束训练漂移并分开评价蒸馏
冻结MoE router避免负载坍缩,回放推理专家索引与top-p候选集对齐概率。Sample Mixer按耗时和接受率分配并发,局部rollout跨版本恢复。最终MOPD2从教师轨迹或SFT前缀让学生生成新一轮,并非把固定答案再次当SFT。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据Pro与Flash RL费用分别260万和90万美元,DeepSWE训练曲线58.4→72.6、48.7→65.7;Pro评分器占费用12.7%。 §4.1 / 图3 / 表3 ↗
我的解读是作者一次训练过程记录;最终表中的71.9/67.9另含后续流程,不能把不同阶段终点互换。
来源证据冻结路由对照在第9层:可训练router前20步负载CV0.78→2.0,冷专家0.5%→22%;恢复初始router后负载回稳。 §5.4 / 图11 ↗
我的解读支持该运行的路由漂移诊断,不证明所有MoE都应冻结router。
来源证据9B SFT到分域RL:SWE Verified61.1→66.2,Terminal Bench2.1 37.1→52.8;HF当前卡明确公开SFTcheckpoint。 §7 / 表6 / 模型卡 ↗
我的解读每域RL是不同训练分支,不应当作一个9B权重同时达到所有RL分数。
开放情况与使用许可
已打开9B模型卡与文件列表,确认四个safetensors分片及配置,总18.8GB、模型卡MIT;公开的是SFT初始化。论文宣称环境、框架开放,但本次未逐文件核实全部资源,未确认Pro/Flash旗舰权重公开。
LICENSE9B模型卡标MIT,基础Qwen和其他资源条款另核;论文及图6为arXiv非独占托管许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
报告包括路由冻结对照、在线评分消融、跨未见框架结果及训练中断原因,提供比终点榜单更丰富的过程证据。
反方 · 哪些结论还不够
在线评分消融用batch128且token-mean,主运行1568prompt且prompt-mean;两者不能直接推算同配置收益,缺少多次大规模运行方差。
综合判断
有价值的训练工程报告,展示受设计的自我改进环节;不构成自主递归改写训练系统或通用能力无限增长的证据。
我会先做的验证
未执行的验证方案:用固定9B初始权重和等算力预算分别开关GRS/GAR、长度惩罚、框架混合;评分者换模型并人工审计抽样,报告未检出投机和长任务失败率。