大模型全文深读与原图讲解
MoE 解码:不用校准数据,如何只读一部分专家通道
节省专家权重读取,能否转化为端到端速度?
IN A NUTSHELL
这项工作针对冻结 MoE 的解码阶段,用驻留的三值权重草图筛选通道,精确计算 top-k,再以低秩映射补偿未计算部分。重点是实际内存读取量,而不只是把激活置零的比例。
01
图解主要方法
节省专家权重读取,能否转化为端到端速度?
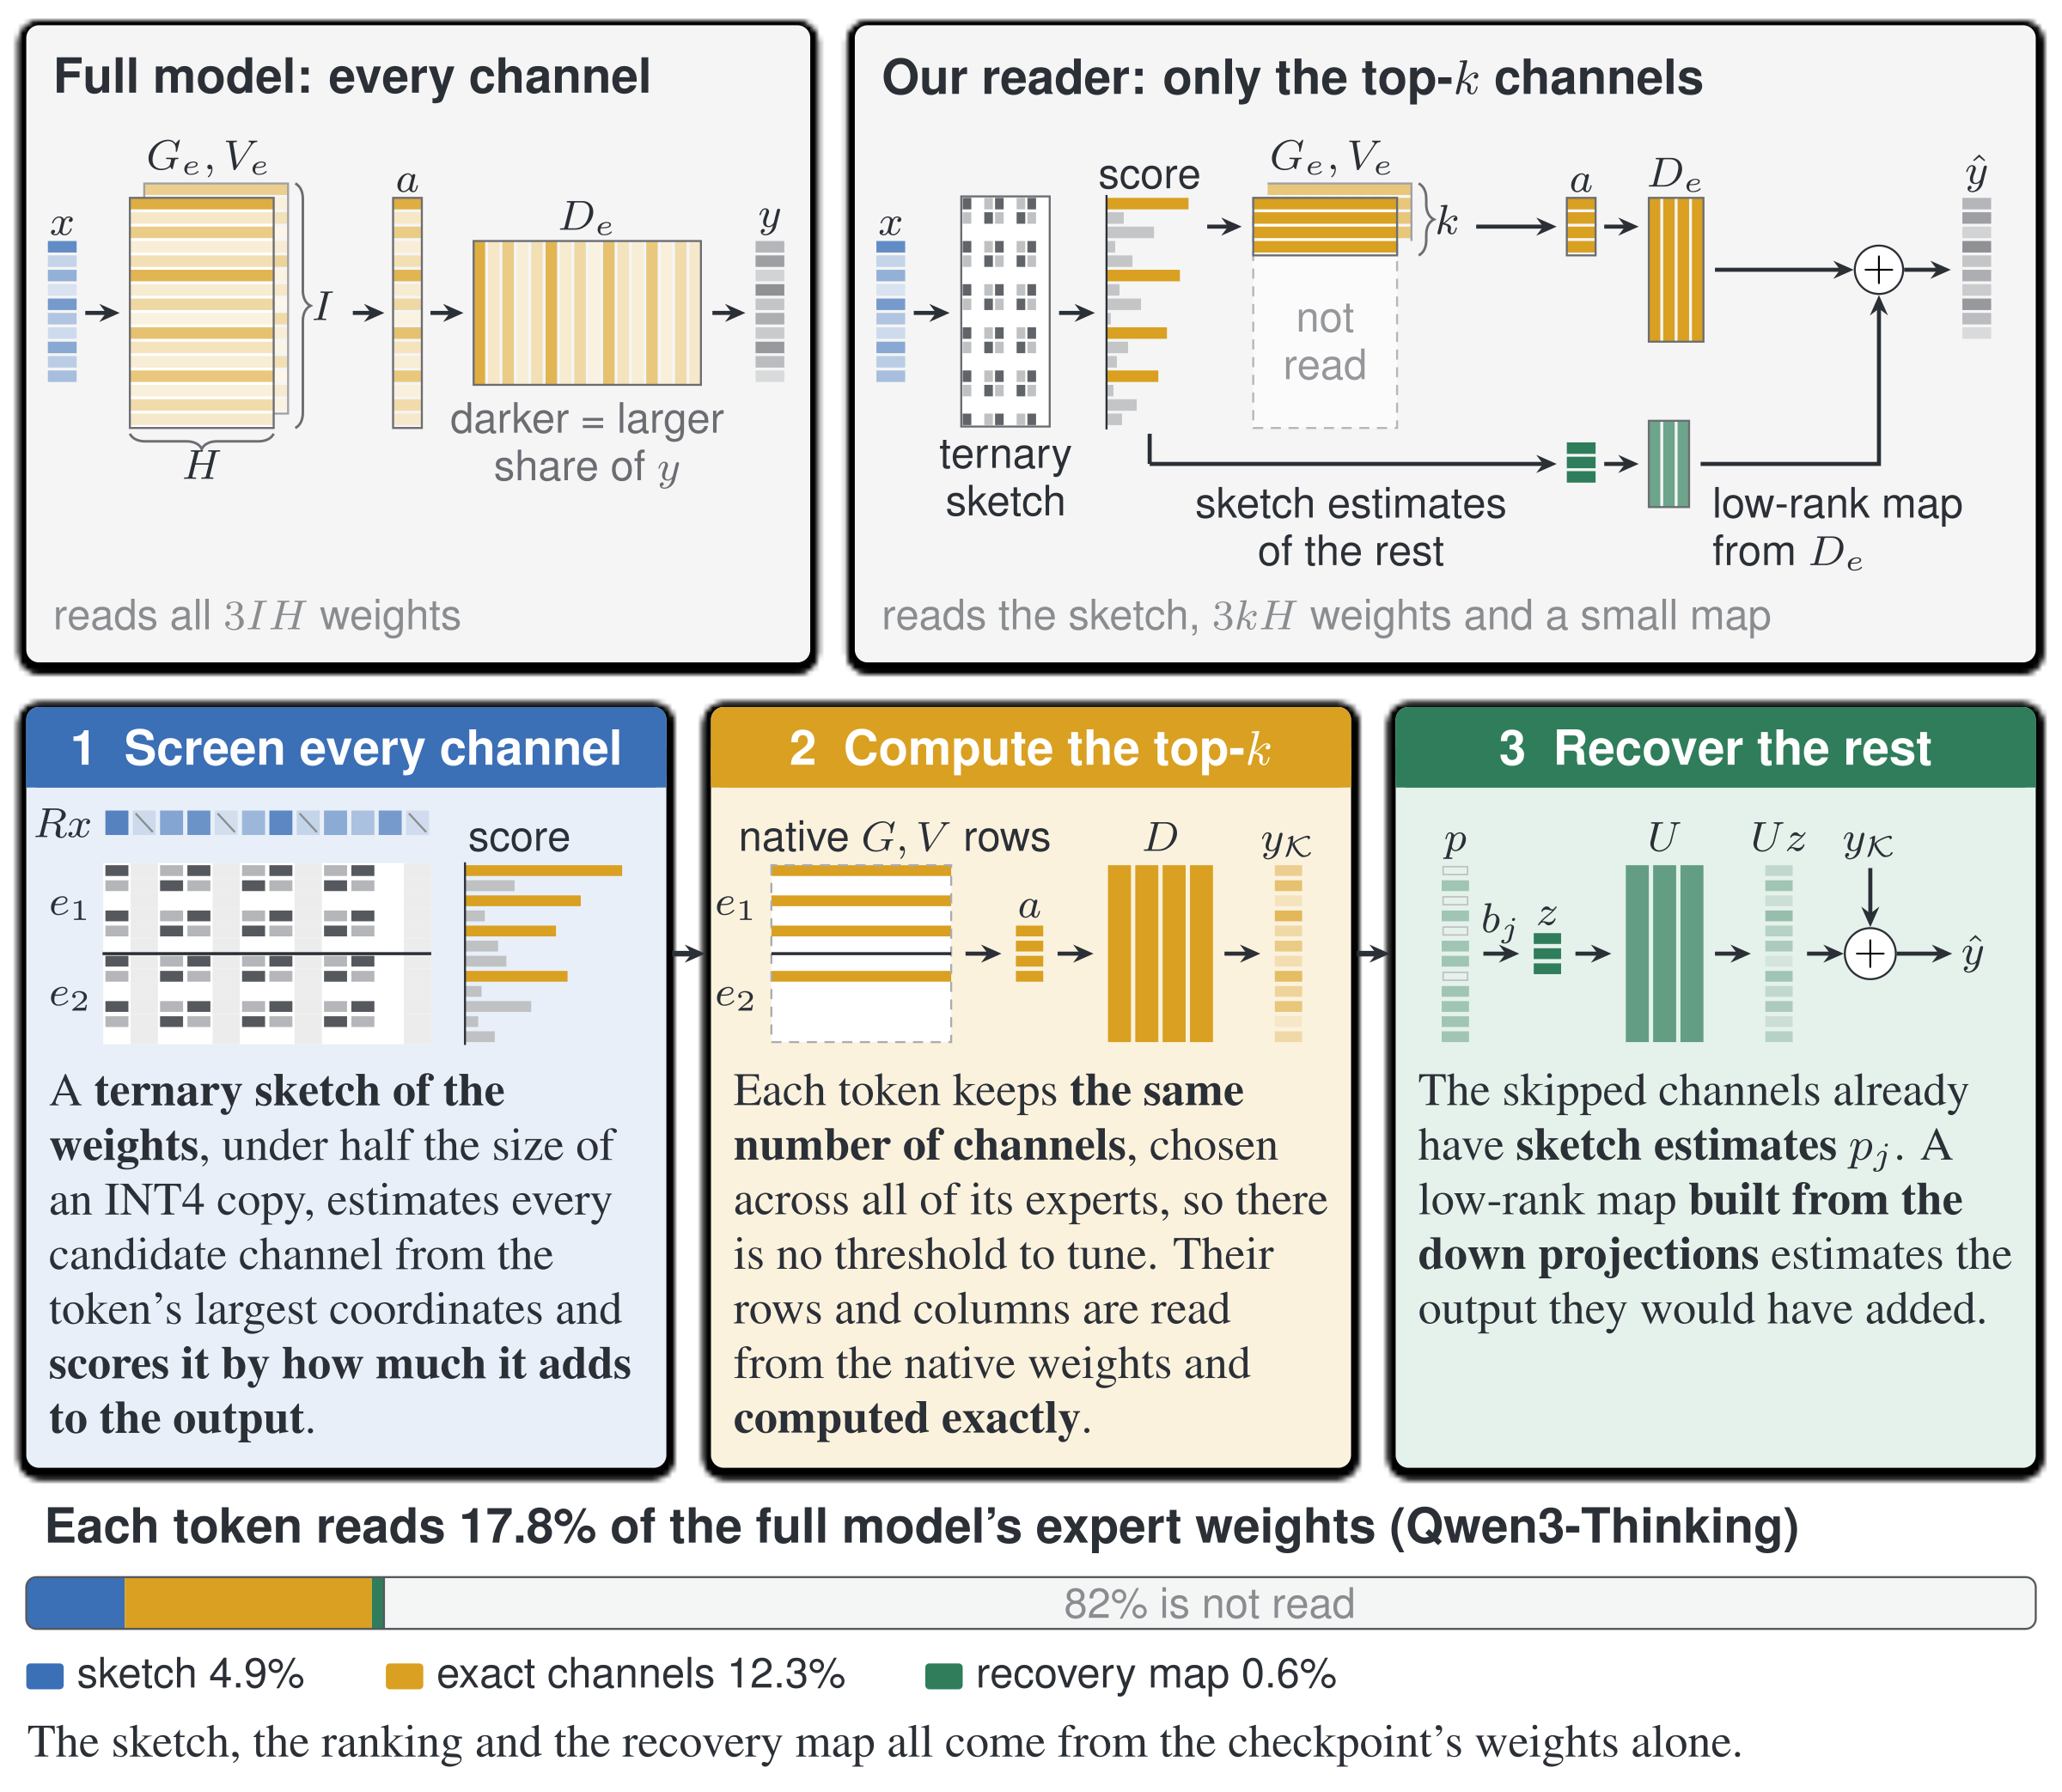
图6 · 草图筛选、精算与补偿查看大图 ↗
KAIST、DeepAuto,arXiv:2610.37386v1。引用方法讲解所需原图;原始插图以 PNG 格式呈现,图中内容未改动。 · 原始来源与图注 ↗ · CC BY 4.0- 1
草图先筛选
图6先用 Hadamard 分块的三值 gate/up 权重草图,结合当前隐藏状态估计通道贡献;评分还包含路由权重和 down 投影范数。草图常驻GPU,不需要校准样本,但本身占显存。
- 2
固定预算读取 top-k
在当前 token 路由到的专家间选择通道,而非用校准阈值决定一个可变数量。选中列从原始 BF16 权重精确读取和计算;完整 prefill、首token、共享专家与稠密模块仍按原路径运行。
- 3
估计被跳过的贡献
用仅从权重得到的 rank-32 SVD 恢复映射补偿其余通道输出。预算核算计入草图、恢复映射和32字节硬件扇区,因而通道比例不等同实际读带宽。
02
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
03
开放情况与使用许可
官方仓库包含 reader/runtime、Triton实现、复现脚本和测试,Apache-2.0;需自备各模型权重并遵守上游条款。本机未运行CUDA复现。
LICENSECC BY 4.0
04
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
工作同时报告实际读量、质量和整模型耗时,较单独激活稀疏率更接近部署问题。
反方 · 哪些结论还不够
硬件验证集中于一代GPU;草图约7%与恢复映射约0.5%额外常驻存储,并非模型压缩。超参数仍经 OLMoE 开发集选择,“无校准数据”不等于无开发数据选择。
综合判断
值得在内存带宽受限的MoE解码上复测,但不能将局部读量减少直接换算为同倍数吞吐。
我会先做的验证
未执行的验证方案:在目标GPU固定上下文、输出长度和并发,比较原生/稀疏实现的端到端延迟、峰值显存、长推理截断率及逐题准确率。