MSAR:让残差连接按上下文尺度检索网络深度
保留完整隐藏向量,用多尺度因果卷积构造不同的深度注意力视角
传统残差把各层结果固定相加,MSAR让每个后续层分别从历史层结果中检索。其关键不是切碎通道形成多个头,而是以邻近词的不同上下文窗口扩展完整向量,避免各流只剩同一向量的倍数。
图解主要方法
保留完整隐藏向量,用多尺度因果卷积构造不同的深度注意力视角
- 1
先生成四种完整上下文视角
保留恒等流,另用核宽4、8、12的因果逐通道卷积扩展每个残差来源,只访问当前位置及过去词。每个流仍是完整d维向量;不同窗口使来源内容不同,不是把同一个向量简单缩放四遍。
- 2
每个流独立沿网络深度检索
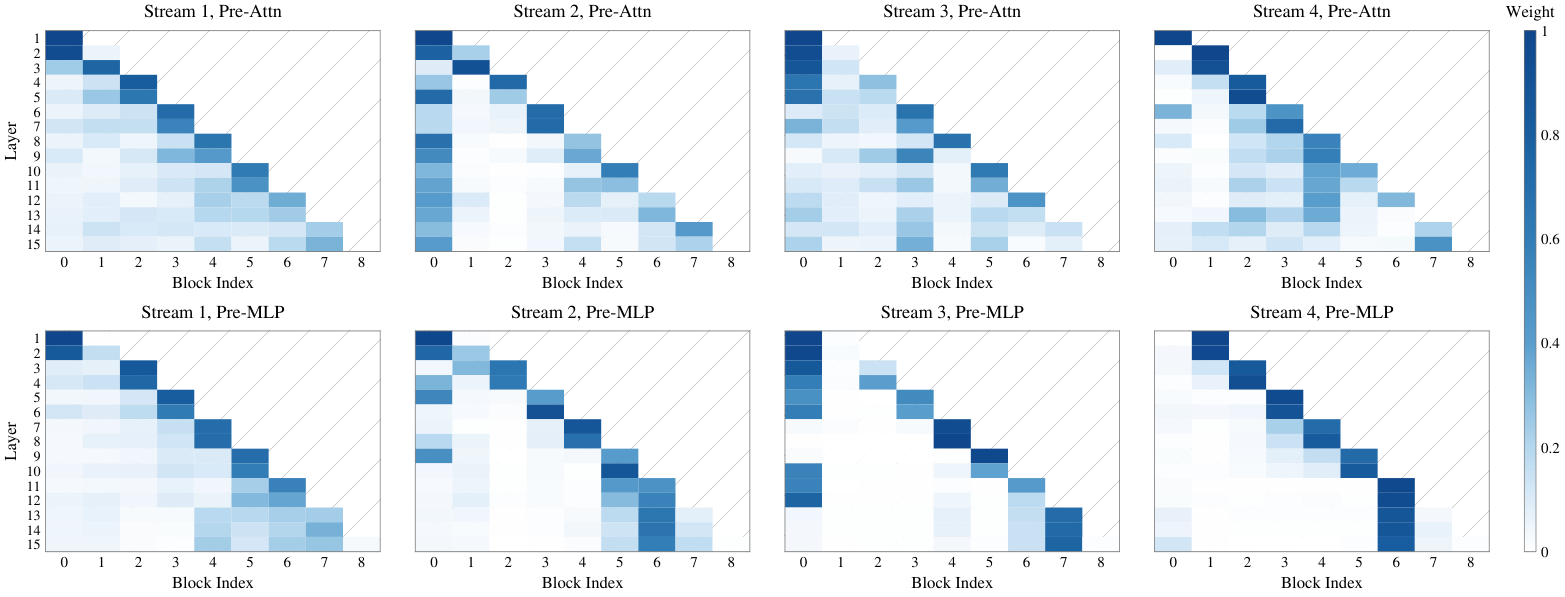
目标层每流拥有可学习伪查询,和经RMSNorm的历史来源计算softmax,归一化方向是深度来源。图4的四列分别展示四流:上排注意力分支读取较分散,下排MLP往往集中于较少块,表明流并未学成相同读取分布。
- 3
轻量门控把检索结果合回单输入
将四个结果展平产生sigmoid标量门,再加权合成下一残差分支输入。门不等于新的通道切片或序列自注意力;去掉自适应门改用平均仍保留大部分收益,内容视角的多样性更关键。
- 4
块内先累加,使用时再扩展
只保存单流块摘要,当前块部分和也作为来源。完整历史块可以先批量计算,当前部分和通过在线softmax合并。卷积与检索融合避免中间四流落显存,但检索结果仍需写回和融合,不能把持久存储相同理解成总访存相同。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据18B/28B MoE总参数、约1.7B/2.7B激活参数,序列8192。12项下游平均18B为45.7对AttnRes41.8,28B为52.4对49.4。主实验块含4个Transformer层,分别7/8块。 表1、附录A ↗
我的解读18B/28B不是每token激活规模;混合任务平均分也不是统一能力量尺。附录训练token预算和部分batch栏为空,复现实验信息不完整。
来源证据10B消融默认Pile loss1.847;去卷积1.862,平均融合1.851;两流1.850、八流1.846。 表2 ↗
我的解读控制了多查询仍保留的去卷积对照支持来源多样性作用,增加流数收益递减。
来源证据四规模拟合固定不可约损失0.72,平均同损失计算量比为1.58×;计算量不含LM head,而主实验开销表含LM head。 §4.3、附录B ↗
我的解读这是拟合计算量节省,不是实测墙钟加速或token吞吐,且依赖拟合下限与预算口径。
来源证据28B激活参数增加0.27%,训练FLOPs增加0.48%;典型N=8、S=16、m=4时残差访存MSAR21.5d、AttnRes5.5d、普通残差3d。 附录C、表5–6 ↗
我的解读FLOPs增幅小不意味着实际内核开销小;典型访存表的64层配置也不是主实验32层配置。
开放情况与使用许可
官方GitHub当前仅见assets、paper、README、CITATION等报告文件,未见训练或推理实现;公开仓库不能据此算代码开源。
LICENSE论文 CC BY 4.0;实现尚未核实公开
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将来源视角差异和检索查询差异分开,消融支持因果卷积带来的收益;在两种MoE规模与多项任务上表现一致。
反方 · 哪些结论还不够
未给出完整训练token预算、墙钟吞吐和多随机种子误差,单流存储优势不能掩盖更高残差访存;对训练数据或更大规模的迁移仍待验证。
综合判断
是值得复现的残差设计,而不是已经证明能让所有大模型实测提速1.58倍。优先验证融合内核和实际硬件收益。
我会先做的验证
未执行的验证方案:补齐token预算并在相同数据顺序、token数、硬件和并行策略下多种子比较;同时报告损失、总训练小时、预填充与解码吞吐、显存峰值,区分理论计算量与实测。