Soft-MTP:修正多 token 预测里的高方差梯度
如何保留交叉熵的高效实现,让预测头学习位置对齐的主模型分布?
把多token交叉熵梯度拆成对齐主模型的信号和抽样残差,通过直通梯度耦合移除后者。31.5B token控制实验中改善困惑度与部分下游能力,训练吞吐近乎不变;推测解码增益远小于“翻倍”。
图解主要方法
如何保留交叉熵的高效实现,让预测头学习位置对齐的主模型分布?
- 1
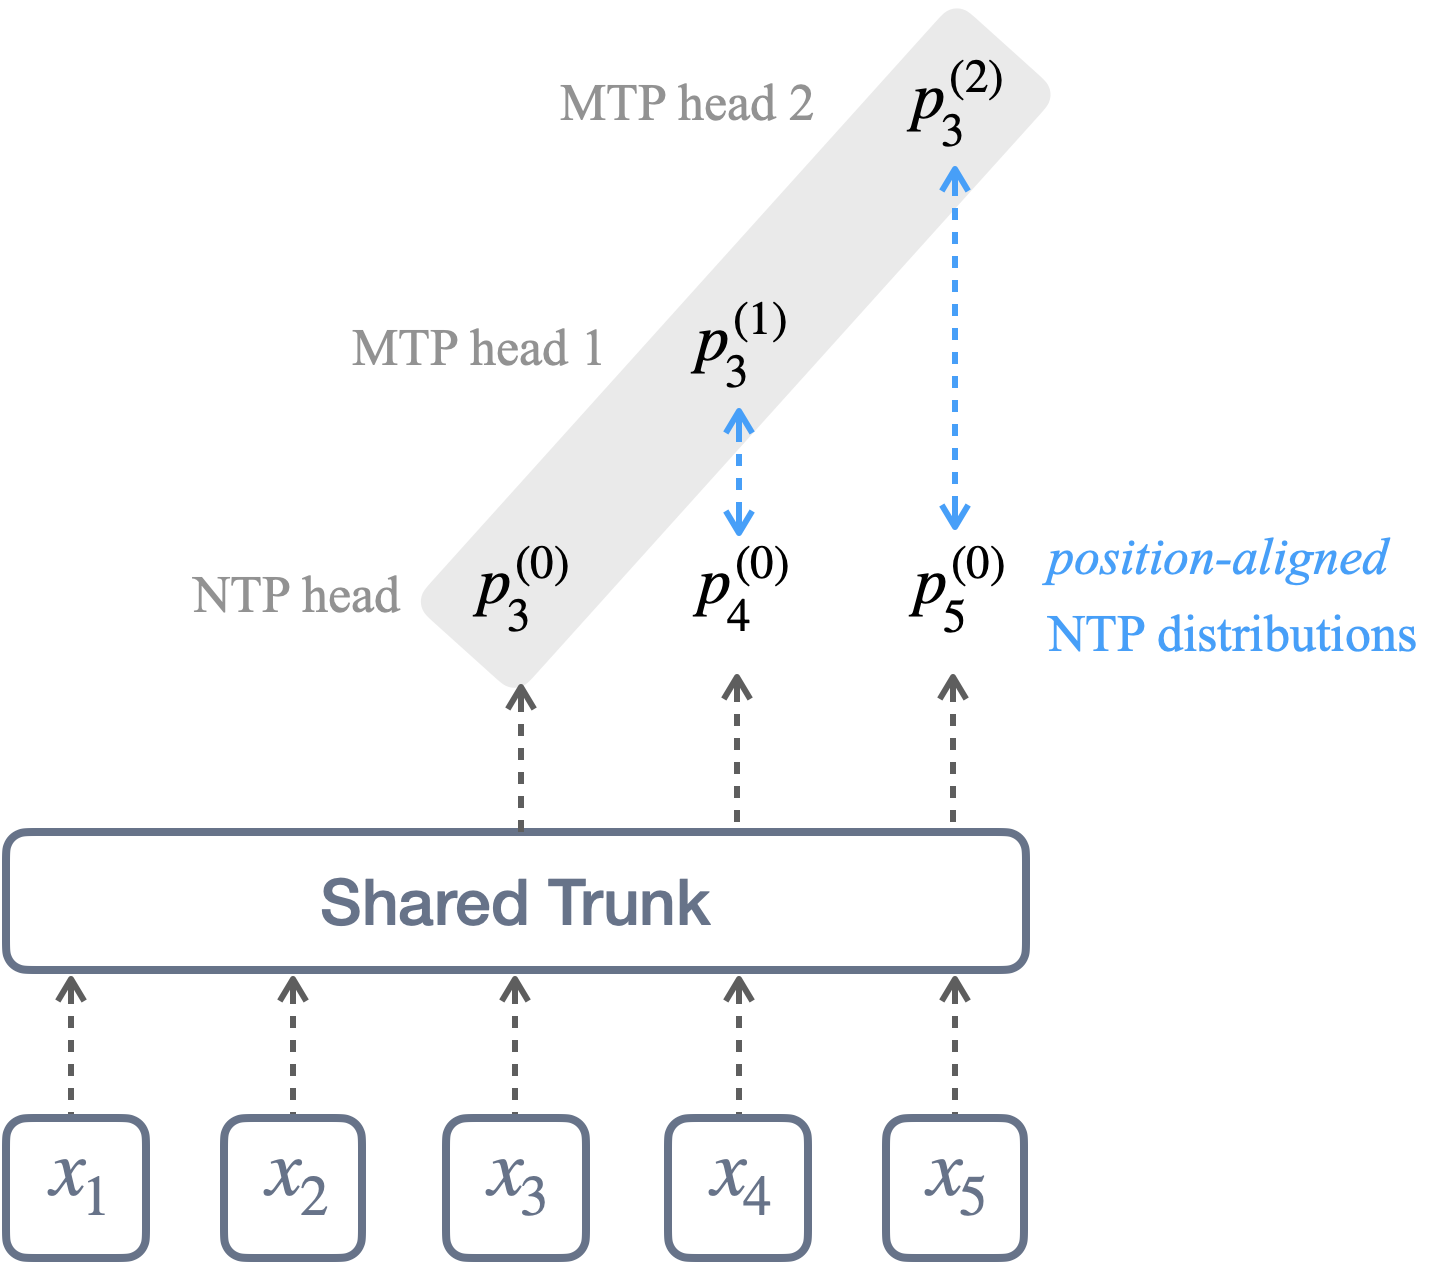
图2:先把不同头的位置对齐
第k个MTP头预测未来位置,教师q必须来自同一目标位置的NTP分布,不能直接拿当前位置分布当教师。共享输出矩阵W时,交叉熵对隐藏态的梯度可分为Wᵀ(p−q)与Wᵀ(q−y),前者衡量头与验证器的一致性,后者含实际采样token的残差。
- 2
用零前向值改变反向传播
把sg(hk)−hk这样的直通项注入位置对齐的NTP隐藏态:前向数值为零,反向把所需修正传回MTP。按有效token数量和头数缩放,避免因序列边界造成权重失衡;因此可以复用融合交叉熵,不额外生成昂贵的全词表KL路径。
- 3
明确修正作用在哪里
移除残差的是MTP隐藏态及共享主干路径;输出矩阵仍受交叉熵更新,原有NTP训练路径也保留。因此它不是把整个模型优化严格替换成KL。论文用梯度信噪比诊断说明残差很大,但不能把这一代理统计当作所有优化器下的因果定理。
- 4
训练头与部署用途分开
四种规模167M至1.2B采用三个DeepSeek式串联预测头,共享31.5B FineWeb-Edu token、60000步和2048上下文。下游数学/代码微调丢弃MTP头;自推测解码则保留它们作草稿头,由NTP验证。二者的收益应分别测量。
实验与证据
已阅读全文正文及附录A梯度代码、D训练设置,核对实验条件与原图;未独立复现。
来源证据1.2B模型困惑度10.891→10.741,零样本平均56.80→57.31;同规模NTP为56.75。数学微调GSM48.60→49.66,HumanEval pass@64 40.85→43.90。 正文预训练与下游表 ↗
我的解读我的解读:增益真实但幅度有限,小规模并非总胜NTP。代码评测还选了10种温度中的最佳值,不能当固定温度部署保证。
来源证据H200融合CE条件下显存均107GB,训练吞吐49783→49748 token/s;显式KL为128.1GB、46990。五类提示的推测解码相对MTP改善约1.4–1.5%,1.2B相对普通AR速度由1.74×到1.76×。 吞吐与推测解码实验 ↗
我的解读我的解读:主要优点是低额外成本,而非相对原MTP再快1.76倍。每格单种子,尚缺超大规模和多种子稳定性证据。
开放情况与使用许可
代码仓库有src、配置与测试,MIT;Hugging Face的soft-mtp-689m-model已列出model.safetensors及模型实现,模型卡MIT。核实文件清单与卡片,不曾下载或执行权重;需要自定义模型代码,卡片的分词器说明与文件清单存在差别,应实际加载验证。
LICENSE论文及原图 CC BY 4.0;代码与权重许可另列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把统计残差与预测目标错位具体分离,并给出融合CE兼容的实现,具有比单纯更换损失更强的工程可操作性。
反方 · 哪些结论还不够
研究规模止于1.2B、31.5B token,单种子控制并不覆盖训练方差;需要共享输出头,序列并行还涉及边界token通信。模型卡某些字段与实际文件有差异,不能据卡片宣称全部运行路径已验收。
综合判断
适合已有MTP训练栈进行低成本对照;目前证据不足以承诺前沿模型同比收益,也没有独立运行复现。
我会先做的验证
未执行的验证方案:在同数据顺序下做NTP、MTP、Soft-MTP与显式KL四组,各三种种子;同时记录输出头梯度、主干梯度、困惑度和固定批量下端到端解码时延,防止只优化代理指标。