MPO:把智能体的整轮动作与逐 token 信用分配对齐
为什么同一轮共享更新尺度,仍要保留 token 之间的差别?
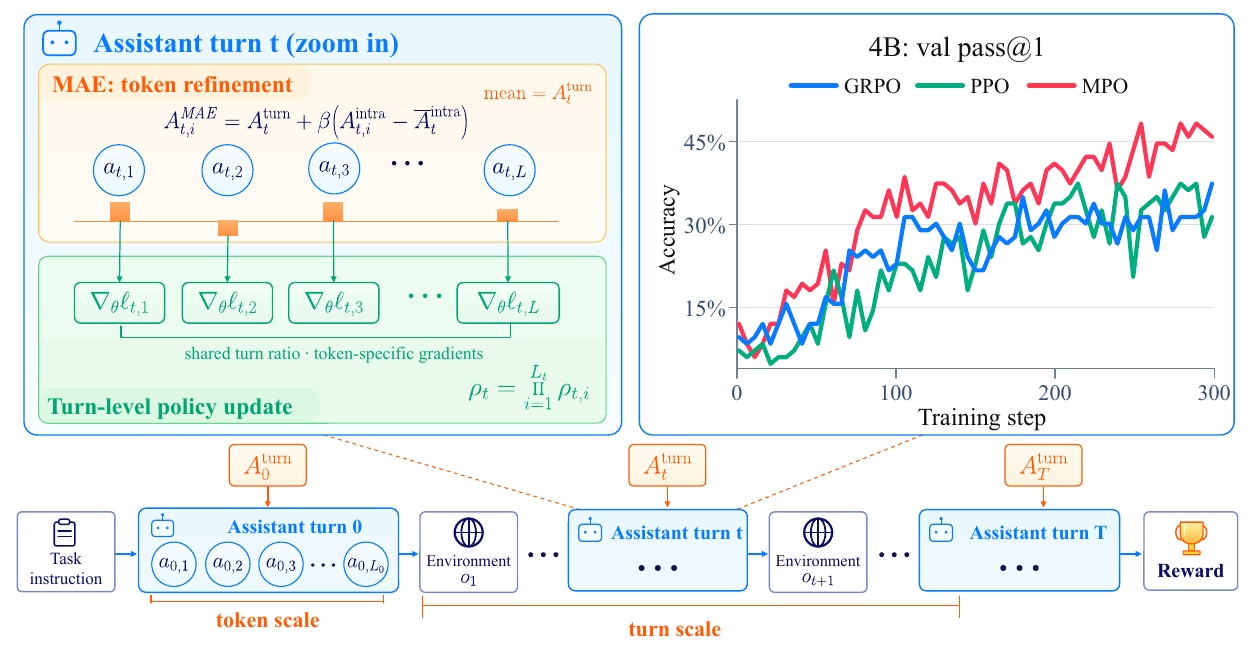
长任务的奖励通常要到末尾才出现。MPO 先在助手轮次上估计优势,再将轮内的细粒度差异加入;更新时使用整轮概率比,但保留各 token 的独立梯度。它针对长链工具调用的训练单位错位,而不是给每个 token 复制同一个奖励。
图解主要方法
为什么同一轮共享更新尺度,仍要保留 token 之间的差别?
- 1
先计算整轮价值
图1下方把一次完整助手输出视为宏动作,环境返回不参与策略损失。轮边界的价值通过 GAE(λ=0.8、γ=1)连接最终奖励;critic 使用终局蒙特卡洛目标。
- 2
保留局部信用而不改变轮均值
轮内 TD trace 使用 λ=0.95。MAE 将局部优势减去本轮均值,再以 β=1 加回整轮优势;归一化前,本轮 token 优势的均值仍是整轮优势。这样既有长期方向,也能区别具体 token。
- 3
同一概率比,不同梯度
整轮重要性比为 token 比率之积。计算某一 token 梯度时,其他 token 的比率停止梯度,随后进行裁剪。若直接让完整乘积对所有 token 一起反传,居中的局部项可能抵消,不能把实现简化为普通序列 PPO。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-4B 与 30B-A3B 分别训练搜索、Claw 和自动化;每个设置一次训练,选最佳检查点后做5次离线评测。4B BrowseComp-Plus pass@1 为48.08,SAO为43.75;GAIA为39.47对35.62。 表1与实验设置 ↗
我的解读重复评测不是五个独立训练种子;检查点选择与私有训练集限制结论外推。
来源证据相同 MAE 下,4B token级比率的 BrowseComp/GAIA/HLE 为45.72/36.35/8.89,整轮比率为48.08/39.47/9.92。2048条轨迹的轮间价值方差中位占比89.5%。 附录消融与 critic 分析 ↗
我的解读这支持轮尺度更新;但只有9.2%的相邻价值变化发生在轮边界,不能推出轮内信息不重要。
开放情况与使用许可
已核对预印本正文、实现和实验附录;未核实到与本论文对应的完整代码、权重或训练集发布,不以文中引用的其他项目代替。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定优势估计后替换更新尺度仍有增益,支持把交互单位纳入策略优化设计。
反方 · 哪些结论还不够
每设置单训练运行;Claw/自动化训练数据未公开,理论界依赖精确优势与信任域等条件,不能当作实际裁剪训练单调改善保证。30B HLE 相对强基线增益很小。
综合判断
适合优先研究长链工具调用的训练稳定性;尚不能声称普遍优于所有 token 级强化学习。
我会先做的验证
未执行的验证方案:固定数据、总生成token、检查点规则和训练种子,比较 MAE/普通GAE 与轮级/token级比率的2×2组合,并记录长回复截断和工具错误。