RAW-RAG:先保留原始证据,再讨论复杂记忆
智能体记忆的增益,究竟来自结构设计还是召回与阅读能力?
RAW-RAG 不先用大模型压缩和改写长期历史,而是对原文分块、密集召回、交叉编码重排,再让阅读模型处理时间与状态变化。它在主文七组比较中六组领先记忆系统,却在人格偏好与部分MEME设置落后;结论应是建立强检索基线,而非否定所有结构化记忆。
图解主要方法
智能体记忆的增益,究竟来自结构设计还是召回与阅读能力?
- 1
第一步:保留历史中的关系与时间
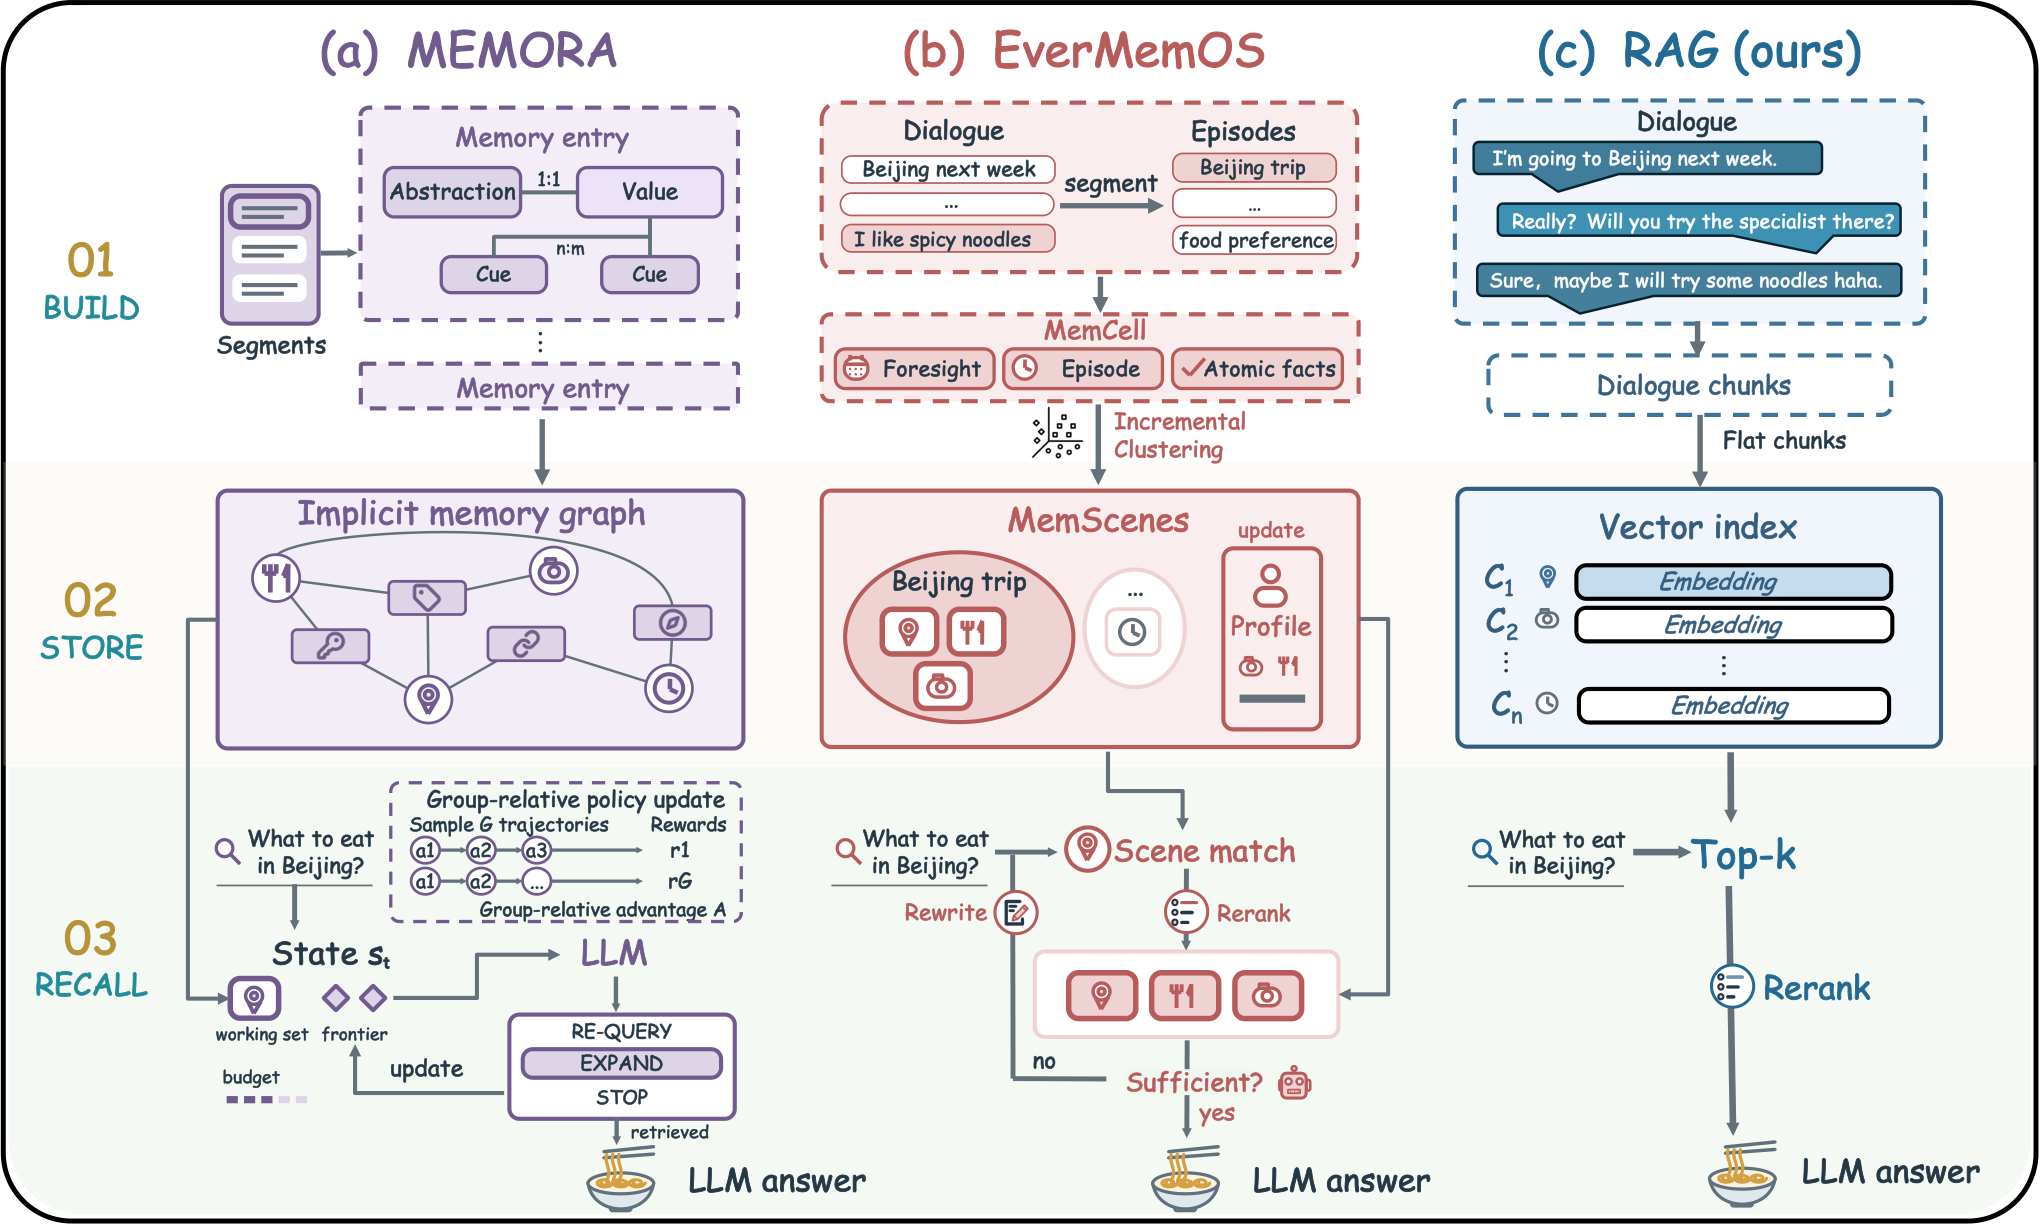
图3右栏保留发言者、时间和可用图像描述,把原始历史切成256 token窗口、重叠32 token后建立向量索引。与左侧先抽取事实、合并记忆或形成情节结构的系统相比,这避免在写入时不可逆地丢失依赖关系;代价是库更冗余、需要更强的查询阶段。
- 2
第二步:召回128段,再重排到15段
问题嵌入检索余弦相似度最高的128个窗口,交叉编码器筛到15条证据。默认设置使用Embedding-3-small和Cohere Rerank 3.5,匹配对照也使用Qwen3的嵌入与重排模型。最终可扩展到完整发言轮次,因此15乘256不是实际上下文上限;重复内容与时间排序也会影响预算。
- 3
第三步:让阅读模型解决状态变化
将证据交给固定阅读器回答问题,而不是默认以记忆库中最后一次UPDATE为真。不同基准仍有专门处理:MEME按时间组织,MemoryAgentBench不扩展对话轮次、保留完整原子事实。这是固定检索流程的诊断研究,不是无需任何数据适配的通用记忆算法。
- 4
第四步:用消融和oracle拆开证据覆盖与利用
作者检查去掉重排、改变证据数量、限制token预算、禁用特定记忆修改,以及让oracle访问完整原文或变换后的记忆库。oracle带有更强选择信息和不同打包策略,不可部署;各系统证据覆盖后的利用率还条件化在不同题集上,不能直接当作阅读器因果能力比较。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据LongMemEval为87.53,对照Memora87.40,仅高0.13个百分点;MEME使用DeepSeek阅读器时为43.19,低于MemMachine44.71和全文上下文63.17。附录人格偏好任务RAW-RAG49.62,落后EverMemOS53.25与MemOS50.72。 主文结果与附录PersonaMem-v2 ↗
我的解读六胜七组不含全文上下文基线,也不能推广为所有记忆任务领先。小幅差异需考虑运行方差;部分主表混用已发表结果,匹配设置见附录,不能省略这一限制。
来源证据2071题、14个来源按四类能力宏平均,RAW-RAG48.32;移除重排降至44.40,Holm校正p=.0012。默认完整轮次扩展使LongMemEval平均约11355 token、MEME约11986 token;另有5000 token预算复测。 MemoryAgentBench消融与预算附录 ↗
我的解读重排质量比“有没有智能体式记忆”这一名称更能解释部分收益。5000 token复测没有把所有外部系统重调到最优;bootstrap置信区间也不是不同模型运行的方差。
来源证据Mem0 v1.0.11中有效修改占1.90%;禁用UPDATE/DELETE的指定实验从67.36到69.42。MEME的10个episode、110题计时,RAW-RAG写入加检索305.91秒,EMem1561.97秒;不含回答与裁判。 记忆修改审计与效率实验 ↗
我的解读不能由此建议停用隐私删除或永不更新事实。RAW-RAG检索本身255.59秒,比Mem0的117.72秒更慢;优势主要在写入阶段,API与网络条件影响绝对时间。BEAM-1M只测写入扩展,未证明百万token回答准确率。
开放情况与使用许可
2026-10-25已打开作者关联的Litmeb/RAW-RAG仓库,核实methods与scripts实现目录、实验说明和MIT LICENSE。代码可用;依赖的嵌入、重排、阅读API和外部数据并不因仓库MIT许可而自动开放。论文及原图CC BY 4.0,未独立运行其基准。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:保留原始信息并做强召回,是评估记忆系统时不可省略的基线。它可暴露写入压缩是否损失时间、主体关系或推导所需路径,尤其适合事实追溯。
反方 · 哪些结论还不够
查询时花更多上下文和阅读能力,可能弥补写入简单化;这并不免费。偏好抽象、MEME反例、预算不完全匹配,以及oracle的额外信息,限制了“复杂记忆没有必要”的结论。
综合判断
先把RAW-RAG作为可解释参照,再只为确有收益的任务增加压缩、结构与主动维护。保留原始证据的研究价值不应被误读为无条件永久保存用户历史。
我会先做的验证
未执行的验证方案:在同一阅读模型、同一5000/12000 token预算与相同数据可见时间下,比较原文RAG、摘要记忆和二者混合;报告事实追溯、偏好泛化、状态更新、删除后不可检索性、写入与查询成本,三个种子重复运行。