Novelty Patching:把字节级计算用在新内容开始处
高熵字节未必需要推理;重复结构能否告诉模型在哪里启动全局计算?
针对字节模型在紧张 patch 预算下跳过计算结果的问题,用前两个字节查表预测后续内容的新颖程度,在预计不再重复近期上下文的位置启动全局模型。小规模数学续写实验有明显收益,代码域与完整解题尚不能据此推广。
图解主要方法
高熵字节未必需要推理;重复结构能否告诉模型在哪里启动全局计算?
- 1
从重复长度构造离线目标
第3节先在文本位置寻找与过去128字节匹配的最长后续片段,长度上限16;取负匹配长度作为 novelty。这个目标需要未来文本,因此只用于训练表格,不能直接用于在线分段。用4MB训练文本按前两个字节聚合均值,出现不足20次时退回单字节、再退回全局均值。
- 2
在线查表决定全局计算位置
部署时只读已经出现的两个字节,将预测新颖度与训练集校准的阈值比较;超过阈值才开始新patch。BLT式模型在patch层运行全局Transformer,局部解码器仍处理字节。nov用数学解答拟表,novc直接用原始预训练语料,后者检验规则是否依赖人工挑选解答。
- 3
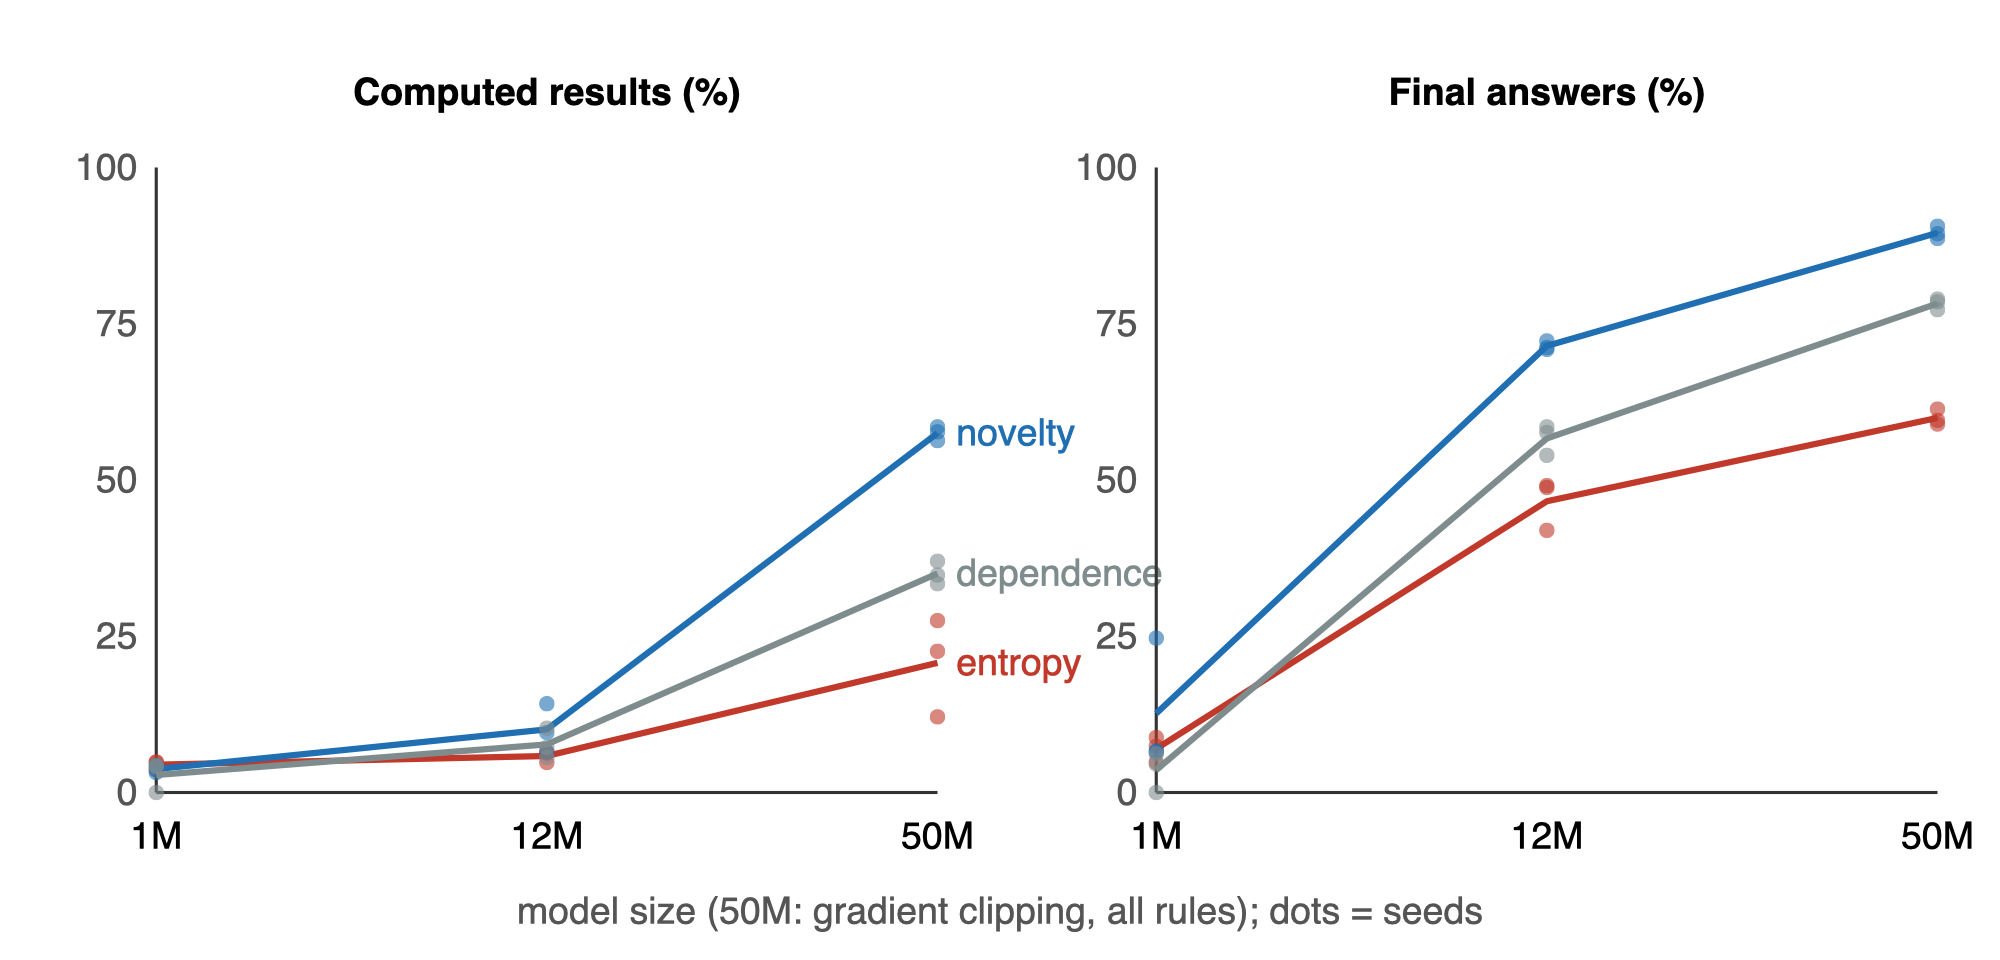
按实际评测patch率对照图1
图1横轴是1M、12M、50M模型,左图为行内计算结果、右图为最终答案片段;点为3个种子,线为均值。评测patch率约11%,但并非完全一致:熵11.2%、nov11.9%、novc11.4%。所有50M训练均裁剪梯度;这些是从头训练结果,不是替换大模型tokenizer即可获得的收益。
- 4
用负结果检验适用范围
第6–7节表明新颖度只是某些文本中计算段落起点的廉价代理。执行轨迹里,128字节预测器更准确地定位计算值却让答案变差;训练后更换分段规则也可能使小模型最终答案降至零。因此目标不是单纯标记答案,而是让训练和推理的全局状态更新位置一致。
实验与证据
已阅读正文第1–9节、全部5张实验表及负结果;本版本无单独附录,核对实验条件与原图;未独立复现。
来源证据1.9GB数学语料,GSM8K/MATH训练解答重复至10%字节并过滤评测重叠;3种规模各3种子。给定正确前缀,贪心续写1000个行内结果和660个答案片段。50M nov计算结果57.5±1.1%,熵20.7±7.9%;最终片段89.5±1.0%对59.9±1.3%。 表1、3节:数学评测条件 ↗
我的解读我的解读:这是条件续写的结构性改善,不能称完整数学题解答率90%;论文承认这些规模端到端生成接近地板。
来源证据50M nov bits/byte为1.446,劣于熵1.416;novc结果57.3%/86.4%。12M代码域实际patch率7.7%/7.6%时nov的1.684也劣于熵1.649;域外仅2种子。 表1–4:收益与代价 ↗
我的解读我的解读:总压缩损失、目标位置准确率和计算预算必须并列,不能以数学单项提升证明通用语言建模改进。
来源证据熵边界富集度1.61但只覆盖1%计算结果起点;nov覆盖100%。BLT-1B仅推理换nov时计算结果19.0→56.5%,最终答案51.4→19.4%。 表4–5:机制和失败 ↗
我的解读我的解读:边界与任务结构相关,但并非简单因果保证;规模扩大实验还只是设计,未执行。
开放情况与使用许可
2026-10-19核对作者segresearch仓库:paper2、scale、运行记录及训练脚本可见,根MIT许可;论文CC BY 4.0。未运行训练,也未确认本文全部训练权重可下载;README部分概览属于前篇,本文数字以2610.22100v1为准。
LICENSE论文及原图 CC BY 4.0;仓库代码 MIT
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:分段策略可以非常便宜,却改变全局计算分配。提供跨域和失败对照,使它适合作为字节架构的可控研究变量。
反方 · 哪些结论还不够
仅一个BLT式架构、128字节上下文,训练规模最高50M;目标位置依赖固定数学格式,patch率略有差异。更大patcher可能改变结论,代码和轨迹未体现稳定收益。
综合判断
优先复现预算匹配的数学片段实验,再考察完整生成;不建议直接把现成模型分段器替换成该表。
我会先做的验证
未执行的验证方案:固定训练字节、模型规模及实测patch率,比较熵、随机、语法与novc;增加无####标记、不同等式格式及完整题目生成,报告每种子的EM、bits/byte、延迟和边界覆盖率。