Omni-Woodpecker:在隐藏状态里纠正视听证据冲突
不训练新参数,怎样让模型少把“看起来如此”当成“听起来如此”?
OWP以全模态、仅音频、仅视频与文本四路探测定位冲突,再在冻结模型内部保护目标证据、抑制竞争先验。Qwen2.5-Omni-7B的跨模态幻觉指标改善明显,但干预有感知损失和额外延迟,需要把“抗幻觉”与正常问题准确率一起衡量。
图解主要方法
不训练新参数,怎样让模型少把“看起来如此”当成“听起来如此”?
- 1
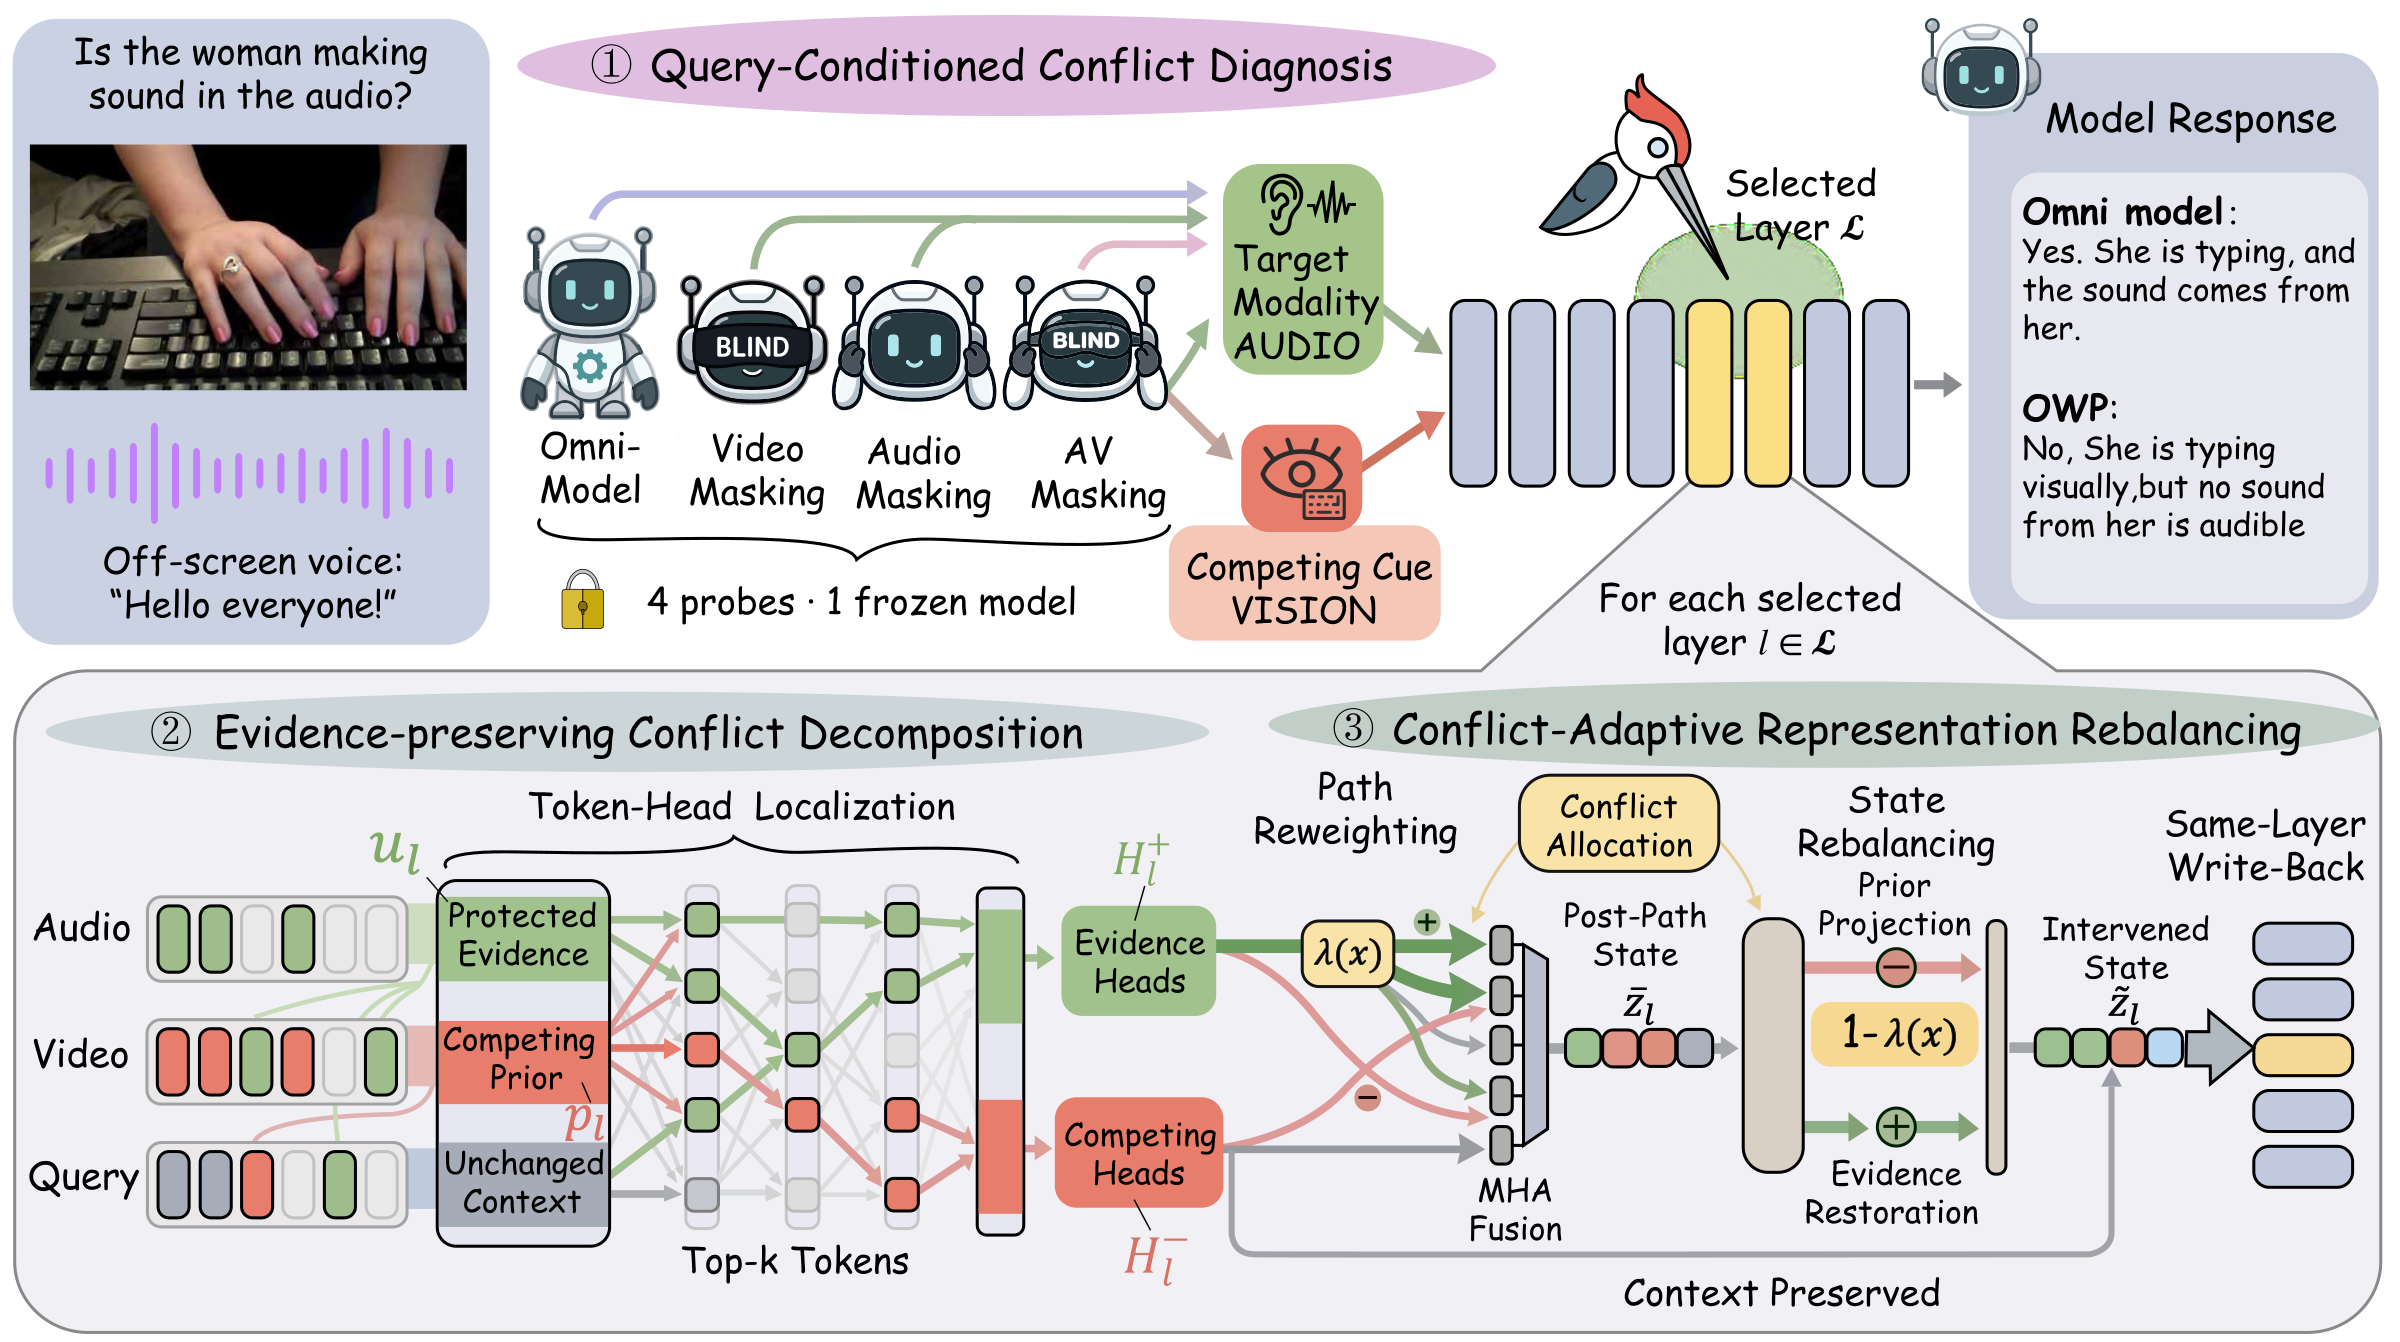
1 · 图2先判断问题需要哪一路证据
同一问题经过四种模态视图,结合问题类别及回答一致性,定位应依赖的音频或视频证据,以及与其竞争的线索。例如视频中敲键盘并不证明声音也是打字声。四路探测不等于四个独立事实裁判。
- 2
2 · 把证据方向与先验方向拆开
在选定层和token处,以文本条件为参照构造模态方向;正交分解尽量保护目标证据,只从竞争方向中取出不应影响答案的分量。它能重分配已经编码的证据,不能凭空恢复编码器没看到或没听到的信息。
- 3
3 · 冲突越强才分配越多编辑预算
先重加权相关注意力头路径,再在同层残差状态中抑制先验、补回被忽略证据,保持其他上下文。模型权重和正常解码器不变;总流程至多五次前向,必须能访问内部层,普通黑盒API无法直接套用。
- 4
4 · 用原生任务与共同探针分别验收
原生输出格式检验实际任务效果,跨架构共同二元探针另做比较。两种有效样本和输出定义不一样,不应把结果混为同一个统一排行榜。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据CMM总体73.2→86.1,抗幻觉57.0→85.5;但感知准确率89.5→86.7。AVHBench75.1→83.7。 表1:Qwen2.5-Omni-7B ↗
我的解读改善并非全维度无损,正常感知下降2.8分应与抗幻觉增益并列。
来源证据CMM 1200题、AVHBench 5302题;视频2fps最多32帧。RTX A6000上3.54秒→6.05秒,约1.71倍延迟。 实验设置与效率 ↗
我的解读“无需训练”不等于推理零成本,帧采样也限制细粒度时序证据。
来源证据另测VideoLLaMA2-AV,共同二元探针有效配对4604题;原生可干预样本中25.8%编辑、16.9%改变回答。 跨架构与协议 ↗
我的解读结果支持跨骨干的可行性,仍不能推断开放式长回答中的幻觉率。
开放情况与使用许可
已查看官方仓库的owp/src/models/tests等实现目录与MIT LICENSE。依赖骨干权重各有许可;本文原图引用按作者版权和arXiv非独占托管信息标注,不误写为CC BY。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
干预位置和冲突来源可解释,且以冻结骨干对比减少重新训练带来的混杂。
反方 · 哪些结论还不够
方法依赖模态探针可靠性与隐藏状态可访问性;闭集问答收益尚不足以证明真实长视频、噪声音频和自由生成场景同样稳定。
综合判断
适合作为可控骨干的推理期校正实验,应用时需给正常感知、延迟和误干预设明确预算。
我会先做的验证
未执行的验证方案:构造音画一致、音画冲突、目标音缺失三个分层集,在同一采样率下测原模型与OWP的正常准确率、拒答率、延迟及逐题改错/改坏比例。