OmniFysics-Nano-V2:物理理解需要怎样的多模态监督
静态属性先验、声画事件对齐与两阶段奖励
这个 4B 全模态模型把物体属性与声画事件整理成训练监督,再筛出奖励存在差异的问题做两阶段优化。它输出文字与语音,也能给仿真提供物性先验;从图片估计质量或摩擦系数仍不是物理测量。
图解主要方法
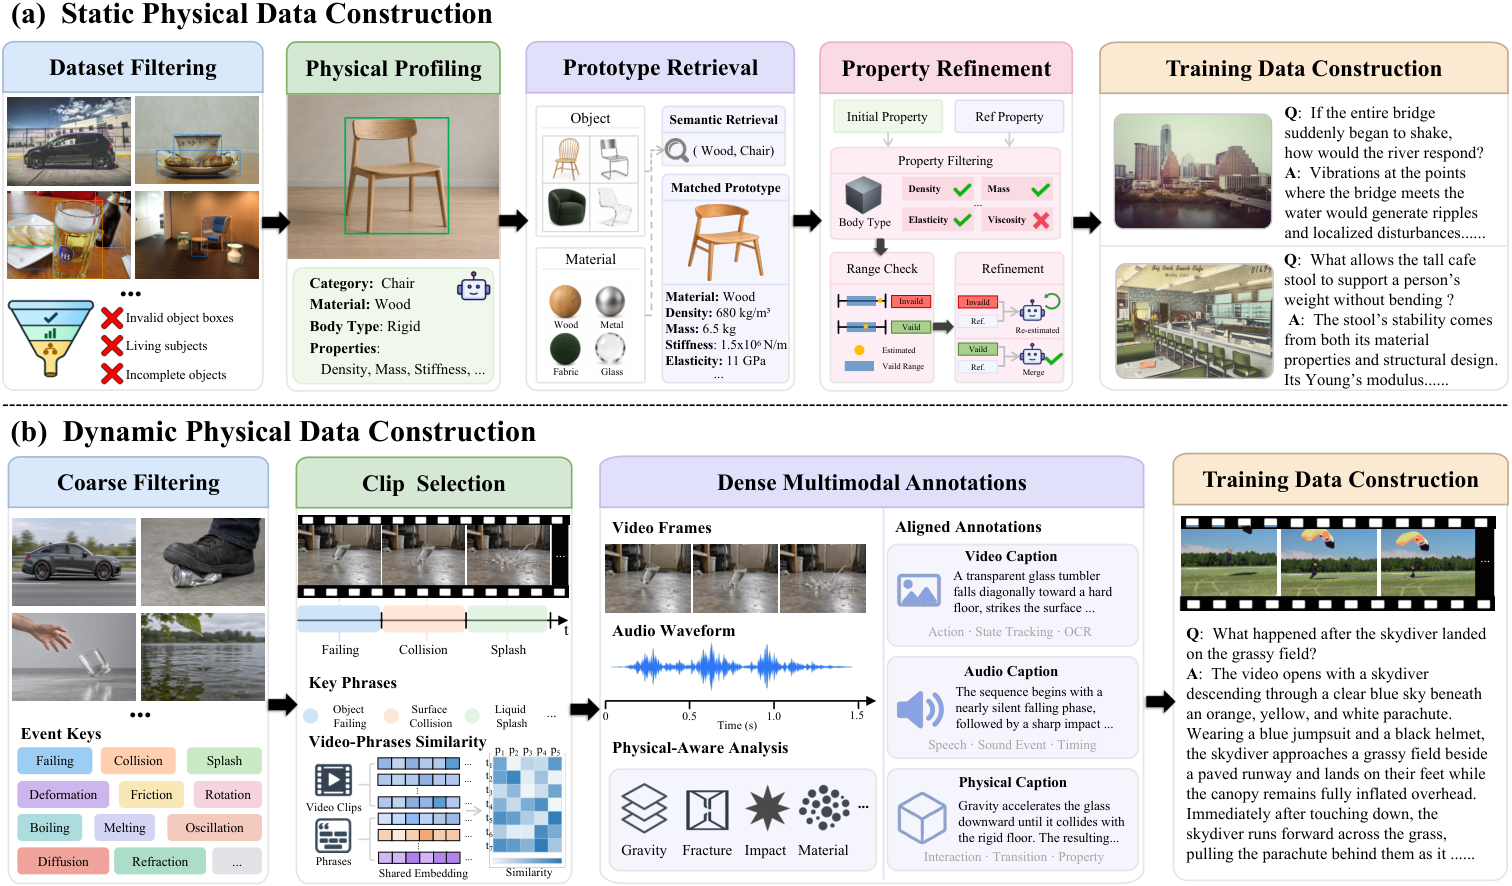
图 4 如何把语义描述转成可核查的物理属性和事件证据?
- 1
静态分支:估计后用原型约束
商业多模态教师从图像和框估计类别、材质、刚柔体类型及物性。1209 个物体—材质原型通过关键词 Jaccard 相似度检索,提供手册或产品规格区间。超范围只重估一次,仍失败则丢弃样本;落入区间不能证明真实个体参数正确。
- 2
动态分支:保留声画证据链
六大类、26 小类事件先用元数据筛选,再用 Qwen3-VL-Embedding 对重叠片段与短语检索,合并邻接事件。教师分别写视觉、音频和物理解释,仅在事件相关时间容差内关联声画起点,避免把所有信息压成泛化标题。
- 3
对齐输入和语音输出
Qwen3.5-4B 骨干结合 Whisper Medium 音频编码与 CosyVoice3 输出模块。同步声画以时间组交织;回答隐藏状态投影后,让语音侧重新分词的文字跨注意力读取。两种分词长度不必一致,语音对齐阶段冻结主推理模型。
- 4
筛出具有组内学习信号的问题
每题固定策略采样四个回答,只保留至少两种奖励值的组。先按答案正确性进行多模态 RL,再加入物性、材质和格式奖励。本文公式用整条回答概率比;过滤是依赖当时策略的离线选择,后续变得可学的困难题可能已被删掉。
- 5
把仿真应用与离线答题分开
模型估计物性,物理引擎比较模拟轨迹、末端位置和速度并校准参数;策略在模拟中学习。该模型不直接输出机器人动作,文中的应用流程也没有给出足以量化真机泛化的统一成功率。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【设置】训练用 64 张 H100;静态/动态消融同初始化与训练配方,在 RL 前评估。QuantiPhy 去两分支为 30.20,完整 SFT 为 38.72。 §5.1、表 5 ↗
我的解读我的解读:比只看最终大表更能定位属性监督的贡献,但尚需控制移除数据造成的总量变化。
来源证据【表 3】PhysUniBench 59.42,相比 Qwen3.5-4B 的 48.00;FysicsEval Understanding 98.27。 表 1–4 ↗
我的解读我的解读:不同指标不能互换;“17/21 领先”只针对报告列出的比较系统。
来源证据【反例】MMMU 62.11 低于 Qwen3.5-4B 的 77.60;AIME26 为 3.33,低于 Qwen2.5-Omni-7B 的 10.00。 表 1、4 ↗
我的解读我的解读:物理训练并未带来所有通用能力的同步提升。
来源证据【筛选】估算避免 2687.7 GPU 小时;四类数据剔除比例 44.15%–73.99%。 表 7 ↗
我的解读我的解读:这是避免的训练量估计,不是扣除四次采样后测得的净节约,也缺少等预算随机筛选对照。
开放情况与使用许可
论文给出官方 GitHub 与模型链接;本次 GitHub 页面/API 返回 404,Hugging Face API 返回 401,无法核实实际代码、权重和许可证。因此保留待核实状态,不凭论文的开放措辞标为开源。
LICENSE实现与权重许可未核实;论文许可见原图署名。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
显式保存材质、时间和声画解释,配合分支消融,有助于检查物理答案究竟利用了哪些信息。
反方 · 哪些结论还不够
物性标签多为教师与类别先验推断;固定策略筛题可能造成难例选择偏差,仿真应用尚缺真实闭环证据。
综合判断
适合研究物理多模态监督配方,应把参数先验用于可校准的仿真输入,不能把高问答分数当成真实物性识别精度。
我会先做的验证
未执行的验证方案:收集同外观不同内部质量、不同摩擦的实测物体,盲测数值误差与置信区间;在等训练预算下比较随机筛选、奖励差异筛选及动态重采样。