OMVV:什么时候换一个便宜的验证器,什么时候请强验证器?
在线路由、独立阈值与随机审计共同作用;保证针对有条件的累计误差
OMVV维护多个弱验证器,每轮只调用一个,再决定接受、拒绝或交给昂贵oracle。它利用候选答案之间的一致性校正分数,并从抽样获得的oracle反馈更新阈值和路由权重。论文把核验成本与错误控制结合,但真实成本、可靠真值和冷启动仍是落地关键。
图解主要方法
在只有部分真值反馈时,怎样同时学习验证器选择与接受边界?
- 1
一次生成固定候选集,每轮只调用一个弱验证器
GPT-4o-mini先为每题生成五个候选,随后逐一核验。按历史权重随机选择一个弱验证器,避免每轮都跑整个集成;其0–1自评分与另外候选的答案一致比例经各自的逻辑回归合成分数。
- 2
为每个验证器维护接受、拒绝两条阈值
分数高于上阈值直接接受、低于下阈值拒绝、中间交给oracle。两个验证器各有自己的阈值和分数映射,避免把不同评分尺度混用;oracle返回标签后更新相应阈值并保持上下顺序。
- 3
在自信区也抽查,修正选择性反馈偏差
接受与拒绝区仍以正概率抽查oracle,按查询概率倒数加权更新。算法中这些审计标签用于学习,不改变已经作出的接受或拒绝决定;不确定区才直接按oracle标签决策,二者不能混淆。
- 4
用双重重要性权重学习下一轮路由
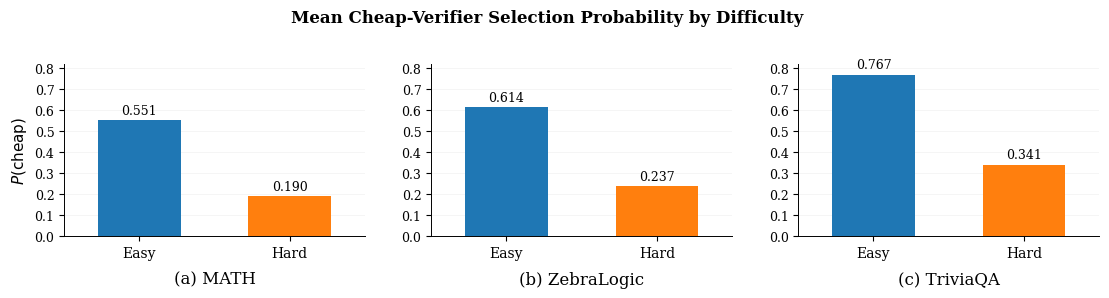
分数误差只有“选到该验证器且查询oracle”时可见,因此除以两种概率的乘积;已知固定成本每轮对所有验证器计入,再作指数权重更新。图1显示易题较常选择便宜模型,但路由不直接读取难度标签,也不是逐题最优分类器。
实验与证据
完整阅读算法、两项定理证明、附录实验及提示模板;核对原图和首发页,未发现可确认的官方实现链接。
来源证据MATH400题只选难度1与5各200;Zebra200题、TriviaQA400题、DeepMind线性二元方程600题,各自易难均衡;每题五个候选。 第6节、表1 ↗
我的解读人为构造的难度流便于观察适应,却不能代表真实业务分布。问题准确率和候选级错误率使用不同分母,应分别解释。
来源证据两个弱验证器Qwen2-1.5B与Qwen2.5-3B分别赋成本0.10/0.20,oracle为1.0;程序判题也统一赋1.0。 第6节 ↗
我的解读这是归一化验证成本,不是美元、FLOPs或时延;程序判题实际可能比LLM更便宜。预生成五个答案的开销没有计入该表,不能直接声称端到端省钱。
来源证据MATH/TriviaQA的oracle为GPT-4o,Zebra和方程任务采用确定程序;主表目标αI=αII=0.2。 第3–6节、附录B.4 ↗
我的解读前两者仍可能有裁判误差,理论真值假设不自动成立。误接受率分母是所有错误候选,不是所有已接受候选,二者对使用者风险的含义不同。
来源证据主表OMVV在四任务准确率分别73.25/85.50/83.25/96.67%,平均核验成本0.3080/0.3659/0.2778/0.2627。 表1 ↗
我的解读四者均优于文中两条基线,但未报告训练/路由种子置信区间;收益混合分数校准、候选一致性和路由,缺少同组件消融。
来源证据定理余量含1/(ηN)、sqrt(log(1/δ)/(Nqmin))等项;期待遗憾在固定K和正qmin下为O(sqrt(T))。 定理1–2、附录A ↗
我的解读减少抽查虽省oracle调用,却会放大统计余量和反馈方差;时域T固定的高概率界不等于所有时间同时的保证,固定专家基准也弱于动态最优。
来源证据MATH便宜验证器平均选择概率易题0.551、难题0.190;每题交替时仍报告72.50%准确率。 图1–2、表2 ↗
我的解读图1是条件平均,不能说明每个难题都选强模型。附录遗憾曲线趋平只是有限轨迹诊断,不替代理论条件或多次运行验证。
开放情况与使用许可
2026-10-11核对论文、首发页并按完整标题检索,未找到可确认的作者代码仓库、权重或复现实验包。已公开的是论文与提示,不称开源。
LICENSE论文arXiv非独占托管许可;尚无已确认代码或权重许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
MATH的400题实验准确率73.25%,两个单验证器为67.75%和69.75%;归一化核验成本0.3080,低于0.3713与0.3425。
在每题交替简单和困难的MATH流中,准确率72.50%,累计误接受/误拒绝为13.85%/16.01%,说明收益并非只在一次难度切换下出现。
反方 · 哪些结论还不够
理论是给定时域、正探索概率、可靠标签下的α加有限样本余量,并非逐条或任意时刻严格低于α。
路由遗憾比较“最佳固定验证器”的分数平方误差加弱验证器成本,不包含oracle调用费,也不保证追上每题最优的动态专家。
改进同时包含路由、分数合并与选择性核验;缺少隔离消融,不能把全部收益归因于多验证器选择。
综合判断
可借鉴的是部分反馈下的审计与路由设计。当前证据支持小规模任务流中的成本—准确率折中,尚不足以承诺真实系统的端到端节省或事实正确保证。
我会先做的验证
建议实验,未执行:固定候选答案和统一分数校准,分别移除路由、候选一致性及随机审计,跑多种顺序和种子;加入oracle标签噪声并报告实际token费用、延迟、分类条件错误率及接受答案中的错误比例。