On-Policy Self-Training:让带提示的自己教会不带提示的自己
自生成题目和特权信息,怎样变成学生真正能独立使用的能力?
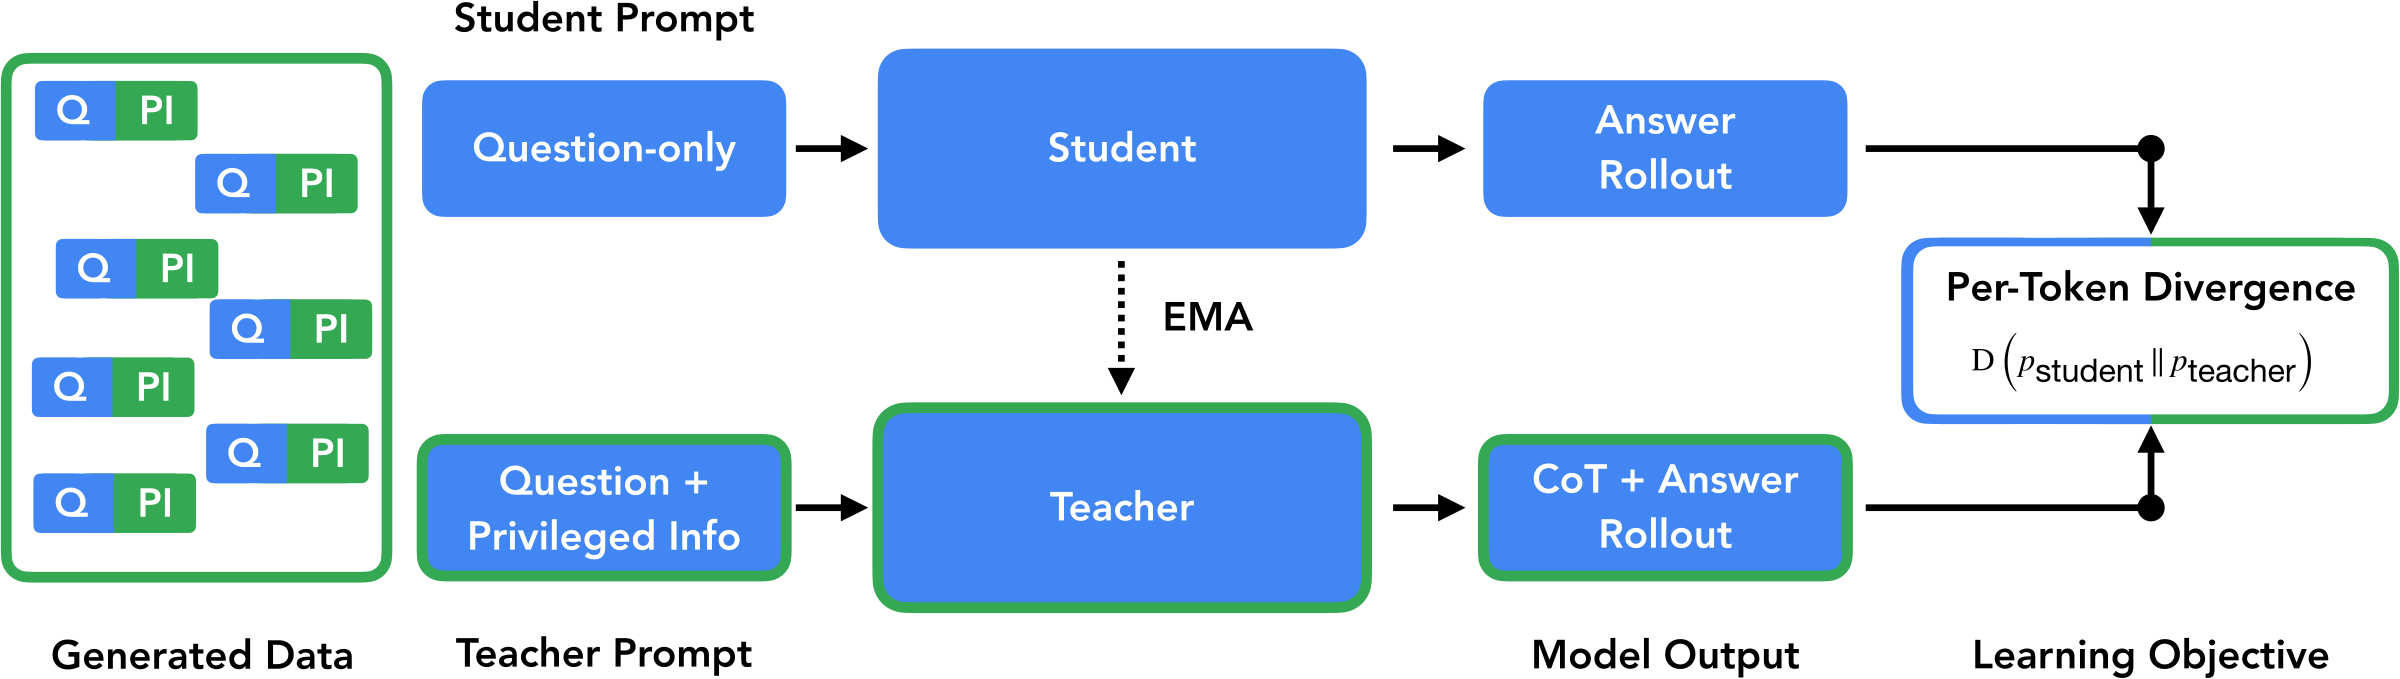
OPST 用模型自产的问题、推理与答案建立带特权信息的教师,再在学生自己的回答轨迹上做逐词蒸馏。Gemma 4 E2B 非思考模式的 MMLU 从37.5升至47.7,但跨任务平均提升掩盖了数学退步:它提供的是有条件的自训练配方,而非无监督产生新知识的证明。
图解主要方法
自生成题目和特权信息,怎样变成学生真正能独立使用的能力?
- 1
1 · 生成后还要筛题
围绕给定主题生成问题、解释和答案,把后两者作为教师可见的特权信息(PI)。在独立上下文和问题改写下检查答案一致性,再过滤学生已能稳定答对的简单题。这里的“无外部数据”仍依赖主题描述与预训练知识;视觉版本还使用无标签图像,一致也可能一致地错。
- 2
2 · 图2里的学生先走自己的路
学生只看问题,自回归产生回答;教师看问题加PI,在同一学生轨迹上给出下一词分布。逐词分布散度提供密集训练信号,比只奖励最后答案更明确,但教师不是外部真值裁判。
- 3
3 · 用慢更新教师维持训练目标
教师参数通过学生的指数移动平均更新,训练与生成新题交替进行。附录消融中EMA系数0.05对应MMLU47.7,不使用EMA仅38.1;这里比较的是论文的固定训练设置。
- 4
4 · 分开检查模式与域外代价
七轮是报告设置中的最佳点,十二或二十轮均为46.2,不能假定多训练总更好。思考模式与非思考模式收益也不同,应分别报告知识问答、数学和视觉任务,而不是只给一个平均数。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
开放情况与使用许可
已核对论文全文、附录与首发信息;本次未确认作者正式代码或权重发布入口,按论文公开处理。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把学生实际会产生的错误轨迹纳入蒸馏,是比直接拟合自产答案更有解释力的改进;EMA和轮次消融支持训练稳定性的重要性。
反方 · 哪些结论还不够
自验证不能排除共同错误或预训练污染;实验集中于少数Gemma规模,教师没有外部事实校准,数学退步与多轮回落均已出现。
综合判断
值得复现的自训练方法,但只能声称在报告设置下改善若干任务;不能据此宣称模型实现持续、无代价的自我进化。
我会先做的验证
未执行的验证方案:固定训练token和主题预算,对比原模型、自生成答案SFT、OPST无EMA与完整OPST;用未参与筛题的事实集和MATH500分层检查退化,并人工审计一致但错误的伪标签。