OnPoKD:让蒸馏目标随样本可靠性变化
视觉语言模型分类适配;on-policy 控制器不是强化学习训练
固定教师可能把错误或对新类别的偏差传给学生。OnPoKD 用教师、学生和冻结零样本先验的可靠性线索,为每个样本调整目标混合、损失权重与温度;部署时删除控制器,保留原学生分类结构。
图解主要方法
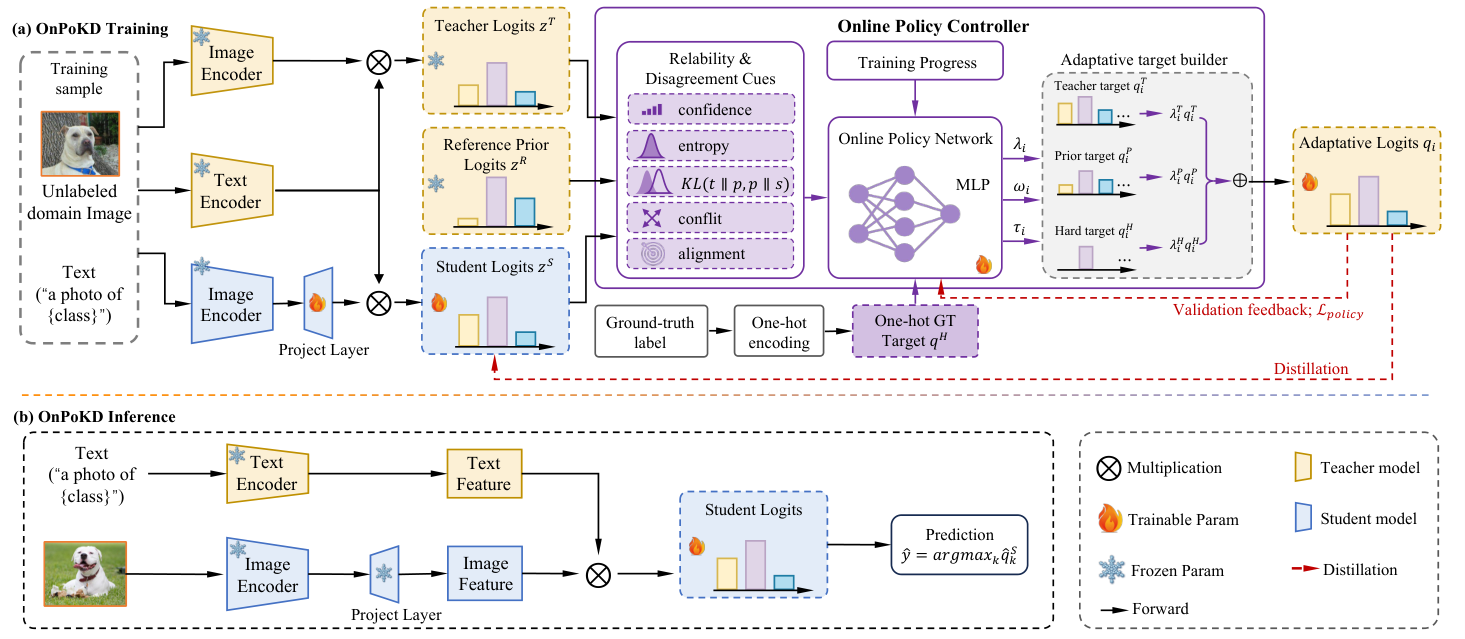
图 3 的控制器学的是什么,它为何需要验证集标签?
- 1
构造三方可靠性线索
图左同一图像分别经过适配教师、当前学生和冻结零样本参考分支。置信度、熵、分歧及训练进度组成 11 维线索;这些线索衡量预测关系,不会直接告诉控制器某次预测一定正确。任务是 CLIP 式图像分类适配,不是生成式大模型逐 token rollout。
- 2
用验证标签规定目标动作
图中两层轻量网络输出三路混合系数、样本权重和有界温度。源验证集的正确性信号经确定性 F_val 规则构造目标动作,再以 L2 损失监督控制器;虽然名称为 on-policy,它不是策略梯度、强化学习或通过学生更新反向传播的元学习。
- 3
把动态目标交给学生蒸馏
控制器按当前学生状态混合教师、参考先验等目标,再用样本权重和温度形成 KL 蒸馏约束。混合、权重、温度需要共同检查,单独学混合并不自动稳定;验证反馈若接触目标域也会改变任务定义。
- 4
推理时只留下学生
图下半部分删去教师、控制器和先验分支,以学生图像/文本特征计算分类得分。推理结构不增加开销,不代表训练免费:需要额外前向、验证反馈及维护多个分支。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【11 数据集 base-to-novel】作者报告调和平均从 83.73 到 84.62,新类别准确率从 80.73 到 82.13。 主结果表 ↗
我的解读我的解读:增幅支持样本级目标的价值,但没有充分随机种子、置信区间等信息,不能把平均优势当成每个数据集稳定获益。
来源证据【跨数据集协议矛盾】表 3 的说明包含未标注目标训练图像,正文又称训练未见目标数据;报告平均值 72.66,对照 71.33。 跨数据集表 3 与正文协议 ↗
我的解读我的解读:这两种协议代表不同的迁移设置。在作者澄清前,只保留原报告数值,不把它宣传成严格的无目标数据零样本迁移。
来源证据【机制和成本】FGVC 的仅混合配置为 25.78,固定目标 46.64,完整配置 47.66;训练时间增加约 19–25%、内存约增加 51%。 消融及训练成本说明 ↗
我的解读我的解读:组合控制确有必要,也暴露了控制器失稳风险。没有直接的通用 corruption 基准,不能延伸成已验证的全面鲁棒性。
开放情况与使用许可
09-09 首发,按回顾补收。全文与算法已读;文中提及配置,但未核实可用的官方实现或权重链接,不能标为已开源。
LICENSE论文与图 3 为 CC BY 4.0;实现及权重许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
显式暴露目标混合、温度和样本权重三个可审计决策,比把教师视为永远正确更有研究价值。
反方 · 哪些结论还不够
跨域训练协议存在未解决矛盾,控制器依赖验证标签;单组件可能显著退步,独立实现和统计稳定性尚待确认。
综合判断
可作为视觉语言分类蒸馏方案研究,暂不据此声称生成式大模型的推理或严格零样本迁移获得同等改善。
我会先做的验证
未执行的验证方案:先公开源训练、源验证和目标测试的不可重叠清单,再比较有/无目标域无标签图像两种协议;固定教师和预算,至少三训练种子同时测新类别、校准误差、控制器动作分布与训练成本。