OpenViTac:把视觉触觉策略放进成对仿真与真机任务比较
历史触觉早期融入π₀.₅有收益,但每任务单独训练且精密插装仍困难
OpenViTac把接触能力拆为物性、易损交互、接触操作和精密操作,提供11个仿真与8个配对真机任务。OpenVTLA用AnyTouch2编码触觉历史,将压缩token投影后前置到π₀.₅的视觉序列。它改善所测任务平均成功率,但仍是每任务独立策略;配对仿真也不等于精确触觉物理孪生。
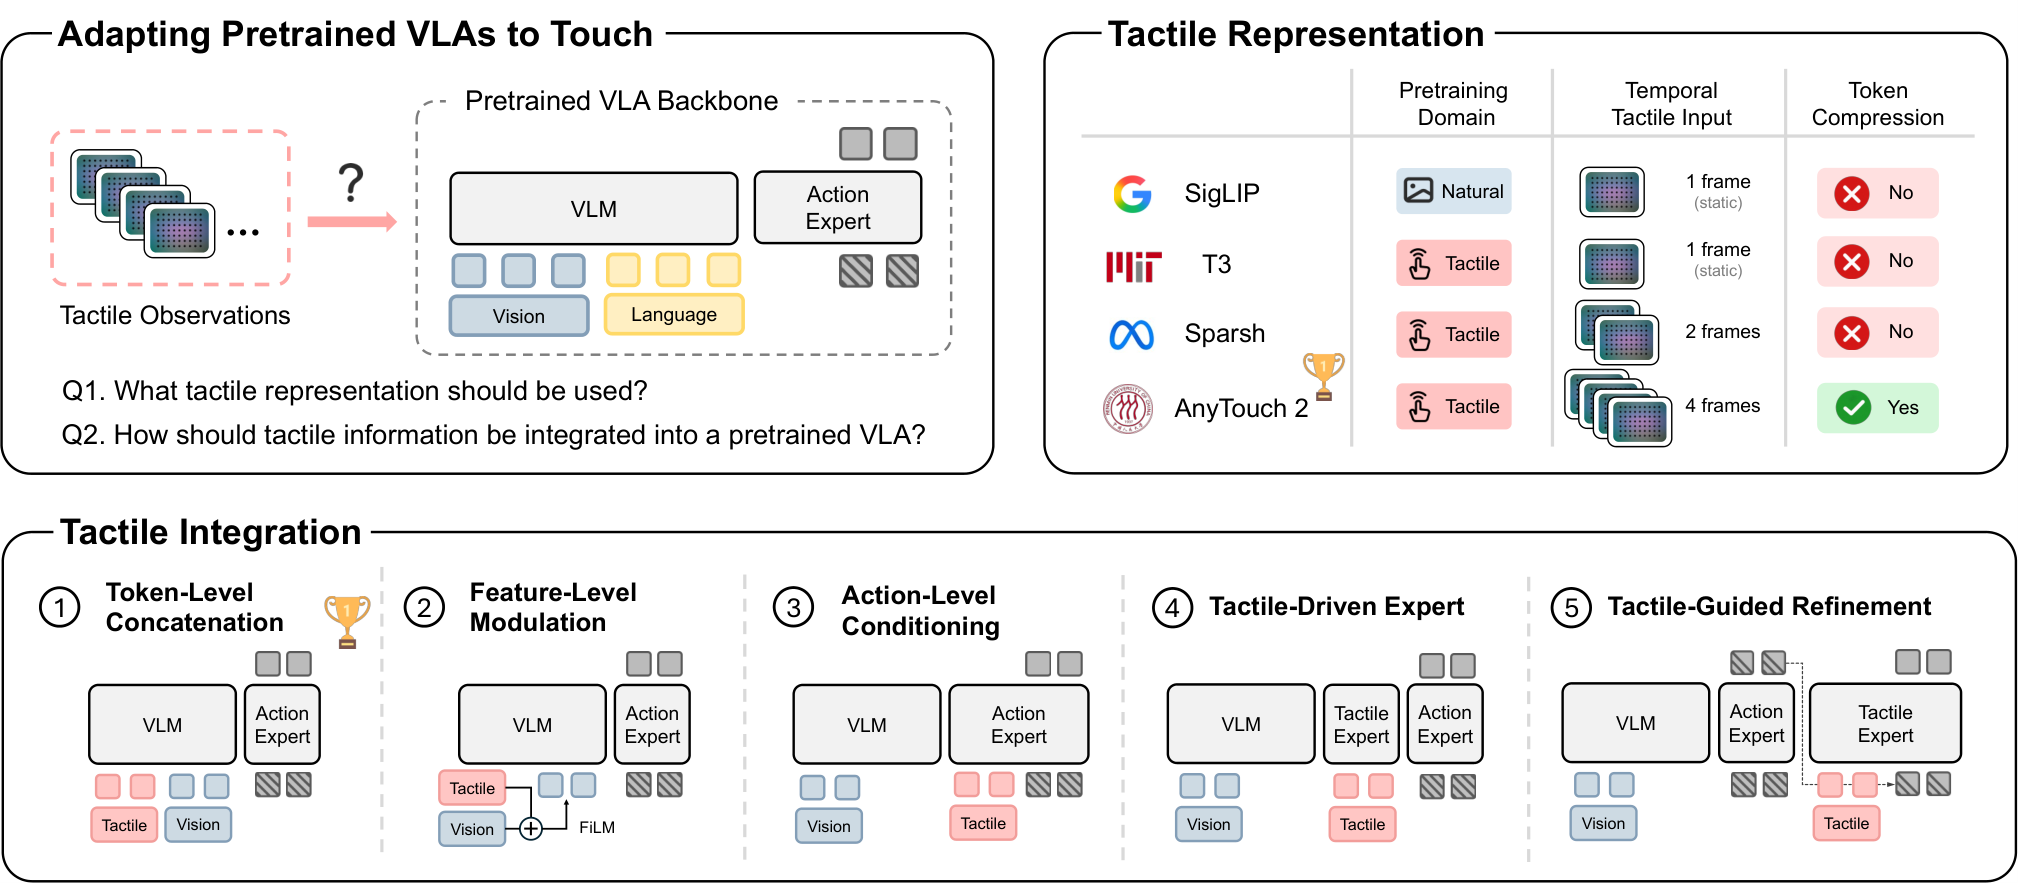
图解主要方法
触觉的时间表示和接入VLA的位置,怎样在成对仿真与真机中公平评价?
- 1
按接触能力组织任务
11仿真任务分物性识别、易损交互、接触操作和精密操作;8个有对应真机。每任务训练独立策略,不能把合计表现理解成一个通用机器人。
- 2
构造对应资产与环境
多视图重建配合功能部件和子动作标注,统一视觉/触觉几何,Isaac Sim、Isaac Lab与TacEx支持不同夹爪和触觉传感器;场景外观可变,但接触材料模型仍有现实差距。
- 3
编码时间触觉
AnyTouch2将4帧触觉历史压缩为token,投影到VLM隐藏维度;静态SigLIP、T3及两帧Sparsh构成表示比较,另用重复当前帧测试时间增益。
- 4
在VLM输入处融合
触觉token前置到π₀.₅视觉序列,保留原语言与动作路径,不增独立触觉专家。比较FiLM、动作条件、触觉专家与动作细化,但部分比较编码器也变化。
- 5
固定真实示范进行混合训练
每任务100条真实示范,增加250或500条仿真并保持优化预算;按概率α采样域,数据规模与采样比是不同变量。主实验采用各模型原生训练配置,最终checkpoint评估。
实验与证据
全文61826字符、附录A–E和表格读完,原图3视觉核验;实际打开官方项目页、首发及许可,核对网页和论文数值差异。
来源证据同一拼接融合下SigLIP59.5%、T3 58.1%、Sparsh64.7%、AnyTouch2 68.7%;AnyTouch随机初始化56.5%,重复当前帧58.4%。 表IV–VI ↗
我的解读支持预训练和历史有效,但不能据此推断任意触觉数据都需此编码器。
来源证据11仿真任务OpenVTLA68.7%、FTP61.2%;8真机任务54.6%、51.9%,按任务不加权平均。 表II–III ↗
我的解读不同领域任务数不同,不能直接把仿真真机均值之差当统一迁移落差。
来源证据真机OpenVTLA:粗糙度19/20、空罐17/20、夹芯片19/20、齿轮10/20、抽屉12/20、USB4/20、积木3/20与5/30。 表III ↗
我的解读均值掩盖精密任务瓶颈;积木v1低于π₀.₅的5/20,触觉收益并非所有任务一致。
来源证据100真实+500仿真:OpenVTLA USB4/20→8/20、齿轮10/20→12/20,二任务平均+15pp;π₀.₅为3/20→8/20、7/20→10/20。 表VII ↗
我的解读仅两个任务、小样本,没有区间;固定优化预算有帮助但不足以证明普适sim-to-real规律。
来源证据环境换光时OpenVTLA从2/20、10/20到6/20、12/20;π₀.₅从0/20、2/20到4/20、8/20。 表VIII ↗
我的解读场景多样化可能提升外观稳健性,不能归因物理接触模型已准确。
来源证据π₀.₅与OpenVTLA 20000步batch64,InternVLA40000步batch32,WAM配置5000或20000步batch8。 附录D ↗
我的解读跨家族比较不是计算量严格匹配的架构因果实验;采集总量也不等于每任务训练样本。
开放情况与使用许可
官方页面未提供实现仓库、数据下载或模型权重;资源开放范围尚不能核实,不标记代码开源。
LICENSE论文及图3为CC BY 4.0;尚未核实代码、模型或数据许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定融合方式的编码器消融与预训练、时间历史消融,支持触觉表示和时间信息有效。
配对任务及固定真实数据、增加仿真数据的比较,比只报仿真成功更接近部署问题。
反方 · 哪些结论还不够
摘要附近WAM均值53.3/48.5与主表Fast-WAM仿真37.4/真机29.0不一致,采用主表逐项数据。
论文配对相关系数0.967,官方网页写0.913;不把任一值当作已独立重算的事实,二者都不是单场景迁移保证。
真机每任务20次、困难积木30次,54.6对51.9的2.7pp差距缺区间;精密操作仍低。
综合判断
有价值的是统一成对评估与简单早期触觉融合的消融证据;尚不支持通用触觉策略、仿真可替代真机或精密操作问题已解决。
我会先做的验证
建议实验(尚未执行):固定同一AnyTouch2及训练预算比较全部融合方法,公开α混合比例与成功阈值;每任务多种子、更多真机试次,增加未见传感器/物体,并分开报告数据与标定成本。