OpenVLHarness:视觉代理需要能复用的证据,而不只是更多工具
把定位、深度、搜索结果保存为可寻址对象,再交给同一骨干模型计算
无需微调的视觉工具框架,将九类能力接到多模态模型,并在单个问题内保留图像、数组和网页句柄。22项基准显示平均提升,但附录也揭示坐标格式、错误对象选择与无证据猜测仍可能得到正确评分;分数提升不等于推理链全部可靠。
图解主要方法
把定位、深度、搜索结果保存为可寻址对象,再交给同一骨干模型计算
- 1
给工具一个统一任务接口
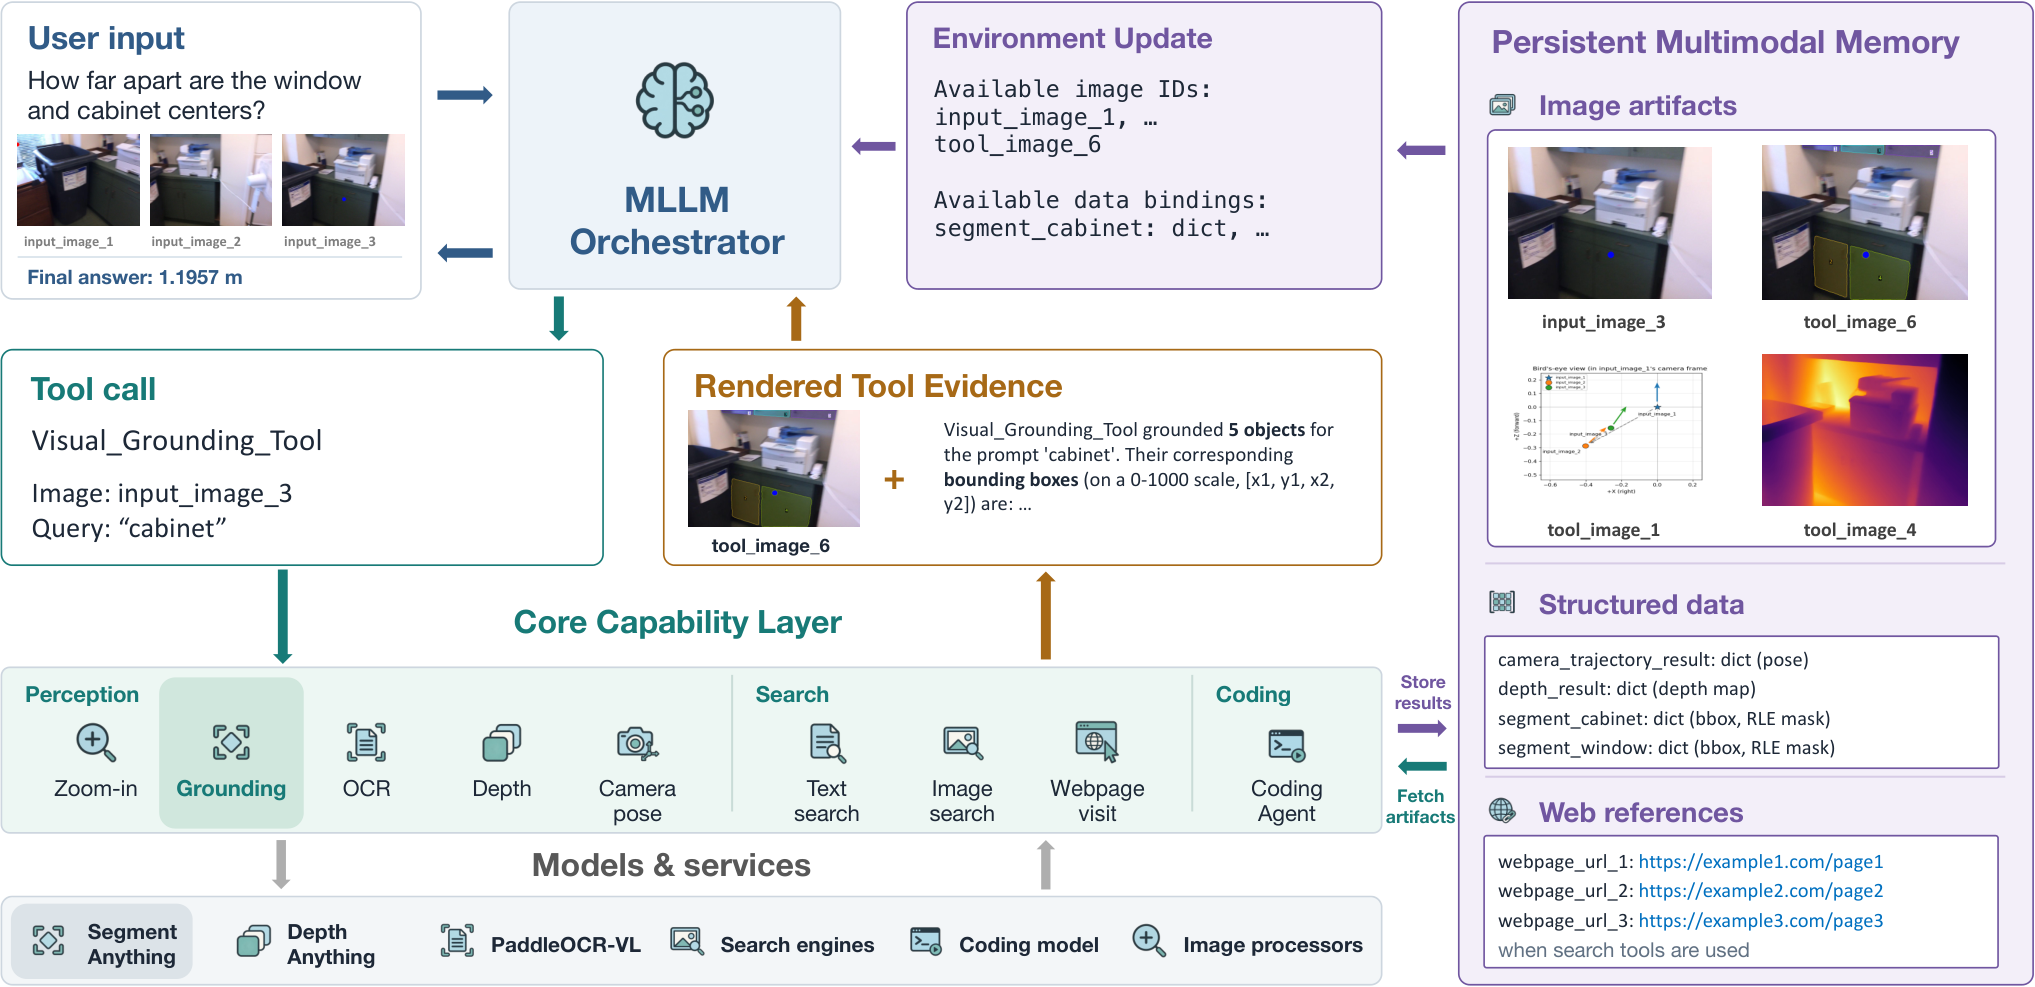
图2中的定位、OCR、深度、相机位姿、裁剪、三类搜索与Python计算共九种能力,由类型化参数连接SAM3、PaddleOCR-VL、Depth Anything3及搜索服务。结果同时返回可视覆盖图、短文本和结构化数据,降低主模型解释原始张量的负担。
- 2
将证据存成句柄而非反复抄写
图像、掩码、深度数组、相机参数和网页引用注册到当前问题的多模态记忆;Environment Update公布可用ID与变量。后续可对自己裁出的区域反向搜图,也可把同一定位结果交给深度计算。这里的持久化仅限一次问题,不是跨会话长期记忆。
- 3
在独立代码上下文中组合证据
编码代理使用与主代理相同骨干,接收计算目标及已有数据绑定,在新上下文生成并执行Python。跨视角距离例可用内参反投影与外参变换,而不是让语言模型心算所有坐标。调用失败允许反馈与重试。
- 4
检查证据链而不只看最终选项
图2展示的1.1957m来自附录例17,但该例实际选错柜子并误解框坐标格式;接近1.1m真值不能证明测量正确。方法价值在可审计的数据流,部署还需对象身份、坐标系、深度尺度和代码结果的验证层。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-VL-8B平均34.24→45.41,32B为38.30→50.92;Qwen结果为3次均值,其他骨干并非全部多次重复。总均值混合计数、定位、搜索、问答和空间指标。 主结果表 / 22基准 ↗
我的解读支持广泛受益,不是同一概率意义的准确率,也不能由均值推断每个任务或每次均改善。
来源证据能力接口与记忆的分步加入均提升平均分;消融子集不同于完整主表,不能直接把各阶段差值加到完整榜单。 消融 / 每数据集最多500例 ↗
我的解读组件有实证作用,但需在同等工具、预算和搜索服务下比较;部分基线没有搜索或使用较旧感知工具。
来源证据GPT-6 Luna中等推理配合框架平均56.52,高于单模型最大推理的48.84;图中费用为模型token成本。 成本图 / 模型token口径 ↗
我的解读工具GPU、搜索服务及评审等成本未完整计入,不能宣称同样比例的端到端省钱或低延迟。
来源证据例3无工具F1=0主要因像素坐标未转0–1000;转换后也达F1=1。例9省份答案缺完整检索支持;例14选错目标桌子,例17选错柜子且误读框格式,仍获正确或接近评分。 附录17个完整案例 ↗
我的解读必须同时审查过程正确性。精选轨迹不是总体错误率估计,工具链也不会自动消除幻觉。
来源证据对9893条Kimi失败进行分类,并以100条人工核对得到92%一致;工具选择、停止与证据使用仍有问题。 错误诊断 ↗
我的解读分类有助于定位工程改进,但不是各模块错误的因果消融,人工样本也有限。
开放情况与使用许可
已核对官方GitHub实际Python实现和MIT许可证,含代理、工具服务与评测代码;无需新增训练权重。README列出7个主实验骨干预设,附录Qwen2.5-VL-7B配置未随发行提供。感知权重、评测数据和付费搜索服务受各自条款约束。
LICENSECC BY 4.0(论文原图);代码MIT,依赖另行许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把视觉证据变成可复用图像与数组,能把检索、感知和计算连起来,适合研究多模态代理的工具接口与过程审计。
反方 · 哪些结论还不够
搜索摘要另用Qwen3-VL-8B,收益不能只归因主模型;第三方工具、费用和许可各自独立。类型接口仍不能防止错对象、错坐标和搜索摘要幻觉,精选成功例甚至包含推理错误。
综合判断
值得复用其证据管理架构;评估应同时报告最终答案与中间计算正确率,而不能把所有答对都解释为视觉推理增强。
我会先做的验证
未执行的验证方案:固定同一骨干、工具版本、检索缓存和总成本预算,加入对象身份与坐标系自动断言;全测试集标记答案正确但过程错误,测量延迟、工具费用与失败重试成本。