OPRD:让代码智能体从失败轨迹中的提醒学习
训练时可见诊断提醒,部署时不带提醒,怎样避免把未来信息收益算成推理能力?
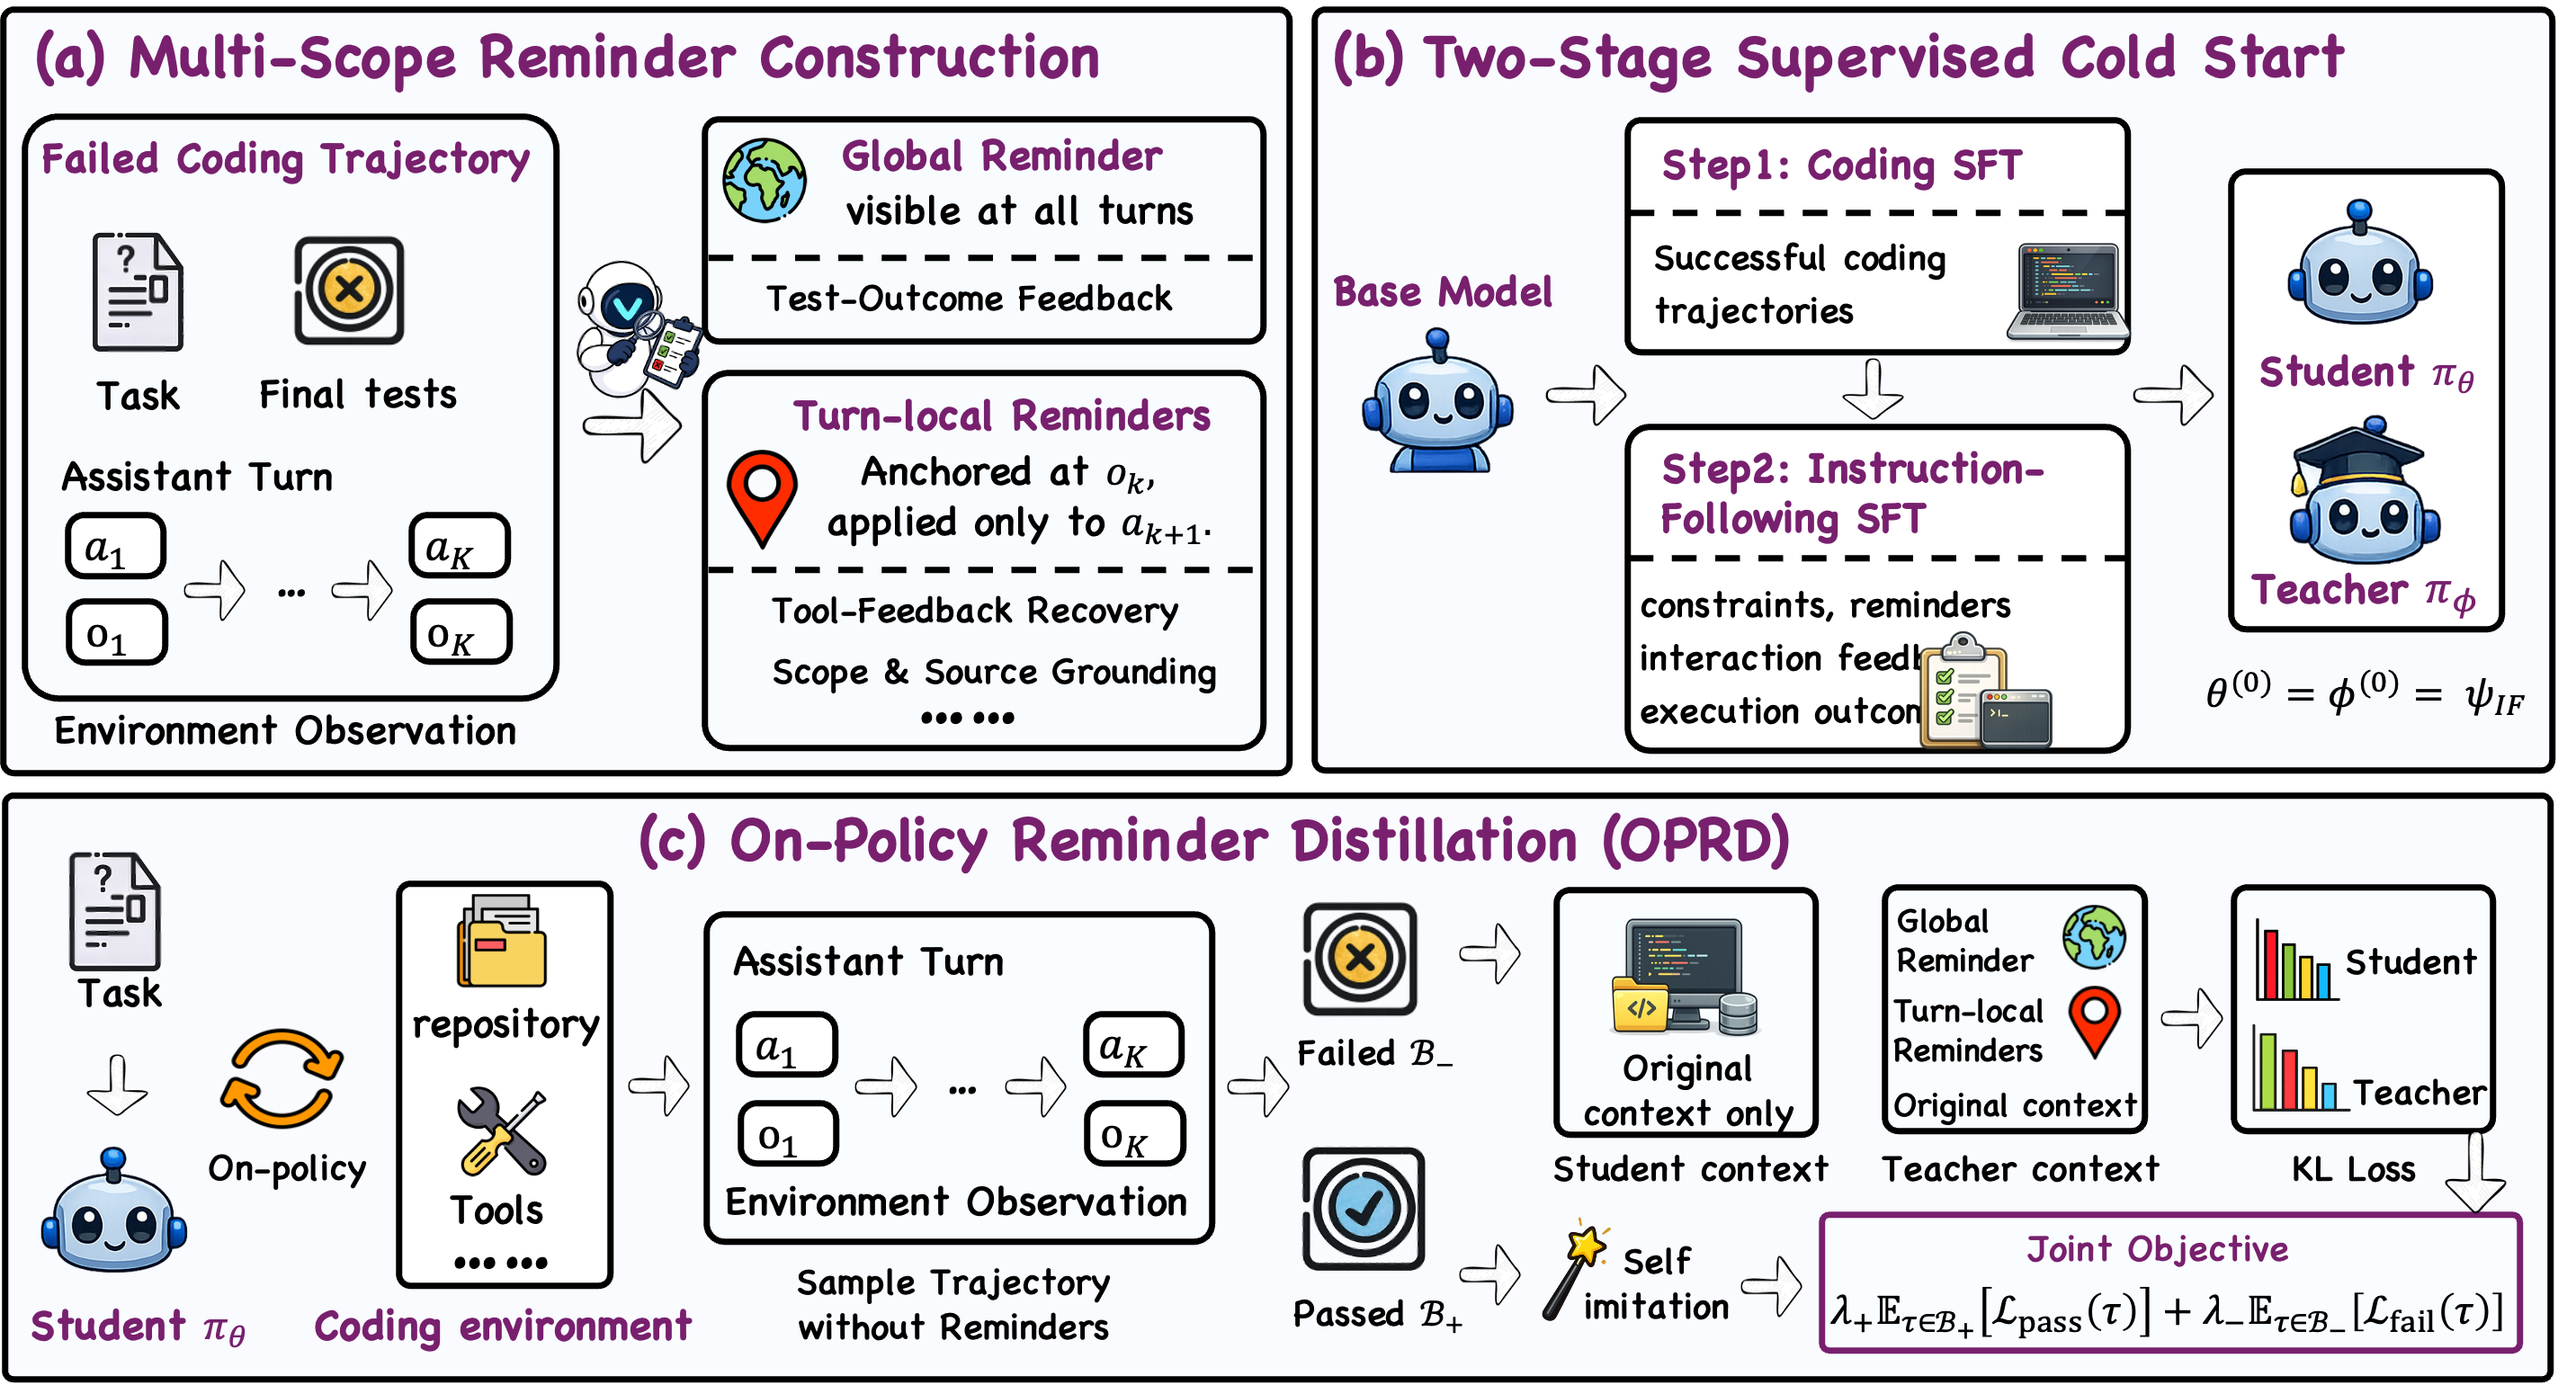
OPRD先生成无提醒的学生轨迹,再让带全局和局部提醒的教师在相同前缀上提供分布监督。成功轨迹做自模仿,失败轨迹用反向KL,目标是将提醒遵循内化到较小代码模型。
图解主要方法
训练时可见诊断提醒,部署时不带提醒,怎样避免把未来信息收益算成推理能力?
- 1
分清全局与局部提醒
全局提醒可由最终测试诊断构造,适用于整段教师轨迹;局部提醒由特定环境观察触发,仅作用于下一轮,不自动延续。全局提醒包含训练时特权信息,不能当成部署时已知的测试反馈。
- 2
共同初始化后让学生独立探索
教师和学生先接受8000条Coding SFT轨迹和2000条IF SFT样本。在线任务池为3630个SWE-rebench与370个Multi-SWE-RL任务;学生采样不带提醒,教师在学生原前缀上预测,而非重新采样更容易的教师轨迹。
- 3
按结果选择学习目标
通过轨迹用交叉熵自模仿;失败轨迹用学生到提醒教师的反向KL。分布计算取两者top-100 token并集后重新归一化,温度1。这样将输出修正与通过轨迹保持分开,避免把所有样本一律蒸馏。
- 4
分阶段更新教师,再无提醒评测
训练在20/40/60/80步复制学生为教师,其间冻结教师;报告16张H20、3轮训练与131072上下文。最终通过同一Claude Code harness测试,最多200轮、temperature=1、top-p=0.95。
实验与证据
已阅读正文、附录A–G及PDF第15–19页的完整五页运行时提醒判别模板(图9–13),核对实验条件与方法原图;未独立复现。
来源证据4B基础模型三套SWE评测平均36.6,经Coding SFT为39.3、IF SFT为41.6,完整OPRD为47.9;完整模型Verified 61.2、Pro 30.5、Multilingual 52.0。9B平均44.4到55.9。 正文主结果表与训练配置 ↗
我的解读4B相对基础的11.3点包含前置SFT收益;相对IF SFT的增量为6.3点,不能全归因在线提醒蒸馏。
来源证据全部轨迹反向KL为46.0,按成败路由为47.9;另一方向消融中前向KL45.2、反向KL46.7。教师更新次数增加并非单调变好。 消融:结果路由和KL方向 ↗
我的解读支持结果分流在该配方中的作用;不同消融基线要各自对齐,不能把几组差值相加。
来源证据事后诊断错误事件从446降至222;IF SFT模型提醒遵循率77.1,对比Coding SFT 49.3。错误识别使用模型裁判及完整轨迹上下文。 200任务诊断与附录 ↗
我的解读错误事件不是独立任务数,也不是经人工验证的线上因果失效;裁判可见完整轨迹与运行时可见信息不同。
开放情况与使用许可
论文及原图CC BY 4.0。当前论文公开链接未核实到可用官方实现或模型权重,暂仅计论文公开,不将方法描述当成开源发布。
LICENSE论文与原图 CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
成功保持与失败纠偏分开,且在学生实际访问的前缀上蒸馏,可减轻离线教师轨迹与学生状态不匹配。
反方 · 哪些结论还不够
训练使用最终测试诊断等特权信息,模型裁判也有误差;单一代理harness、任务池和完整训练成本限制外推,尚未证明同算力下普遍优于其他蒸馏方案。
综合判断
值得在有可执行测试的代码任务中复验,重点检查提升究竟来自前置SFT、特权反馈还是在线分布匹配;不能写成运行时零成本获得未来测试信息。
我会先做的验证
未执行的验证方案:固定任务、学生基础与总计算预算,分别去除最终诊断、只保留局部观察、固定教师或更新教师;用独立人工错误审计和多随机种子报告成功率、工具调用成本及训练开销。