按提及顺序寻址:模型怎样从上下文中找到一个事实
一次残差向量干预能改选事实,但并非通用长文检索定律
研究比较模型面对同一事实列表、切换提问对象时的最后提示token状态差异。跨上下文平均得到的序数向量,可把模型从第一个事实引向第二个事实,即使名字、内容和关系改变。控制实验区分事实顺序、名字顺序与token距离,提出中间层“事实地址”假说。
图解主要方法
模型在上下文里寻找事实时,能否把事实的顺序地址与具体名字、答案分开?
- 1
构造事实与提问交叉
独立名字和内容词集,循环改变事实顺序与绑定;比较同一上下文不同提问的最后提示token、同一Transformer块输出状态。
- 2
校准跨上下文序数差
在独立词集平均第p条到第q条提问状态差;假说将状态近似分成上下文偏移、顺序地址与残差,随后一次加到新接收上下文。
- 3
用完整答案检验转移
保持原问题不变,只改一个位置一个块,重算后续层;贪心最多16token,完整答案必须等于指定事实内容,同长度随机方向和本上下文目标状态作对照。
- 4
排除名字与token距离
双主语让名字序号偏离事实序号,重排事实检验向量应随新顺序变化;填充句改变绝对/相对token距离,跨六关系及短散文测迁移。
- 5
追踪低秩几何及深度
按顺序模板拟合三维子空间,跨独立词集检验向量组合;逐层比较序数向量、外来完整状态和外来首答案token,再看十个OLMo预训练检查点。
实验与证据
正文及附录A–G全部理论、控制、模型尺度与预训练检查点阅读;图3核验,官方实现目录及MIT许可实际打开。
来源证据四事实、每模型64新词集、12288组合,指定答案转移Qwen84.1±2.0%、Gemma53.9±1.6%、Llama36.2±1.6%;随机方向≤.01%。 表1A;附录A ↗
我的解读±是95%词集自举区间的一半,不是标准差;本上下文状态替换上限96.9/96.4/91.9%,说明未完全控制检索。
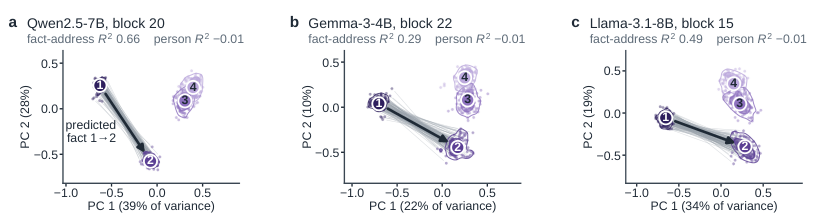
来源证据事实地址模板解释.66/.29/.49查询相关方差,人物模板约−.01;双主语Qwen按事实向量转移65.3%,按名字向量0%。 图3;附录C ↗
我的解读图3投影来自校准池八词集拟合、另八词集展示;解释率用16校准词集留一验证,不应说全来自64最终测试词集。
来源证据填充条件下,事实顺序答案比绝对距离预测答案高72.1、58.9、28.4个百分点。 附录D.4 ↗
我的解读反驳该短材料中简单token距离解释,不排除复杂长文本中的位置与词汇混合机制。
来源证据三维地址子空间包含69/33/52%留出状态差能量,随机约.1%;独立词集分段向量组合余弦.99/.97/.98。 附录E.1 ↗
我的解读低秩是部分而非整个模型表示;最佳三维参考在测试差上拟合,是样本内上界。
来源证据四、六、八事实Qwen转移75.6/50.4/33.7%,Llama20.1/11.0/7.2%;首事实最好。 附录E.2 ↗
我的解读本组词池与主表不同,不能混用84.1作为四事实基准;空间拥挤与成功相关不是已验证长文失中原因。
来源证据37–87词散文转移44.5/42.4/14.0%,相同内容列表80.5/52.2/29.3%。 表7 ↗
我的解读自然化仅短模板段落,性能明显降低;不能称跨任意文体稳定。
来源证据OLMo反转余弦5B token时+.98,42B时−.61;事实地址R²由0到.52,但共享窗口在105B、3.9T又未达阈值。 图6;表4 ↗
我的解读顺序结构可早于稳定答题出现,深度分布持续迁移;单个固定层能力下降不等于模型整体遗忘。
开放情况与使用许可
官方仓库包含experiments、relgeom、绘图及数据汇总目录,并提供三主模型专用序数向量和加载示例;基础模型权重需另按各自条款获取,未在本机复现实验。
LICENSE代码MIT;论文CC BY 4.0;基础Qwen、Gemma、Llama权重许可独立适用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
改变名字、事实排列、双主语、关系和填充长度,多种对照区分竞争解释。
独立词集选层与校准,测试计入错误原答、非法及截断输出,区间按词集聚类。
反方 · 哪些结论还不够
共享地址是近似假说:Gemma主层仅解释29%查询相关方差,不应称完全编码规则。
12288测试案例组合自64词集,不是12288独立语言情境;语义模板仍狭窄。
预训练阶段共享窗口反复出现/消失,不能描绘为单调获得能力;与人类首因现象相似不是认知机制相同。
综合判断
受控短上下文中有较扎实的事实顺序寻址证据;向长文失中、多步推理和真实记忆机制推广仍是待检验假说。
我会先做的验证
建议实验(尚未执行):在长自然文档、多事实同实体、否定与修订事实、跨段指代中重复独立校准;比较词汇/位置机制和干预副作用,并跨模型层选择规则复测。