PACE:四比特循环状态,先减少舍入次数
周期缓冲、通道分组与少量高精度头,各解决什么误差?
线性注意力的循环状态反复被量化会积累误差。PACE把逐token舍入改为周期刷新,再沿持续异常值所在的通道分组,并给误差难衰减的少量头更多精度。它压缩的是循环状态,不是所有权重或全部KV缓存。
图解主要方法
周期缓冲、通道分组与少量高精度头,各解决什么误差?
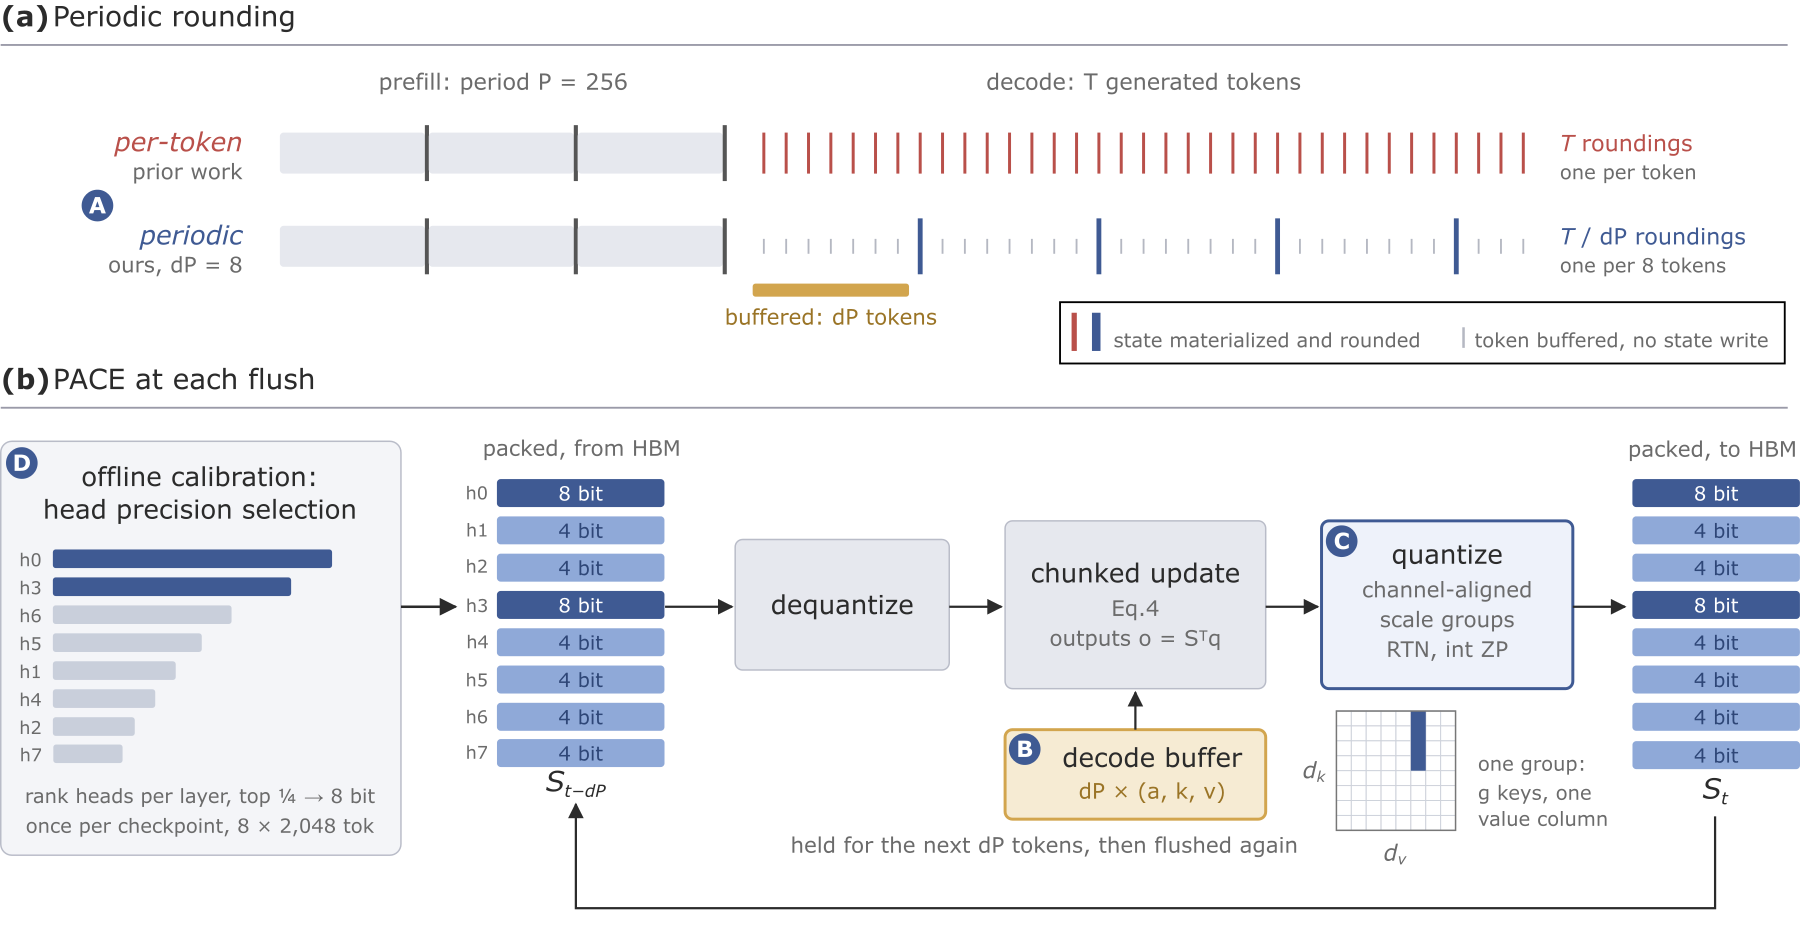
- 1
把状态更新延迟到周期边界
图2A/B在解码时暂存8个token的更新信息,到刷新点才解量化、执行块更新并重新压缩。prefill周期固定256,与decode的dP不同。缓冲额外占内存,比较时必须一起计入,不能只报主状态4bit。
- 2
沿key轴共享量化尺度
同一value列的异常值会持续存在。沿key轴分组让尺度适配这些通道,减少少数异常值把整块正常数值的分辨率压低;它解决尺度错配,周期更新解决反复舍入,二者不是同一改动。
- 3
给难以遗忘误差的头8bit
用8段2048token进行离线校准,依据误差及衰减形成保留误差指标,选择25%的头保留8bit,其余4bit。混合缓冲采用key4bit和value bf16,但效果依模型而异;理论近似依赖独立舍入误差等假设。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据平均83.7与DAMP相同,含缓冲驻留位数6.82对9.90;IFEval81.3低于83.4。 Qwen3.5-9B综合评测 ↗
我的解读压缩与平均性能兼顾并不意味着每项任务无损。
来源证据混合缓冲平均79.1,低于int8缓冲80.8。 4B与缓冲消融 ↗
我的解读不能默认更精细设计在所有规模都更好,需按工作负载验收。
来源证据512上下文测试使用uniform INT4,未完整运行通道对齐和头混合的全部PACE方案;Q-Mamba比较未执行其原始微调。 H100 PCIe吞吐条件 ↗
我的解读吞吐提升主要来自缓冲,不能把该速度直接贴给完整精度最优配置,也不能将对照称作完全等预算。
开放情况与使用许可
论文全文可读,当前论文来源未提供可核实的官方实现与权重发布入口;本期标为论文公开。
LICENSE论文 CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把误差来源拆成刷新频率、尺度布局和遗忘能力,比统一提高所有状态位宽更有针对性。
反方 · 哪些结论还不够
实验集中于4个Qwen混合模型;真实长上下文、完整混合内核与端到端服务吞吐仍需验证。
综合判断
论文支持状态内存优化路线,尚不能据局部内核速度宣称完整部署收益。
我会先做的验证
未执行的验证方案:在相同总内存、batch、上下文和硬件下实现完整三项方案,同时记录长序列质量、吞吐、尾延迟及缓冲占用。