PASSAGE:让人形机器人组合穿越动作
看见地面、侧面和头顶障碍,再规划能实际执行的身体动作
将场景对齐的人体示范、局部三层高程图、流匹配规划器和感知式全身跟踪器连接起来,让机器人根据目的地组合跨越、侧身和低头动作。
图解主要方法
不用为每种障碍手写技能切换,机器人能否自己组合穿越动作?
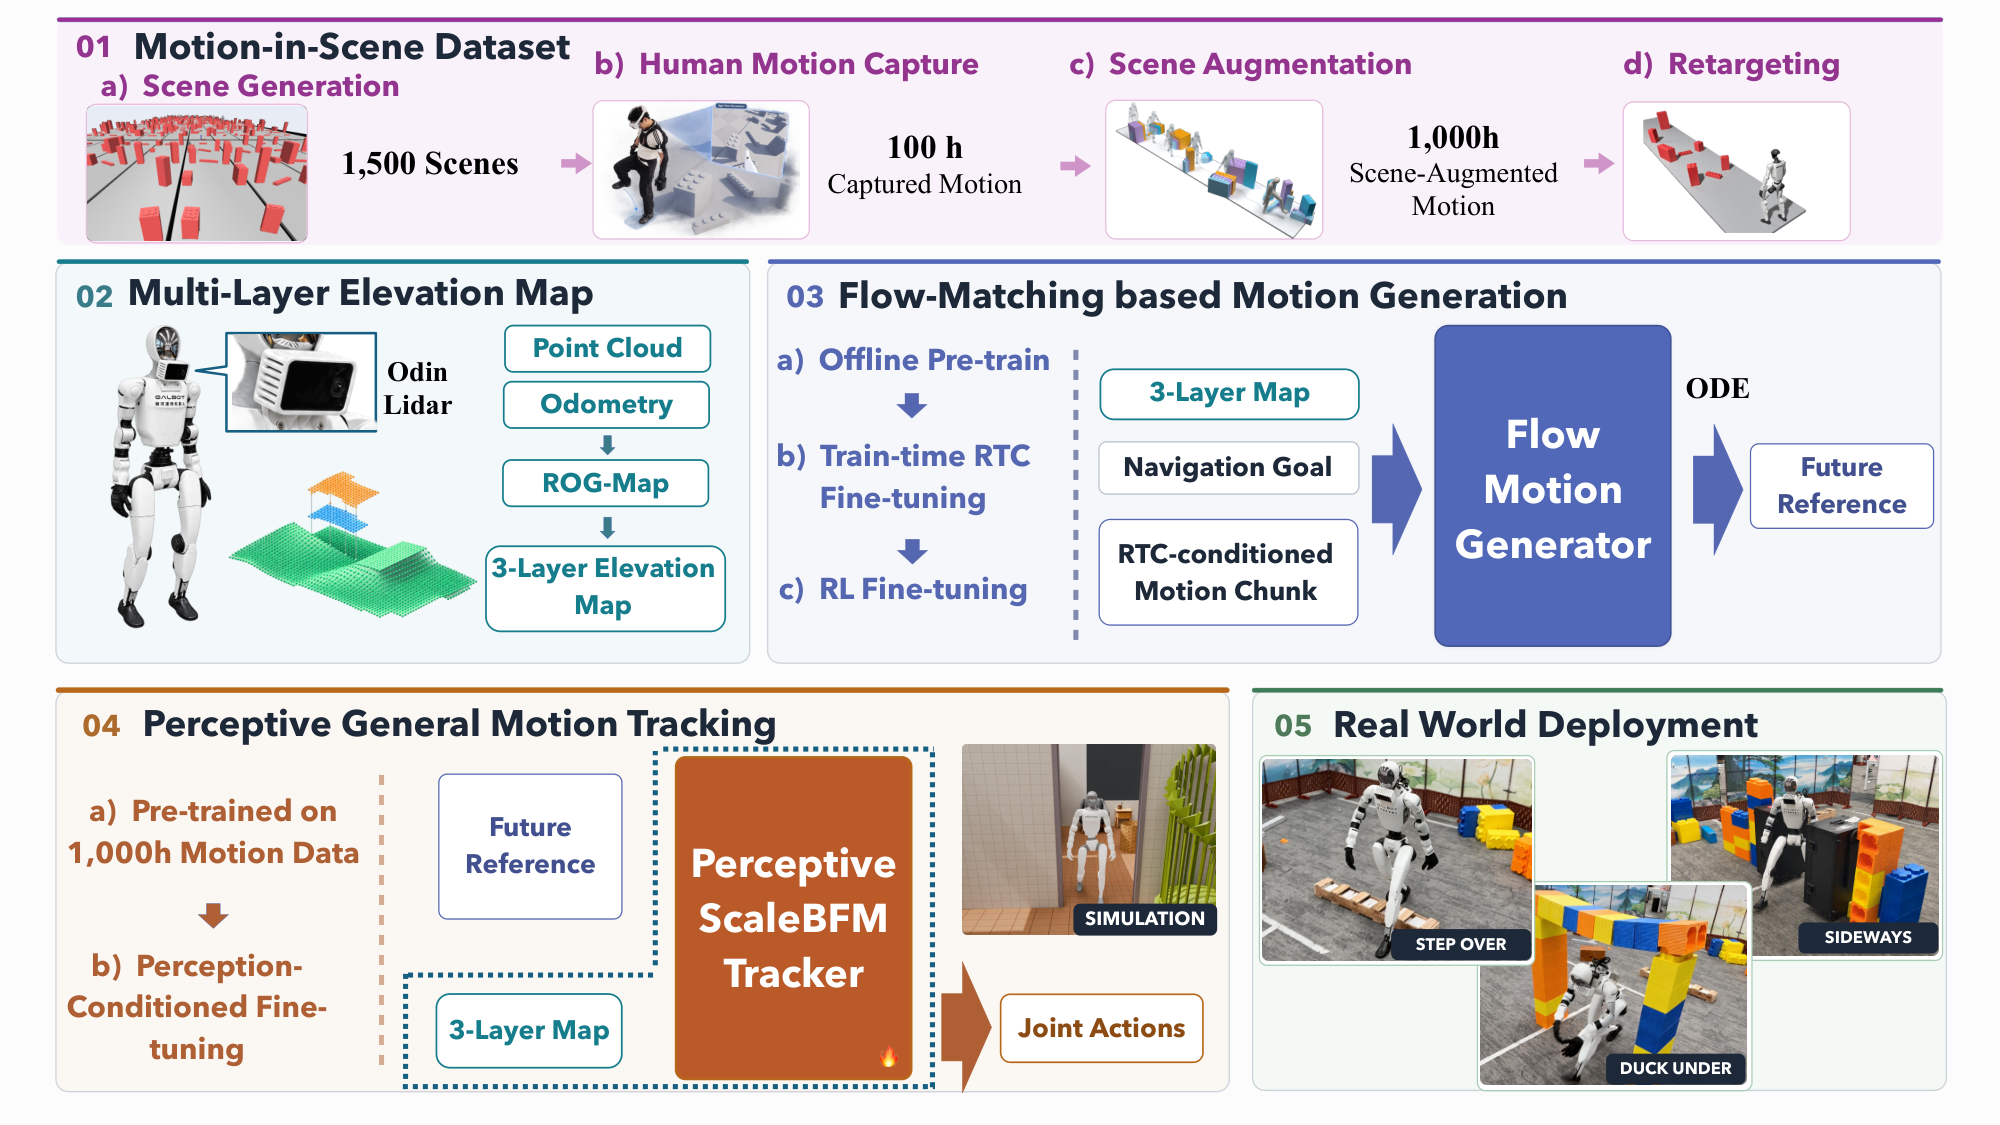
- 1
01:人体动作必须与环境对齐
图上方先采集 100 小时人体运动,再通过场景变体扩成约 1,000 小时动作—场景配对;后者不是新增采集的 1,000 小时。
- 2
02 → 03:把空间约束交给规划器
机载点云形成三层高程图,表达支撑面、侧向障碍及头顶余量。规划器结合历史与目的地预测短时动作;RTC 用上一段未执行部分约束下一段,减少跳变。
- 3
04 → 05:跟踪器执行,规划器再适应执行结果
感知式 ScaleBFM 跟踪器把参考变成关节命令。闭环后训练只更新规划器,跟踪器冻结;部署时规划为 6.25 Hz,跟踪为 50 Hz。
实验与证据
真实 50 个布局均到达,但其中五次存在接触;仿真基线的数据与训练条件存在差别。
开放情况与使用许可
已读论文方法、实验与部署章节,并核对作者 GitHub 文件树。仓库目前主要是网页、演示素材和论文,未发现规划器、控制训练实现或模型权重。
LICENSE论文为 arXiv 非独占托管许可;控制实现和权重许可未核实
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把感知同时提供给规划器和跟踪器,使低层能够应对参考动作与现场几何的偏差,减少只能等下一次规划再纠正的问题。
分块衔接关注的是动作序列之间的连续性;这对长任务比单段动作看起来顺滑更有意义。
反方 · 哪些结论还不够
终点指标可能容忍擦碰,把它单独作为可靠性指标会遮蔽重要失败。机器人在人旁工作时,还要区分接触强度、部位和对象。
图中跟踪器还使用另一套通用动作预训练数据。只用“100 小时示范”概括全部训练成本,会低估系统依赖。
没有逐场景重复试验,无法判断漂亮演示对初始姿态、传感噪声和障碍微小变化有多敏感。
综合判断
有实机闭环证据的穿越框架,数据和控制接口的组合值得借鉴。现有结果支持局部障碍组合,尚不足以支持无人监督的开放环境运行。
我会先做的验证
建议实验,尚未执行:对同一组 20 个未见布局各重复十次,随机改变初始朝向、照明和小幅障碍位置;记录接触次数、接触强度、安全接管、跌倒及完成时间,并保留所有失败视频。