PDRVLA:从中间视觉语言层提取物理动态 token
视频动态监督怎样进入动作专家,而无需推理时生成视频?
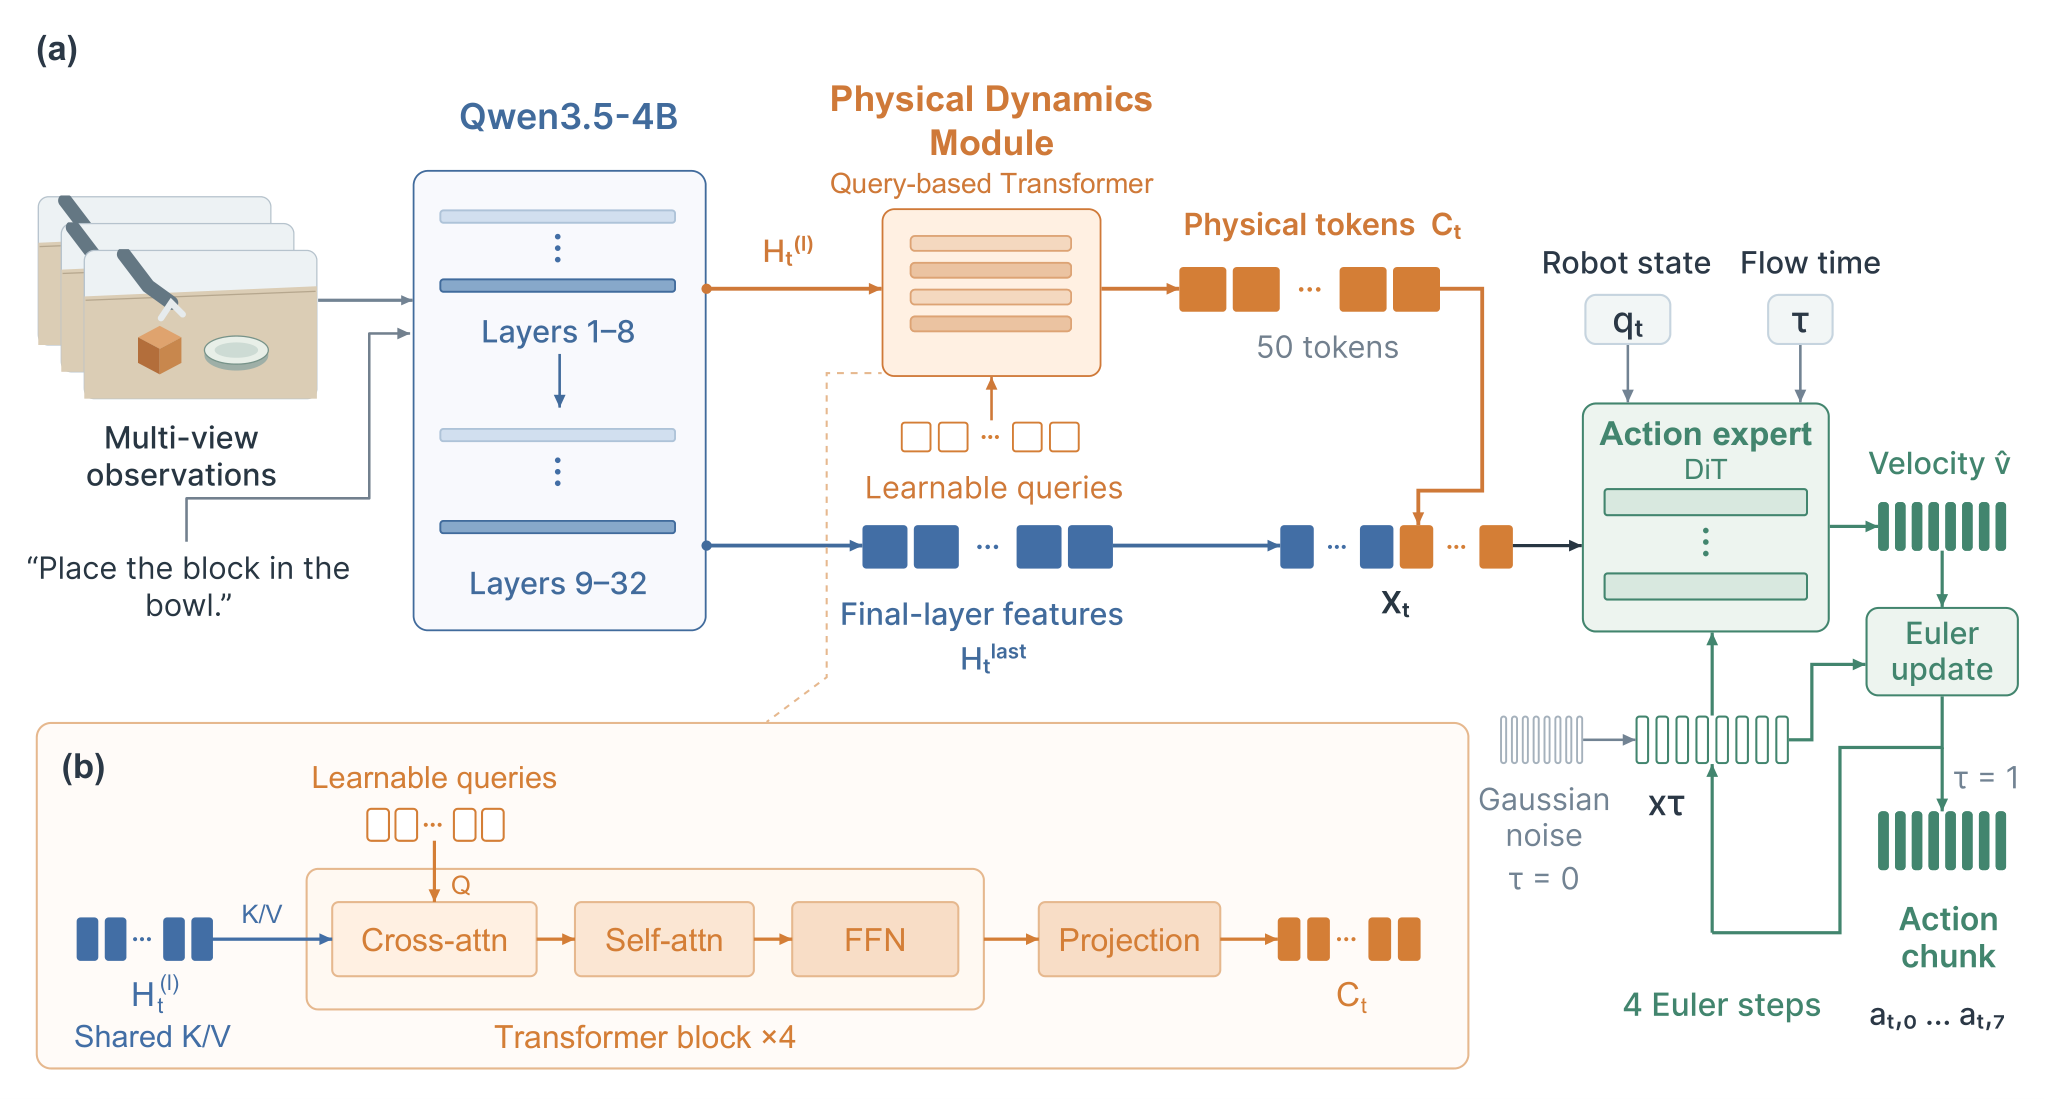
PDRVLA 为 VLA 增加57.3M参数的物理动态模块,从 Qwen3.5-4B 中间层提取50个token,与末层语义一起驱动动作专家。物理监督在训练时发生,部署并不运行视频世界模型。
图解主要方法
视频动态监督怎样进入动作专家,而无需推理时生成视频?
- 1
中间层保留空间动态
图3从32层VLM的第8层抽取特征,50个可学习query通过四层交叉/自注意力生成物理token,再映射到动作专家需要的宽度。与末层语义并行,而不是替换全部VLM。
- 2
未来信号用于训练
模块预测未来RGB、DA3深度、DPFlow光流特征,并通过冻结的1.3B视频生成器接受辅助动态监督;深度与流来自伪标签。联合训练中切断中间路径对VLM的反传,动作仍能经末层更新VLM。
- 3
动作解码不带视频生成器
物理token、末层特征与本体状态输入150M动作DiT,4次Euler步产生8步chunk并完整执行。58维统一动作空间对不适用维度掩码,不代表所有机器人原生控制空间完全相同。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据LIBERO99.3%(2000回合)、LIBERO-Plus89.9%(10030回合)、RoboTwin93.6%、Simpler81.5%。LIBERO-Long97.6低于参考LingBot-VA98.5。 主结果与设置 ↗
我的解读结果是多数据与多监督完整系统;不是所有子任务都领先,也没有对应实机闭环证明。
来源证据单种子控制实验中动态特征平均MSE .6439→.6354,改善1.32%,但光流相对改善区间跨0。ECoT提高Long的同时,Plus总分79.59→79.25。 动态监督与辅助任务消融 ↗
我的解读预测误差下降不能独立证明动作收益;辅助任务效果存在任务间取舍,消融训练规模也不能直接套到主榜。
开放情况与使用许可
论文公开;尚未核实到PDRVLA完整实现、模型权重和训练数据的官方发布。所用公开来源数据不等同作者处理后数据已开放。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
训练期动态监督和轻量推理接口分离,给物理先验融入VLA提供了可检查的具体路径。
反方 · 哪些结论还不够
数据混合、伪标签、子任务监督与骨干共同变化;控制消融以单种子为主,实际机器人泛化、动态标签误差和长chunk风险仍待验证。
综合判断
应视为多监督VLA系统,不能只把主榜提升归功于50个物理token。
我会先做的验证
未执行的验证方案:匹配数据与训练预算,对中间层位置、物理模块及动态监督分别消融;实机固定8步chunk并测接触失败和紧急停止延迟。