PLaW-VLA:预测未来表征,再让动作读取它
三专家策略把视频预训练、未来监督和动作条件分开检验;真实机器人报告的是任务进度
PLaW-VLA在冻结的V-JEPA 2表征空间预测未来,避免先生成完整视频再解码动作。语义、世界模型和动作三个专家通过结构化注意力交换信息。它在RoboTwin困难长任务上有明显改善,但噪声和相机变化仍是弱项;公开代码可训练,不等于已获得论文预训练策略。
图解主要方法
未来表征究竟提供了控制信息,还是仅仅增加训练数据和计算?
- 1
先分离当前语义与视觉历史
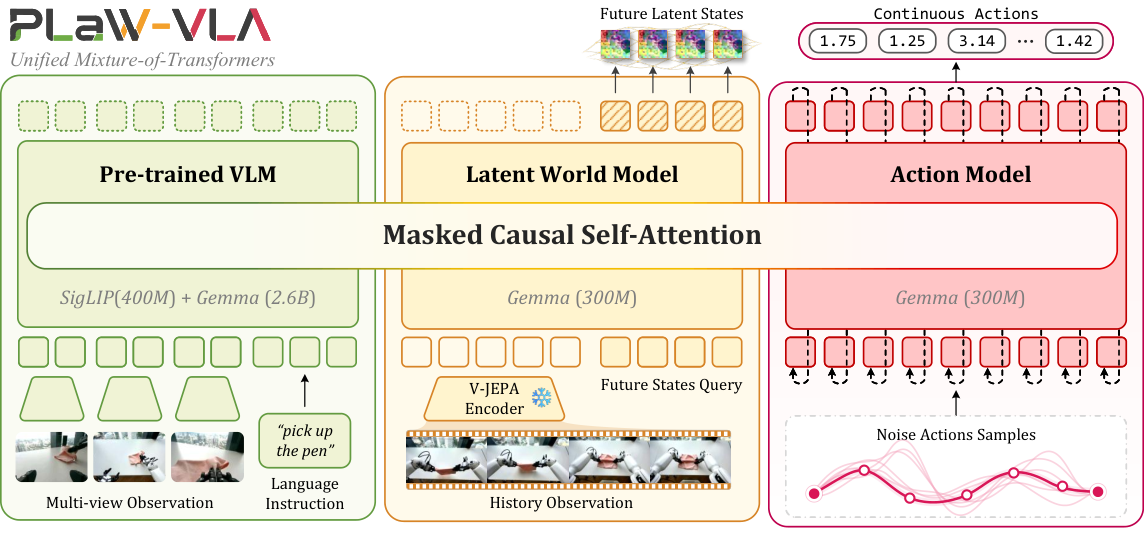
图2左侧PaliGemma处理多视角当前观测和指令;中间冻结的V-JEPA 2编码器处理历史视频,提供预测目标的空间。目标强调视频预测表征,但这不保证已经严格去除了所有控制无关因素。
- 2
并行预测两个未来时间单元
可学习查询同时读取历史与语义,输出未来潜变量。附录说明6帧形成三个两帧单元,当前单元之后预测K=2个单元;这里的两步不是两张单帧,也不是任意长度的想象轨迹。
- 3
让动作专家直接读取预测
结构化因果注意力让连续动作专家使用历史、当前语义和预测未来;流匹配生成动作块。未来回归目标使用冻结编码器和停止梯度,避免目标表征随训练一起塌缩。训练以0.3概率同时跳过历史/未来分支及世界模型损失,区别于仅遮蔽未来。
- 4
分三阶段把视频迁移到机器人
Stage I只用无动作监督的视频训练世界模型100k步;Stage II在机器人数据联合训练100k步;Stage III适配具体任务。所有视频统一到10Hz,机器人动作对齐到末端位姿与夹爪;LIBERO动作块均相对同一当前状态表达,而不是逐步累计增量。
实验与证据
阅读全文及附录A–D,核对仿真逐任务结果、三阶段训练和真实机器人评分规则。
来源证据LIBERO用1693条演示、40任务、每任务50次rollout、三种评测种子;采用30k检查点,平均97.4%,Long为94.6%。 表1、5、8与附录D.1 ↗
我的解读需与π0.5的96.9%平均、92.4% Long分开比较;不是所有suite都领先,50k时总均值96.95%,Long91.7%。
来源证据RoboTwin训练含2500条干净场景和25000条随机场景演示;Hard平均83.2%,Horizon III79.2%。 表3、7 ↗
我的解读长任务提升最大,但Handover Mic从97%降到81%、Place Dual Shoes从75%降到50%,均值掩盖了具体回退。
来源证据LIBERO-Plus完整模型72.70%,Cosmos VAE预测空间70.93%;去预测损失67.56%,去未来条件69.81%。 表4、10与附录B/D ↗
我的解读1.77个百分点是该受控表征替换结果;预测监督与未来读取均有贡献,但不能把不同预训练数据的总差异全归给架构。推理遮蔽未来造成4.35点下降还包含分布改变。
来源证据机器人每任务400条演示;六种设置各10位置×3次试验,每方法180次。叠毛巾二元评分,其他三类按阶段归一化。 第4.2节、图4、附录C ↗
我的解读网站概览把这些结果写作success,论文实际明确为task progress。文章依论文逐项区分完整完成和部分完成,未将80%进度自动解释为80%成功。
来源证据单H100对比π0.5增加约0.9B参数和70ms延迟;相对Motus约1/19推理延迟。 图5、第4.4节 ↗
我的解读这是指定硬件和比较设置的推理点,不是机器人物理任务快19倍;也没有证明在低功耗边缘设备上相同收益。
开放情况与使用许可
核对仓库提交b896805ae961ac5e502e76b76e3501ac865f70f5,存在模型、训练、数据转换和评测代码。README明确官方PLaW-VLA预训练检查点尚未发布;auto当前使用π0.5并初始化世界模型模块。
LICENSE源码Apache-2.0,第三方组件与Gemma、数据、下载权重保留各自条款;论文为arXiv非独占托管许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
RoboTwin Hard Horizon III由π0.5的67.4%升到79.2%,50个Hard任务中36个改善、4个持平、10个退步。
匹配Stage II数据且去掉Stage I时,保留世界模型的LIBERO-Plus为69.05%,去掉世界模型为65.49%;增加预测上下文本身仍有证据。
反方 · 哪些结论还不够
标准LIBERO平均97.4%只比π0.5高0.5个百分点;并不是每个子集领先。
LIBERO-Plus噪声55.2%、相机41.5%,都低于部分基线。真实机器人除叠毛巾外的分数是归一化进度,不能统称完整成功率。
综合判断
有价值的是用较轻的预测空间支持控制,并提供区分监督与条件读取的实验。证据支持特定长任务与扰动收益,尚不足以称通用可靠世界模型。
我会先做的验证
建议实验,未执行:固定Stage I–III数据、三种种子和30k/50k检查点,比较无世界模型、仅预测损失、真实未来和预测未来条件;逐类记录碰撞、相机变化、恢复率、完整成功及P95推理延迟。