PolyMorph:用身体拓扑组织跨机器人运动策略
同一策略如何适配关节数、体重和可用腿数不同的机器人?
PolyMorph 将关节和连杆参数变成节点,按运动学连接限制注意力,再与共享循环状态结合生成逐关节目标角。统一奖励归一化和机器人采样减少训练偏置;实机展示集中于 Raibo,未见本体的大范围泛化仍主要来自仿真。
图解主要方法
同一策略如何适配关节数、体重和可用腿数不同的机器人?
- 1
从URDF构建关节—连杆节点
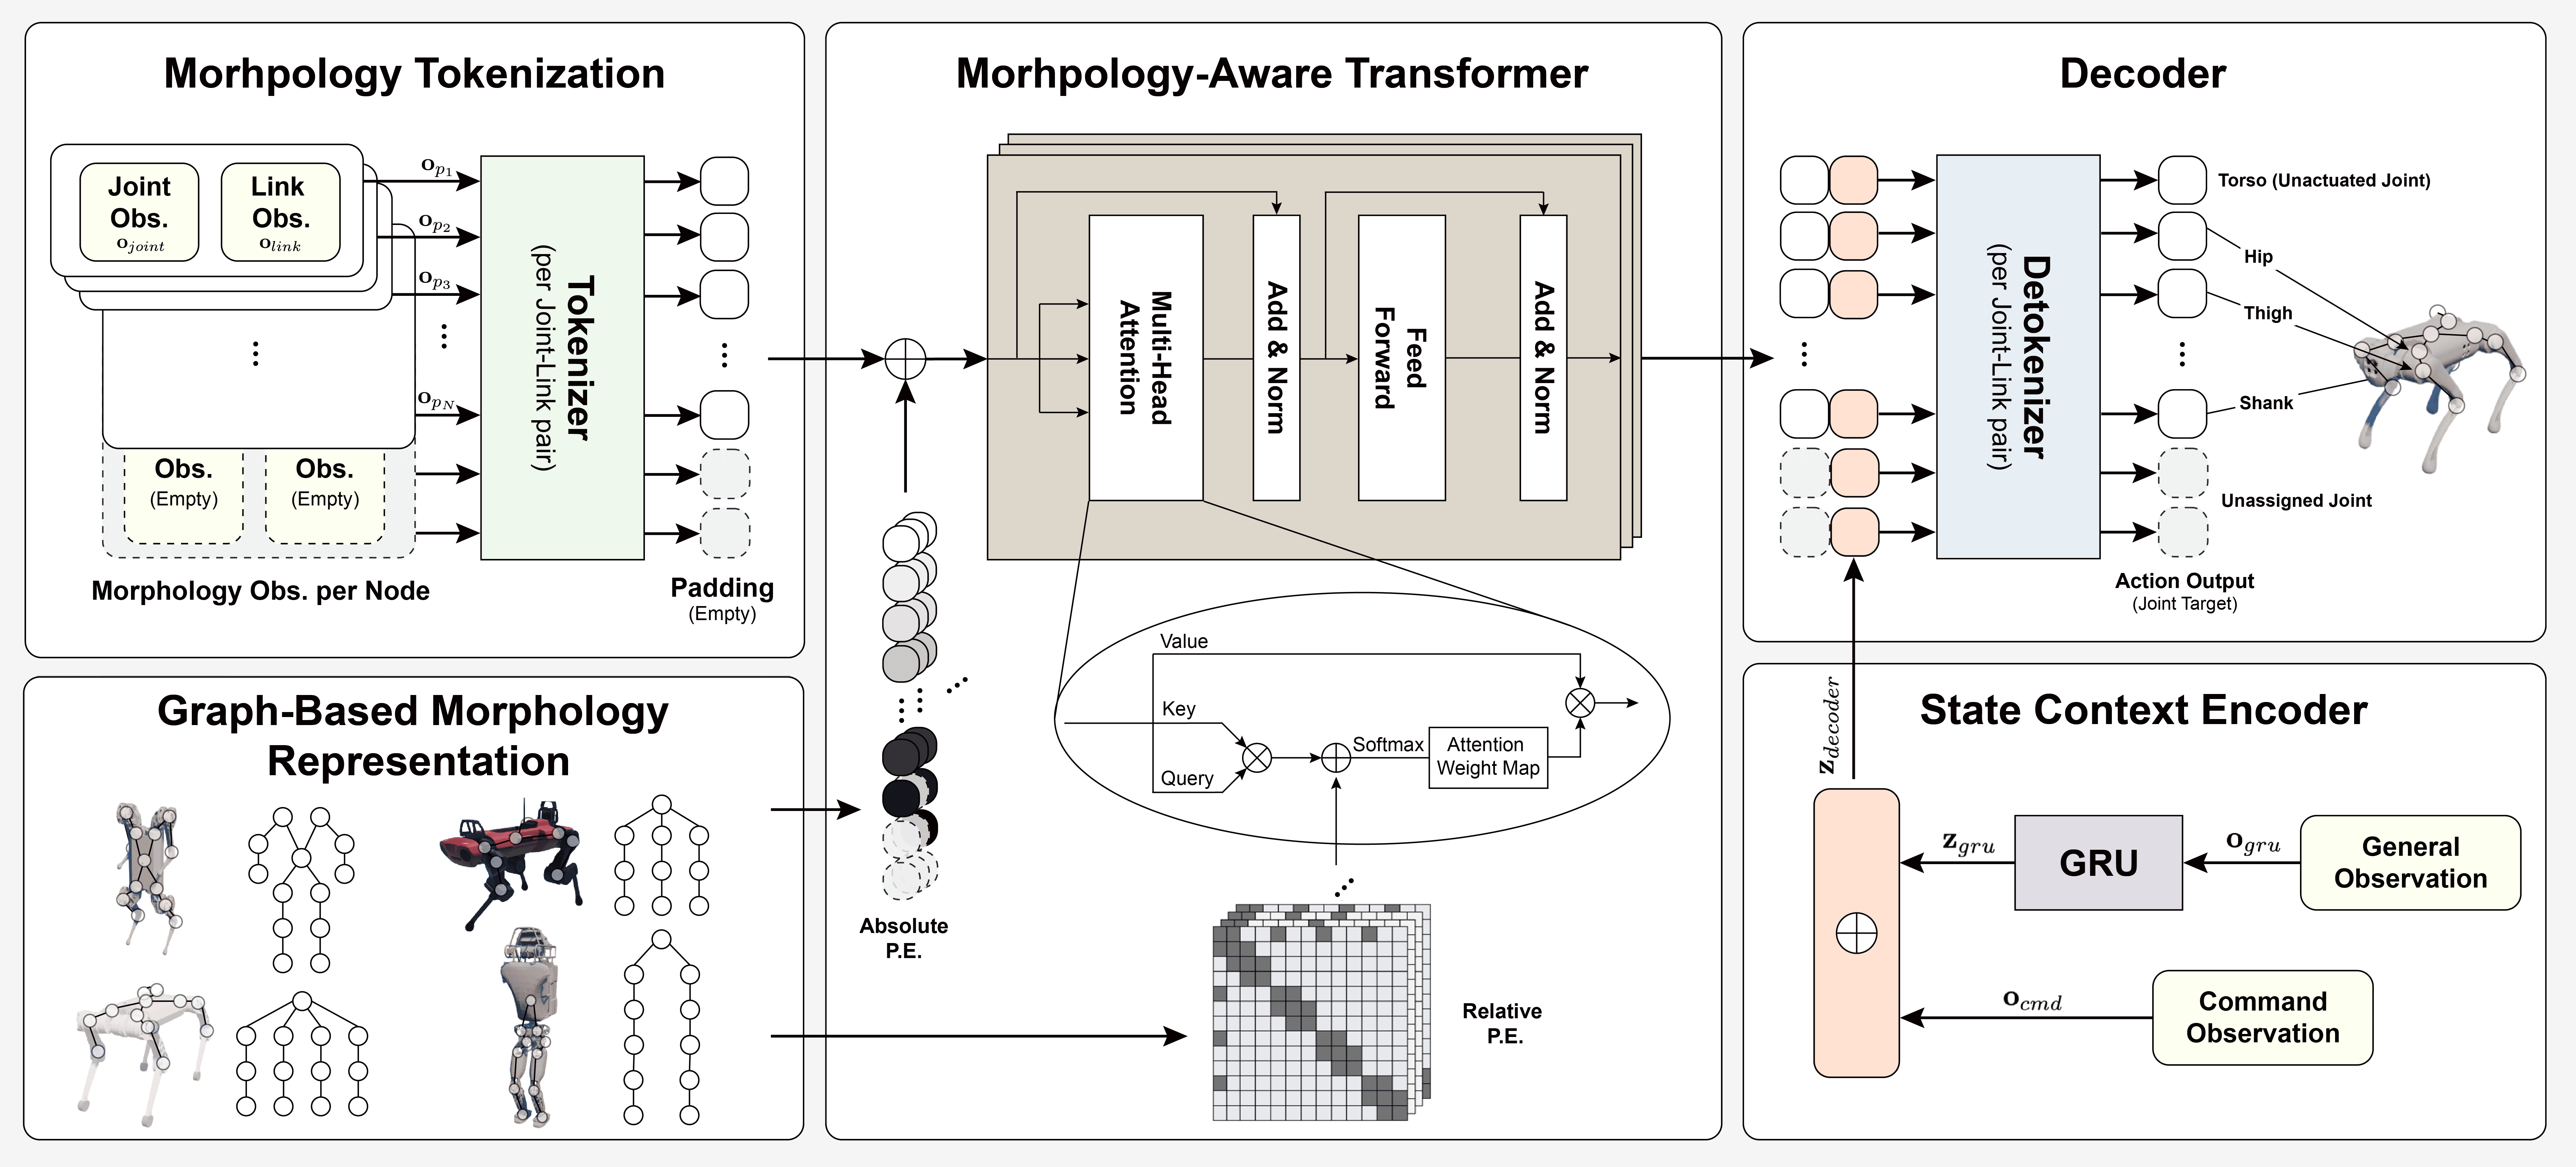
图2左侧每个节点携带质量、惯量、质心、名义关节角及状态历史等信息,按运动学树顺序排列并添加绝对位置编码。不足的槽位填空并屏蔽;当前最多15个驱动关节,因此不能宣称任意自由度或节点重排不变。
- 2
让拓扑限制信息交互
图2下方图邻接关系进入注意力,非邻接位置被屏蔽;形态感知Transformer沿连接传播身体信息。共享GRU编码IMU、关节速度与历史动作等动态上下文,补充单帧形态参数无法提供的运动状态。
- 3
逐关节解码并用统一PPO训练
解码器结合节点表征、GRU状态与速度命令,输出目标关节角交给PD控制。训练采用带特权地形及速度信息的非对称critic,部署actor只依赖本体感觉;按关节数、腿数归一化奖励,并混合均匀采样与低奖励机器人优先采样。
- 4
用惯量启发式设置控制增益
由名义质量矩阵估计各机器人PD增益,随机化质量、摩擦、时延、增益和外扰。在350个RaiSim环境训练20000轮、3种子,约2.7天/RTX4090;0.33M参数actor以100Hz运行,报告ONNX推理约0.366ms,不包括完整控制链延迟。
实验与证据
已阅读全部公开正文(未附独立附录),核对实验条件与原图;未独立复现。
来源证据关节数与奖励相关性由未归一化的0.904降为0.256;所报终止率由1.556%降至0.030%。 奖励消融与训练平衡 ↗
我的解读我的解读:统一奖励可减少身体规模带来的优化偏置,但该相关性不是跨所有本体泛化的充分条件。
来源证据50米路线包含平地、坡道、台阶和粗糙地面;四足20/20、三足20/20,Raibo2双足9/10、未见Raibo1三足7/10,无跌倒、急停或人工介入才算成功。 真实Raibo路线与退化腿配置 ↗
我的解读我的解读:真实失败仍包括脚被枝条卡住与双足失衡。锁死但仍附着的腿保留了质量,不等于真实断腿或任意故障。
来源证据70kg B2、2.5kg Solo12等未见机型测试是仿真;实机仅Raibo系列。部分速度追踪列并非最优,例如Anymal的对比方法平移误差0.107、本文0.160。 未见机器人与对比边界 ↗
我的解读我的解读:多本体的平均稳健性与某机型最精确追踪应分开;不同表的命令及评测设置也不能混用。
开放情况与使用许可
全文公开;本次未找到能从论文核实的官方实现、策略权重或相应使用许可,保持待核实。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:显式拓扑、动态记忆与奖励尺度统一共同解决跨本体训练问题,工程路径比仅扩大平铺观测向量更清楚。
反方 · 哪些结论还不够
15关节上限、固定排序和有限本体覆盖约束外推;增益是经验公式而非稳定性证明,真实硬件种类明显少于仿真。
综合判断
适合检验同类腿式平台共享策略与有限故障适应,尚不足以称为通用跨人形和任意机器人控制器。
我会先做的验证
未执行的验证方案:固定训练预算留出完整机器人家族,在未见负载、时延和关节锁止下与独立策略比较,记录跌倒、人工接管、能耗及逐机型误差。